※本記事は継続的に最新情報へアップデートしています。
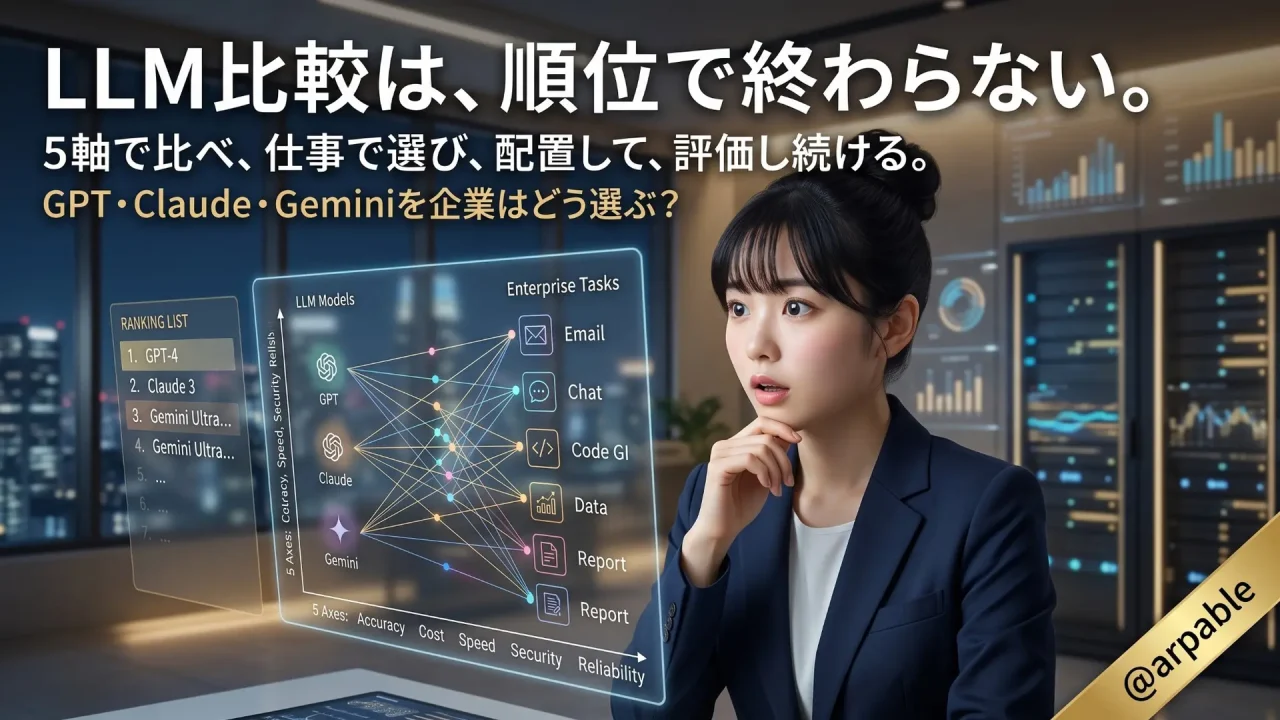
LLM比較は終わっていない。変わったのは、比べる「物差し」である。
公開ベンチマークで1位のモデルが、自社の仕事でも最適とは限らない。性能が高くても、遅すぎる、高すぎる、機密データを扱えない、モデル更新で挙動が変わる──企業のLLM選定では、こうした現実まで含めて判断する必要がある。
こんな場面を想像してほしい。導入時には高評価だったAIが、数か月後のモデル更新や価格改定を境に、「以前より遅い」「修正が増えた」「思ったほど安くない」と現場から言われ始める。しかし、導入時の評価結果はどこにも残っていない。
2026年の企業に必要なのは、同じ条件でLLMを比較し、自社タスクで選び、適切な業務へ配置し、変化するたびに評価し直す仕組みである。
✅ 先に結論
- 企業のLLM比較は「品質・コスト・レイテンシ・データ管理・運用」の5軸で行います。
ベンチマーク順位だけでは、自社業務に本当に適したモデルかどうかは判断できません。 - 候補モデルは、自社の代表タスクで評価します。
公開ランキングは候補選び、自社Evalsは採用判断というように役割を分けます。 - LLM選定は、採用して終わりではありません。
比較 → 選定 → 業務配置 → 継続評価の4ステップを回し、モデルや業務が変わるたびに再評価します。
GPT、Claude、Gemini、Grok、DeepSeekなどの最新モデル名・API価格・コンテキスト長・提供状況・公式ベンチマークは、最新LLMモデル比較【2026年10月】で確認できます。
本記事では、その比較結果を自社の採用判断と継続運用へどう結び付けるかを整理します。
企業のLLM比較は「5つの軸」で考える
企業では性能順位だけでなく、品質・コスト・レイテンシ・データ管理・運用の5軸を同じ物差しで比較します。
「LLM 比較」と検索すると、多くの比較表にはベンチマークスコア、API料金、コンテキスト長などが並びます。もちろん、これらは重要です。しかし企業導入では、公開ベンチマークで数ポイント上回ることよりも、「顧客から問い合わせが来たときに許容時間内で返せるか」「契約書の重要条項を見落とさないか」「機密情報をどこまで入力できるか」といった条件の方が、実際の成否を大きく左右します。
LLMを選ぶ作業は、最速の車を1台決めることではありません。営業、配送、長距離輸送で必要な車が違うように、企業AIでも仕事ごとに求める品質、速度、機密性、運用条件は異なります。まず仕事を定義し、その仕事に必要な能力をモデルへ求めるという順番が重要です。
| 評価軸 | 確認する内容 | 企業での問い |
|---|---|---|
| 品質(Quality) | 正確性、指示遵守、推論、文章品質、ツール利用 | この仕事を安心して任せられるか |
| コスト(Cost) | 入力・出力単価、推論量、キャッシュ、運用費 | 利用量が10倍になっても続けられるか |
| レイテンシ(Latency) | 応答速度、TTFT(最初の出力が始まるまでの時間)、P95/P99 | 現場が待てる速度か |
| データ管理(Data) | 学習利用、保持期間、リージョン、閉域、権限 | この情報を入力してよいか |
| 運用・供給(Operations) | API、モデル更新、廃止、切替、企業向けサポート | モデルが変わっても業務を続けられるか |
| ※Arpable編集部作成。評価項目の重みは、業務内容・処理量・失敗時の影響に応じて変えてください。 | ||

Microsoft Foundryでは、モデルを品質、安全性、コスト、スループット、レイテンシなど複数の指標から比較できるモデルリーダーボードが提供されています。なお、2026年10月1日時点でこのリーダーボードは公式ドキュメント上ではPreview機能です。公開ベンチマークは候補を絞る材料になりますが、自社データ上の性能まで保証するものではありません。Microsoft Foundryのモデルベンチマークも確認してください。
「一番点数が高いモデル」を探すのではなく、自社が必要とする条件を先に決め、その条件を満たすモデルを探す。これが企業向けLLM比較の出発点です。
ただし、物差しを5本そろえても、まだ半分です。測った結果を、誰が、どの仕事に、いつまで使うのか。そこが決まっていなければ、比較表は一度きりの資料で終わってしまいます。
GPT・Claude・Geminiなど主要LLMを企業視点で比較する
主要LLMは固定的な順位ではなく、企業が必要とする役割と提供条件から比較します。
2026年のLLM市場は、OpenAI、Anthropic、Googleだけで説明できる状況ではありません。xAI、DeepSeek、Qwen、Mistral、Metaなども存在し、公開ウェイトモデルやローカル実行という選択肢も広がっています。
一方、モデルの更新速度は非常に速く、「今月の最上位モデル」が半年後にも同じ位置にいるとは限りません。そこで本記事では最新モデルの細かなランキングではなく、企業が比較するときに確認すべき役割を整理します。
| 系統 | 企業利用で確認するポイント | 主な確認事項 |
|---|---|---|
| OpenAI / GPT系 | 汎用業務、推論、コーディング、Agent活用 | Evaluation best practices、Data controls、推論設定、API条件 |
| Anthropic / Claude系 | 長文知識業務、コーディング、Agent活用 | 成功基準と評価設計、モデル選択、速度、コスト |
| Google / Gemini系 | マルチモーダル、Google Cloud・Workspaceとの接続 | Gen AI Evaluation、提供環境、データ条件、Google製品統合 |
| xAI / Grok系 | API利用、長文・推論・リアルタイム系業務 | 提供範囲、価格、API条件、企業利用条件 |
| Open Weight系 公開ウェイトモデル |
自社運用、カスタマイズ、大量処理 | ライセンス、GPU、運用体制、総保有コスト |
| Local / Sovereign 閉域・データ主権を重視する構成 |
閉域、機密情報、国内制度・データ主権 | 性能だけでなく監査、統制、データ所在、運用責任 |
| ※最新モデル名、価格、コンテキスト長、提供状況は変動が速いため、詳細は最新LLM比較記事で更新しています。 | ||
ここで避けたいのは、「GPTは文章向け」「Claudeは長文向け」「Geminiはマルチモーダル向け」と固定化することです。モデル世代が変われば、得意分野、価格、速度、提供条件も変わります。
例えばOpenAIも、公式のModel Selectionで、品質だけでなく利用頻度、速度、コスト、出力の用途を考え、同じ入力で複数モデルや推論設定を試すことを勧めています。OpenAI Model Selectionを参照してください。
Anthropicも、モデル選択では能力、速度、コストを比較し、実際のプロンプトとデータでテストすることを案内しています。Anthropic Choosing the right modelを参照してください。
企業にとって本当に価値があるのは、半年ごとに比較表をゼロから作り直すことではありません。モデルが入れ替わっても、同じ判断基準で評価できる仕組みを持つことです。
なお、最新モデルの名称・価格・コンテキスト長・ベンチマークを横並びで確認したい場合は、最新LLMモデル比較【2026年10月】を参照してください。
LLM選定は「比較→選定→業務配置→継続評価」の4ステップ
LLM選定はモデルを一度決めて終わる調達ではなく、4つのステップを繰り返す運用プロセスです。
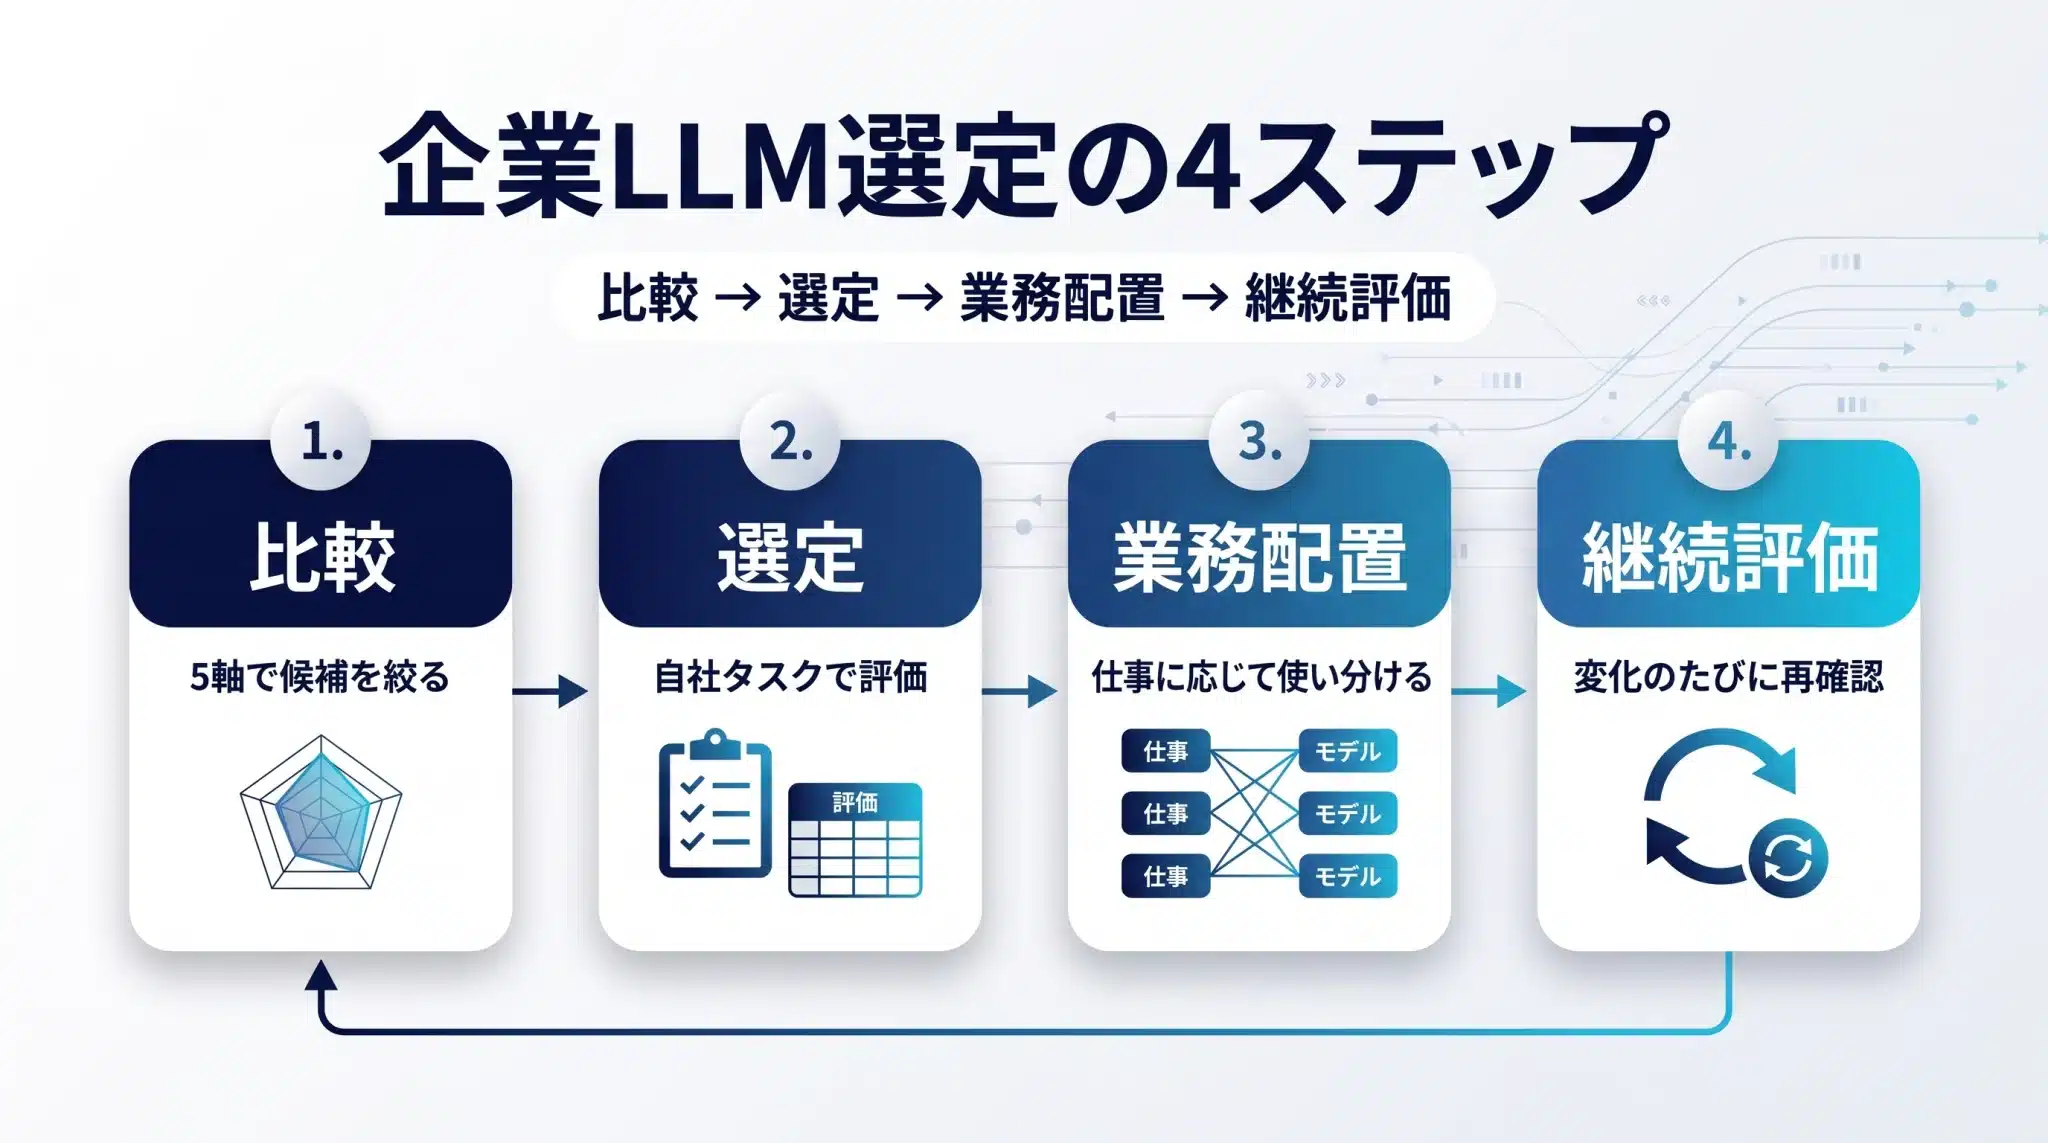
STEP1:5つの軸で候補モデルを比較する
最初に品質、コスト、レイテンシ、データ管理、運用・供給という5軸で候補を絞ります。この段階では、まだ採用モデルを決めません。
必要品質、月間処理量、許容時間、機密性、利用環境を確認し、候補を数モデルまで絞り込みます。1日に数十件しか処理しない高付加価値業務と、1日に数万件を処理する分類業務で、同じモデルを使う必然性はありません。
STEP2:自社タスクで選定する
候補が決まったら、実際の業務に近い問題を使って比較します。公開ベンチマークは候補を探すには便利ですが、「自社の契約書を正しく読めるか」「社内規程に従った回答を返せるか」までは教えてくれません。
ここで必要になるのが、自社の仕事を物差しにしてモデルを採点する仕組み、Evalsです。EvalsはAIに総合順位を付けるための仕組みではありません。自社の仕事を任せてもよいかを、同じ条件で確かめるための仕組みです。詳しくは次章で解説します。
STEP3:業務へ配置する
評価結果をもとに、どの業務でどのモデル層を使うかを決めます。高難度の判断と、大量の形式変換を同じモデルで処理する必要はありません。
また、機密情報を外部APIへ送れない場合は、性能比較以前にローカルLLMや閉域環境が候補になります。モデルを選ぶのではなく、仕事にモデルを配置するという発想が重要です。
STEP4:継続評価する
モデルを採用して終わりではありません。モデルバージョン、プロンプト、価格、API仕様、自社業務のどれかが変われば、以前の評価結果がそのまま使えなくなる可能性があります。
LLM選定は製品を買う仕事ではなく、品質管理の仕組みをつくる仕事です。
LLMの性能比較は公開ベンチマークだけでなく「自社タスク」で行う
Evalsの目的はAIに総合点を付けることではなく、「この仕事を任せられるか」を再現可能な方法で確認することです。
企業向けLLM選定で重要になっている考え方の一つがEvalsです。Evalsとは、モデルやAIシステムの出力を、あらかじめ定めた成功条件に基づいて評価する仕組みです。
OpenAIはEvaluation Best Practicesで、実際のタスクに沿った評価を作り、変更後も繰り返し評価することを推奨しています。OpenAI Evaluation Best Practicesを参照してください。
Anthropicも、LLMアプリケーションの評価では最初に成功基準を明確にし、それを測るための評価を設計するという順序を示しています。さらに、実際のタスク分布やエッジケースを評価に反映することを勧めています。Anthropicの評価設計ガイドを参照してください。
Google Cloud、Amazon Bedrock、Microsoft Foundryにも、独自データや独自の評価基準を使って候補モデルを比較する仕組みがあります。主要ベンダーの方向性を一言でまとめれば、「公開スコアだけを見るのではなく、自分の仕事で確かめる」です。
評価セットは「実際に起きる仕事」から作る
例えば議事録要約なら、「文章がきれいか」だけを評価しても十分ではありません。
実務で確認したいのは、決定事項を落としていないか、担当者を取り違えていないか、存在しない期限を勝手に作っていないか、といった項目です。
契約書レビューなら「説明が読みやすいか」より、「重大な条項や例外条件を見落としていないか」の方が重くなります。顧客問い合わせなら、自然な文章に加えて「社内規程にない約束をしていないか」を見る必要があります。
評価基準は、モデルではなく業務から作ります。
典型ケースだけでなく、失敗しやすいケースを含める
簡単なケースだけで評価すると、本番で必要な安全性を過大評価する可能性があります。通常ケースに加え、情報不足、曖昧な依頼、矛盾した文書、長い入力、過去にAIが間違えたケースなども評価セットへ加えます。
本番で新しい失敗が見つかった場合は、そのケースを次の評価セットへ追加します。こうして評価セットそのものを運用しながら育てていきます。
「平均点」だけで判断しない
モデルAは品質が高いが遅い。モデルBは品質がわずかに低いものの、速くて安い。モデルCは通常業務では十分だが、高リスクケースで重大エラーが増える。こうした違いを1つの平均点にまとめると、企業にとって重要な情報が消えてしまいます。
実務では少なくとも、品質、重大エラー、コスト、レイテンシを分けて見た方がよいでしょう。
| 項目 | 評価内容の例 |
|---|---|
| 対象業務 | 議事録、契約レビュー、社内QA、顧客対応、コーディングなど |
| 成功基準 | 必須情報を網羅、重大誤りなし、規定フォーマットを遵守 |
| 評価データ | 代表ケース、難しいケース、境界ケース、過去の失敗例 |
| 品質指標 | 正確性、指示遵守、根拠、重大エラー |
| 運用指標 | 1件当たりコスト、TTFT、P95レイテンシ、処理時間 |
| 最終判断 | 自動評価に加え、高リスク業務では人間レビューを併用 |
| ※万能な評価件数はありません。本番業務の代表ケースと、絶対に見落としたくない失敗ケースを含めることを優先してください。 | |
Microsoft Foundryでは、レイテンシを平均値だけではなくP50、P90、P95、P99などで確認できます。平均3秒でも、一部の処理が30秒かかるなら、リアルタイムの顧客対応では問題になります。
つまり企業のEvalsでは、AI単体の「賢さ」だけでなく、実際に仕事を完了させるまでの品質・時間・コストを見る必要があります。
評価によって「この仕事を任せられるか」が見えたら、次は「その仕事をどこへ置くか」です。すべての業務を同じモデルで処理する必要はありません。
配置先になる4つの実務レイヤー
STEP3の業務配置では、モデルを4つの実務レイヤーとして見ると「どこへ何を置くか」を整理しやすくなります。
ここで紹介する4つは、きれいに切り分けられたモデルの分類ではありません。例えば、閉鎖フロンティアモデルが高度な推論機能を持つことがありますし、公開ウェイトモデルをローカル環境で動かすこともあります。
したがって、本記事ではモデル図鑑としてではなく、企業が「どこへ何を置くか」を考えるための実務レイヤーとして整理します。
閉鎖フロンティアレイヤー
OpenAI、Anthropic、Googleなどが提供する高性能な商用モデル群です。高品質な文章生成、複雑な分析、コーディング、ツール利用、Agent型業務などで有力な候補になります。
一方、価格、提供条件、モデル更新はベンダー側の影響を受けます。すべての業務を1社・1モデルへ固定すると、価格改定やモデル廃止の影響を受けやすくなります。
推論・判断レイヤー
以前は「推論モデル」を独立したモデル種類として説明しやすい時代がありました。しかし現在は推論(Reasoning)能力が多くのモデルへ統合され、同じモデルでも推論量の設定によって「どこまで深く考えさせるか」を変更できるケースがあります。
そこで本記事では、推論をモデル名ではなく、「深く考えさせる必要がある仕事を処理する実行レイヤー」として捉えます。
重要な契約判断、複雑な設計、難しいコード修正などでは価値があります。一方、単純な分類や形式変換まで毎回深く考えさせれば、コストとレイテンシが増える可能性があります。
Open Weightレイヤー
DeepSeek、Qwen、Llama、Mistralなど、モデルの学習済み重みを利用できる選択肢です。自社環境への導入、用途特化、大量処理、モデル運用の自由度などで検討対象になります。
ただし「API利用料がない=安い」とは限りません。GPU、推論サーバー、監視、セキュリティ、モデル更新、障害対応、ライセンス確認まで含めた総保有コスト(TCO)で比較する必要があります。
公開ウェイトモデルを業務で利用する際の商用利用条件やライセンス確認については、ローカルLLM商用利用チェックリストで詳しく解説しています。
Local / Sovereignレイヤー
外部APIへ送信できない情報や、データ所在、監査、国内制度が重要になる業務で候補になります。
ここでは性能順位よりも、「誰がデータを保持するのか」「どこで処理されるのか」「誰が監査できるのか」が重要になります。
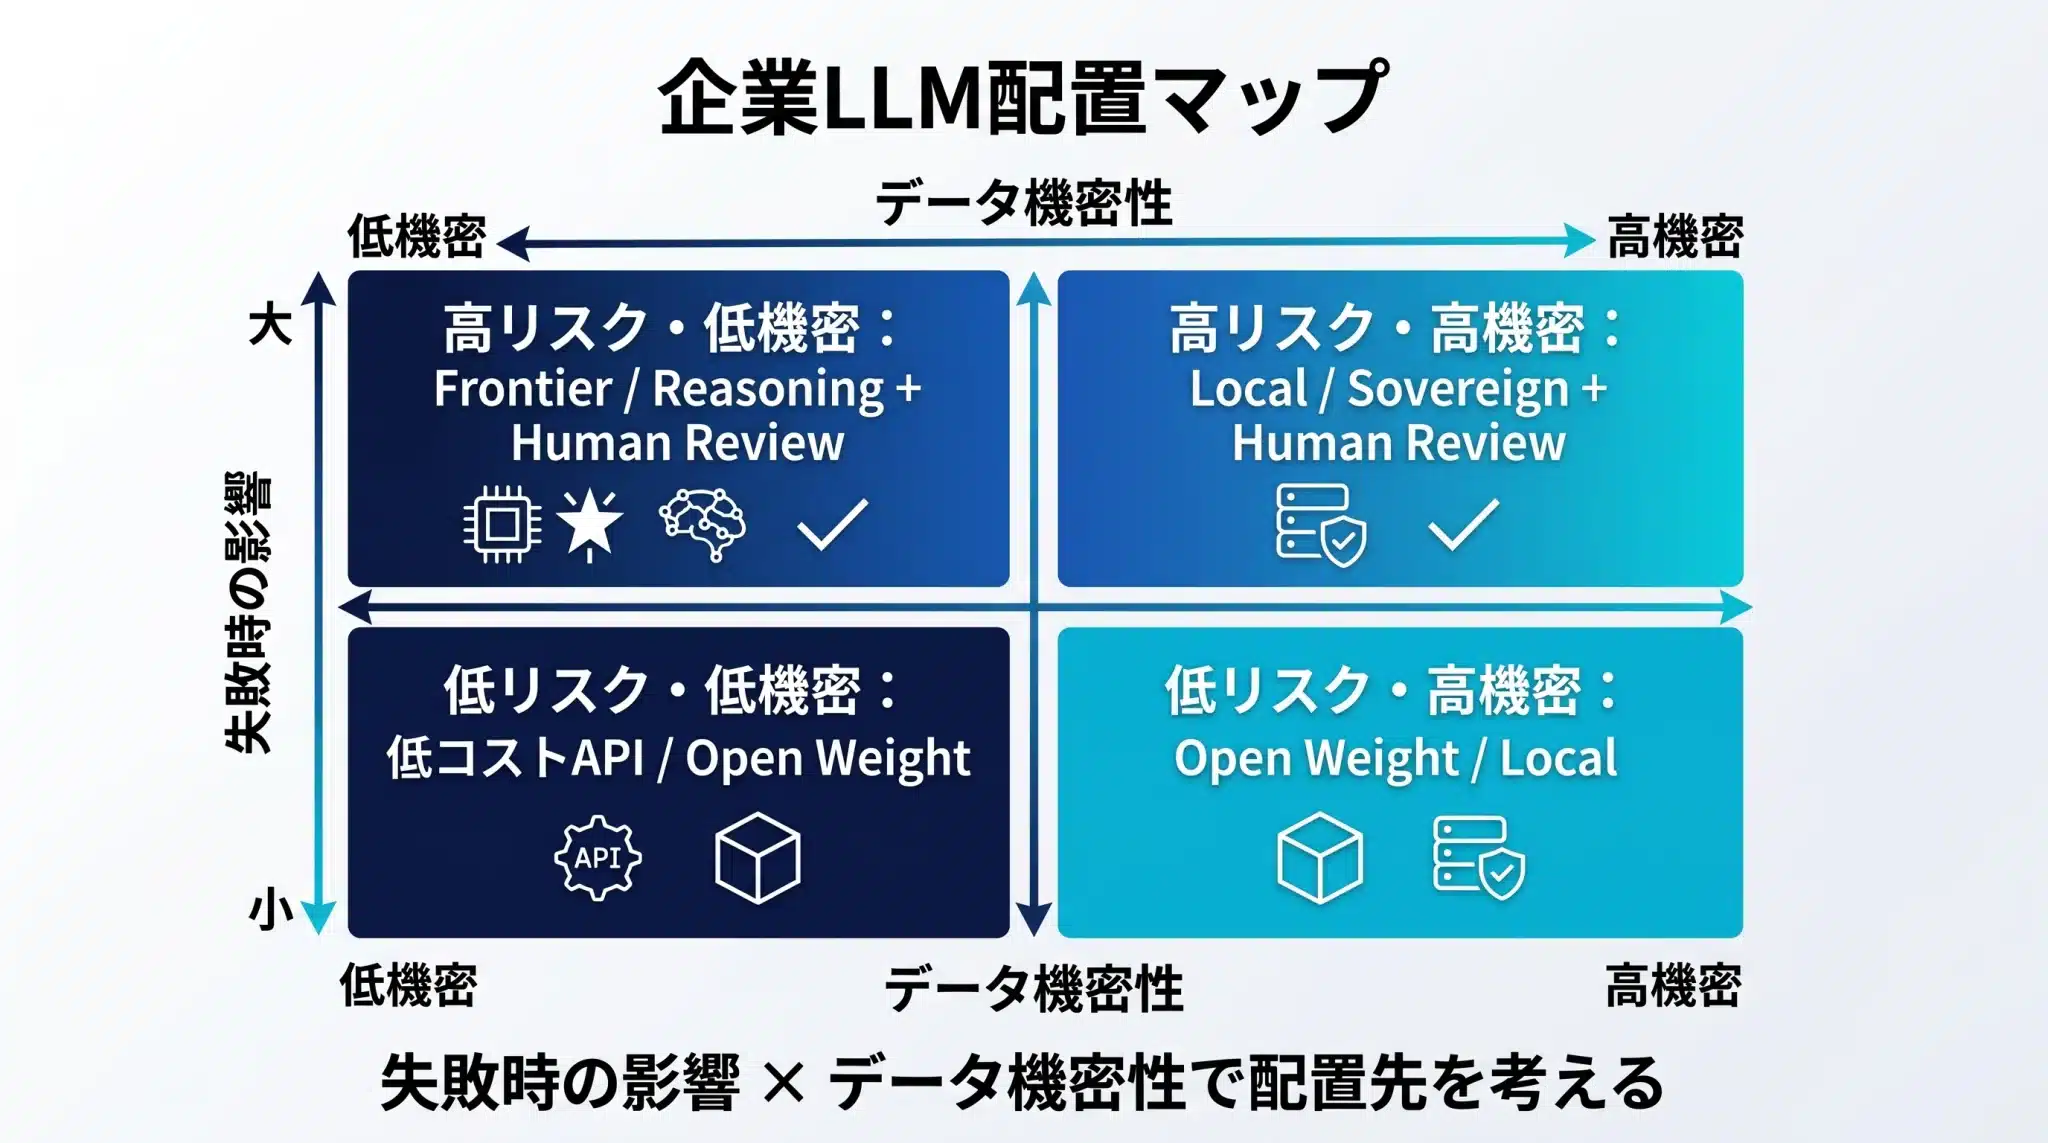
業務別にLLMをどう使い分け・配置するか
モデル名から仕事を決めるのではなく、業務の難度・失敗リスク・機密性・処理量から候補モデル層を逆算します。
例えば、役員会向けの重要資料と、数万件の問い合わせ分類では求めるものが違います。前者では品質や推論能力が重要になりますが、後者では一定品質を維持しながら処理単価と速度を抑えることが重要になります。
| 業務 | 主に見る条件 | 候補となるレイヤー | 人間確認 |
|---|---|---|---|
| 高品質文書作成 | 品質、指示遵守 | Frontier | 重要文書は必要 |
| 調査・分析 | 推論、根拠、長文処理 | Frontier / Reasoning | 結論・根拠を確認 |
| コーディング | 正確性、ツール利用、リポジトリ理解 | Frontier / Reasoning | レビュー・テスト必須 |
| 契約・法務補助 | 重大見落とし、根拠 | Reasoning+Human | 原則必要 |
| 大量分類・抽出 | コスト、速度、一定品質 | 低コストAPI / Open Weight | サンプリング確認 |
| 機密文書 | データ条件、閉域性 | Local / Sovereign | 社内規程に従う |
| 長時間Agent業務 | 完遂力、ツール利用、障害復旧 | Frontier系 | チェックポイント設計 |
| ※モデル配置は一例です。「大量処理だから必ず小型モデル」と固定せず、自社Evalsと総保有コストを含めて最終判断してください。 | |||
例えば高価なモデルでも、キャッシュやバッチ処理を使えばコストが下がる場合があります。一方、公開ウェイトモデルでも自社GPUの稼働率が低ければ、運用人件費まで含むTCOは高くなる可能性があります。
この表は「答え」ではなく、候補を絞るための地図です。小型モデルに任せられる仕事の見極め方や、業務1件あたりの原価の考え方については、SLMとは?LLMとの違いと使い分けで詳しく解説しています。
コスト・レイテンシ・データ管理は「仕様表の数字」だけを見ない
本番では公称API価格や平均速度ではなく、「1件の仕事を完了させる総コスト」と遅いケースまで確認します。
配置の地図ができたら、次はその判断が実際の数字の上でも成立するかを確かめます。
API単価と「1件の業務コスト」は違う
100万トークン当たりのAPI価格は比較しやすい数字ですが、実際の業務コストは入力長、出力長、推論トークン、キャッシュ、バッチ処理、ツール呼び出し、再試行などで変化します。
そこで「100万トークンでいくらか」だけを見るのではなく、「この業務を1件終えるのにいくらかかるか」に置き換えると、判断しやすくなります。
平均速度ではなくP95も見る
平均応答時間が2秒でも、一部のリクエストが20秒以上かかるなら、顧客対応やリアルタイム業務では問題になります。
P95とは「95%の処理がこの時間以内に完了する」という指標です。平均値だけでは見えない遅いケースを把握できます。重要業務ではP95やP99も確認し、実際の利用者が経験する待ち時間を評価します。
「学習に使われない」と「保存されない」は違う
データ管理では言葉を正確に分ける必要があります。
「入力データをモデル学習に利用しない」ことと、「入力・出力を保存しない」ことは同じ条件ではありません。例えばOpenAI APIでは、APIデータは既定でモデル学習に利用されませんが、標準の不正利用監視ログや各エンドポイントのアプリケーション状態には、それぞれ異なる保持条件があります。対象組織にはZero Data Retentionなどの制御もあります。OpenAI Data controlsのように、実際に使う機能単位で確認してください。
特に機密情報では、サービス名だけで判断せず、実際に利用するAPI、契約プラン、機能、処理リージョンごとに条件を確認する必要があります。
モデルは採用後も「継続評価」する
LLMは導入時に合格しても、モデル・価格・プロンプト・業務が変われば再評価が必要です。
従来のソフトウェア部品以上に、LLMは変化します。モデルが更新され、APIが変わり、価格が変わります。そして自社の業務そのものも変わります。
OpenAIは評価を早期かつ継続的に行う考え方を示し、Anthropicも成功基準に対して反復的に評価する設計を推奨しています。モデルを変えるたびに評価の物差しまで作り直すのではなく、同じ評価セットで比較できる状態を維持します。
再評価するタイミング
- モデルまたはAPIの変更
- プロンプトの変更
- RAGや検索方式の変更
- ツール・Agent構成の変更
- 料金改定
- 業務プロセスの変更
- 新しい失敗パターンの発見
本番で新しい失敗が見つかったら、そのケースを評価セットへ追加します。評価セットは固定された試験問題ではなく、企業がAI利用から学んだ失敗知識を蓄積する資産になっていきます。
健康診断が、去年の自分の数値と比べて初めて変化に気づけるのと同じです。過去の評価結果が残っているからこそ、新しいモデルへ替えたときの「違い」を具体的に確認できます。
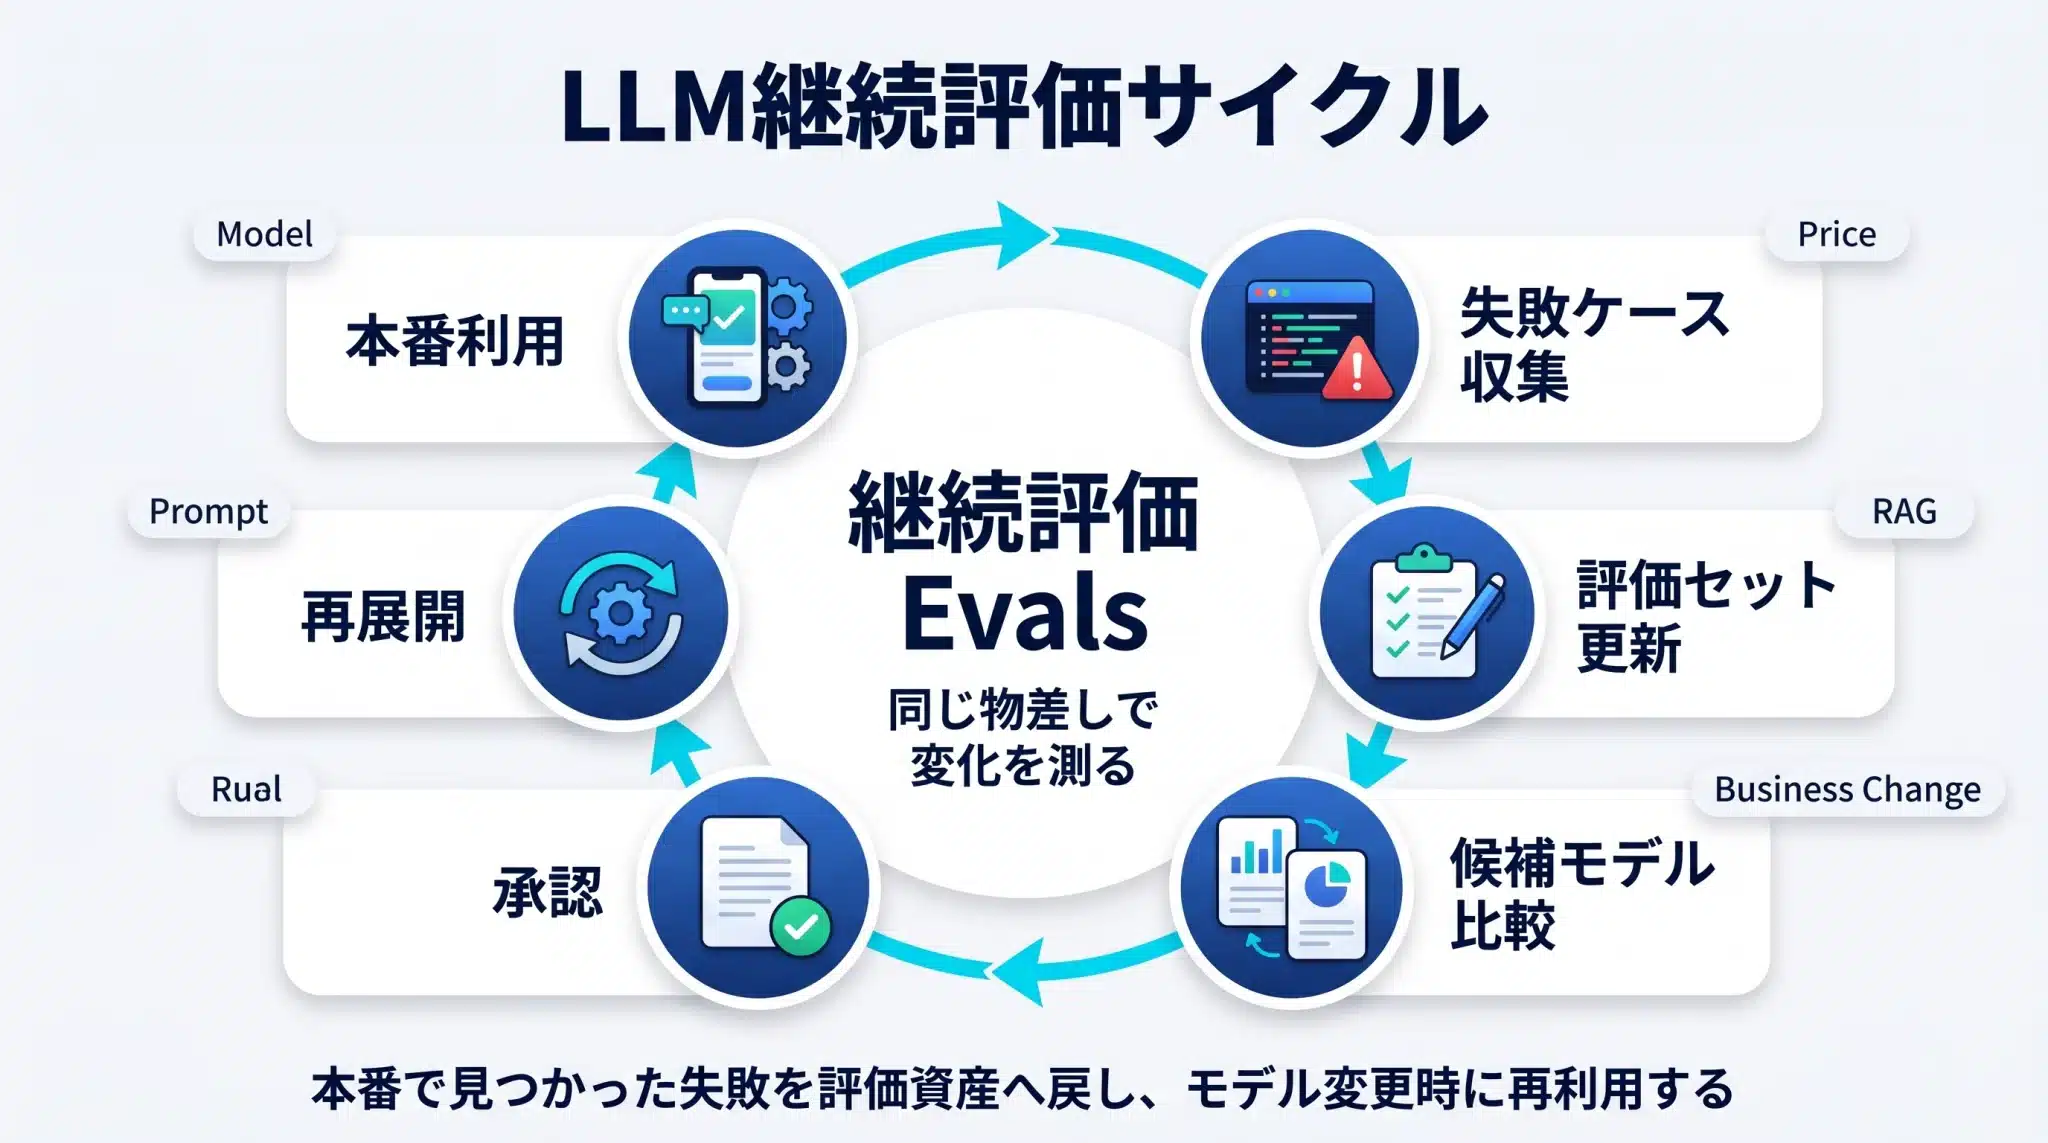
これは従来システムの回帰テストに近い考え方です。ただしLLMでは同じ入力でも完全に同じ文字列が返るとは限らないため、「文字列一致」だけではなく、品質基準や重大エラーの有無で評価します。
モデル選定で最も価値がある資産は、特定モデルの比較表ではなく、自社が持つ評価セットそのものです。
日本企業で重要性を増すソブリンAIという選定条件
日本企業では性能・価格だけでなく、データ所在、制度、監査、説明責任が選定条件になる業務があります。
継続評価の仕組みと並んで、日本企業にはもう一つ、性能比較だけでは見えにくい条件があります。データを「どこで、誰の責任で扱うか」です。
行政、金融、医療、製造、知的財産、M&Aなどでは、世界最高レベルの公開ベンチマークだけでは判断できません。そのため、国産LLM、国内クラウド、閉域環境、ソブリンAIという選択肢も、モデルポートフォリオの一部として考える必要があります。
デジタル庁は2026年6月12日、政府向けの「行政の進化と革新のための生成AIの調達・利活用に係るガイドライン(第2.0版)」を決定・公表しました。生成AI技術の進展、ユースケースの拡大、国内外の制度・政策動向を踏まえて、2025年版を改定したものです。デジタル庁の公式発表を参照してください。
これは民間企業へ直接適用されるルールではありませんが、生成AIの調達を性能だけでなく、ガバナンス、データ管理、責任体制まで含めて設計する考え方を読む材料になります。
企業にとってのソブリンAIは、「日本製だから選ぶ」という話ではありません。外部へ出せない仕事を、どこで、誰の責任でAI化するのかという設計問題です。
企業がLLM選定で避けるべき4つの失敗
LLM導入の失敗は性能不足よりも、比較条件・データ条件・再評価方法を決めないまま導入することで起きます。
失敗1:ベンチマーク1位をそのまま採用する
公開ベンチマークは有用ですが、自社業務の正解ではありません。候補モデルを絞るためには使えますが、最終判断には自社タスクによる評価が必要です。
ベンチマークは候補選び、自社Evalsは採用判断。この2段階を分けます。
失敗2:全社を1モデルへ固定する
全社標準を作ること自体は悪くありません。しかし「全社員が必ずモデルAを利用する」という固定と、「企業として標準環境を定める」ことは別です。
全社で揃えるのは、評価基準、データの扱い、承認の流れ、モデル変更の手順です。ここが揃っていれば、モデルは後から入れ替えられます。
失敗3:機密性を導入後に考える
AIを便利に使い始めてから、「この資料は入力してよかったのか」と考えるのは順序が逆です。
最初にデータを、外部APIへ送れる情報、契約条件付きで送れる情報、外部へ送れない情報へ分類します。この分類によって、候補モデルそのものが変わります。
失敗4:一度選んだモデルを再評価しない
LLM市場ではモデルの世代交代が速く、提供条件も変わります。一方で、新モデルが出るたびに乗り換える必要もありません。
新しいモデルが登場しても、比較表をゼロから作る必要はありません。自社の評価セットをもう一度走らせられることが大切です。
まとめ:LLM比較の目的は「最強モデル」を探すことではない
企業のLLM比較は、自社業務に最適なAI配置を継続的に設計するための工程です。
2026年のLLM市場では、新しいモデルが次々と登場します。しかし、そのたびに「GPTが1位か、Claudeか、Geminiか」と議論をやり直していては、企業のAI基盤は安定しません。 必要なのは、モデルが変わっても使える判断の物差しです。
本記事では、それを品質、コスト、レイテンシ、データ管理、運用・供給の5軸に整理しました。そして企業のモデル選定を、比較 → 選定 → 業務配置 → 継続評価の4ステップとして整理しました。
公開ベンチマークで候補を見つける。自社の仕事で確かめる。仕事の性質に応じてモデルを配置する。モデルや業務が変われば、もう一度評価する。
この仕組みを持っていれば、次のGPT、Claude、Geminiが登場しても、企業はゼロから比較をやり直す必要がありません。
比較は入口、配置が設計、Evalsが運用です。
本当に問うべきなのは、「一番強いLLMはどれか」ではありません。
「自社のどの仕事を、どのAIに、どこまで任せるのか」です。
最初の一歩は難しくありません。まず代表業務を1つ選び、品質・コスト・レイテンシ・データ管理・運用の5軸で、現在の候補モデルを比べてみてください。
専門用語まとめ
企業のLLM比較と選定で頻出する用語を簡潔に整理します。
- LLM(Large Language Model)
- 大量のテキスト等を学習し、文章生成、要約、推論、コーディングなどを行う大規模言語モデルです。
- Evals
- モデルやAIシステムが要求された品質を満たしているかを、定義したデータと評価基準で確認する仕組みです。
- Open Weight
- 学習済みモデルの重みを利用できるモデルです。商用利用や再配布などの条件は、それぞれのライセンスを確認する必要があります。
- P95レイテンシ
- 全リクエストの95%が完了するまでに要する時間です。平均値では見えにくい遅いケースを確認するために使います。
- ソブリンAI
- 国や地域のデータ主権、言語、制度、インフラなどを考慮して構築・運用するAIの考え方です。
参考文献 / 出典
本記事では、各AI企業・クラウド事業者・日本政府の一次情報を中心に参照しています。
- OpenAI|Evaluation best practices
- OpenAI|Model selection
- OpenAI|Practical Guide for Model Selection for Real-World Use Cases
- OpenAI|Data controls in the OpenAI platform
- Anthropic|Define success criteria and build evaluations
- Anthropic|Choosing the right model
- Google Cloud|Gen AI evaluation service overview
- AWS|Amazon Bedrock model evaluation
- AWS|Data protection in Amazon Bedrock
- Microsoft|Model benchmarks and leaderboards in Microsoft Foundry
- Microsoft|Compare models using the model leaderboard
- Microsoft|Model retirement schedule
- デジタル庁|行政の進化と革新のための生成AIの調達・利活用に係るガイドライン(第2.0版)
次に読むならこの4本
最新モデル、SLM、主要AIの使い分け、ローカルLLMをさらに深掘りできます。
補足Q&A
LLM比較・選定で特に迷いやすい6つの疑問へ簡潔に答えます。
Q1.
GPT・Claude・Geminiでは、結局どれが一番優秀ですか?
A1.
用途によって変わるため、企業利用では1つの総合順位だけで決めるべきではありません。
コーディング、文書作成、推論、マルチモーダル、コスト、速度など、仕事によって重視する評価軸は異なります。最新モデルそのものの比較は最新LLMモデル比較で確認し、自社導入では代表タスクによる評価を行うのが現実的です。
Q2.
公開ベンチマークだけでLLMを選べますか?
A2.
候補の絞り込みには使えますが、最終判断には自社タスクによる評価が必要です。
公開ベンチマークはデータや評価条件が自社業務とは異なります。主要クラウドやモデルベンダーも、独自データや自社基準を使った評価方法を提供しています。
Q3.
Evalsは何件くらい用意すればよいですか?
A3.
万能な件数はありません。まず主要業務の代表ケースから始めるのが現実的です。
件数そのものより、本番で実際に起きるケースと、絶対に見落としたくない重大な失敗ケースが含まれているかを優先します。本番で新しい失敗が見つかるたびに評価セットへ加えていきます。
Q4.
全社標準のLLMは1つに絞るべきですか?
A4.
全社標準は必要ですが、標準化する対象を「1つのモデル名」にする必要はありません。
利用可能な環境、データ取り扱い、品質基準、承認ルール、モデル変更時の再評価プロセスを標準化します。その枠内で用途別に複数モデルを利用できれば、品質・コスト・供給リスクのバランスを取りやすくなります。
Q5.
機密情報をLLMに入力してよい条件は何ですか?
A5.
サービス名ではなく、実際に使うAPI・契約プラン・機能ごとのデータ条件で判断します。
確認するのは、入力データの学習利用、保持期間、Zero Data Retentionなどの保持制御、処理リージョン、権限管理です。「学習に使われない」ことと「保存されない」ことは別の条件です。
Q6.
採用したモデルが更新・廃止されたらどうすればよいですか?
A6.
旧モデルと候補モデルへ同じ評価セットを適用し、品質・コスト・レイテンシを比較します。
主要ベンダーやクラウドはモデルの更新・廃止情報を公開していますが、スケジュールは変更される場合があります。移行時には最新の公式情報を確認し、自社Evalsで回帰確認を行ってください。
更新履歴
検索意図、LLM選定手法、Evals、主要プラットフォームの変更を継続的に反映します。
- 2025年03月25日:初版公開。
- 2026年07月10日:モデルポートフォリオ設計を主題として全面改稿。
- 2026年10月01日:「LLM比較 → 選定 → 業務配置 → 継続評価」を軸に全面再構成。5軸比較、Evals、実務レイヤー、継続評価サイクルを追加。