※本記事は継続的に最新情報を反映して更新しています。
ChatGPTに質問を送った瞬間、AIはその場で「学習」しているのか。答えは、基本的にはノーだ。
学習はモデルの能力を作る工程、推論は学習済みのモデルで答えを出す工程であり、この違いは必要な計算量やチップの役割、さらには企業のお金のかかり方までを左右する。
その場で学習していないAIに、なぜ使うたびにお金がかかるのか――その答えは、モデルを作る工程とモデルを使い続ける工程とで、原価の発生の仕方が違うことにある。
学習は「能力を作り、磨くための開発・更新投資」、推論は「能力を使うほど積み上がる継続原価」と捉えると、技術と経営の違いが一本の線でつながります。
- 学習(Training):データを使ってモデルの重みを更新し、能力を作る工程。大規模な並列計算と大容量メモリが鍵
- 推論(Inference):学習済みの重みを使って答えを出す工程。レイテンシ、電力、メモリ効率、1トークン当たりのコストが鍵
- 注意点:学習は最初の一回だけではなく、新モデル開発、ポストトレーニング、Fine-tuning、強化学習(RL)などのたびに繰り返される
2026年は、モデルの性能競争だけでなく、推論の単位原価をどこまで下げられるかがAIインフラ競争の重要な軸として前面に出ています。この違いを見誤ると、「高性能なモデルを選んだのに、なぜ利用が広がるほど採算が難しくなるのか」を説明できません。
AIの「学習」と「推論」は何が違うのか
学習はAIの中身を書き換える工程、推論は学習済みの中身を使って答えを出す工程である。
 図:左は山積みの参考書で学習する学生、右はタブレットで試験を受ける学生(推論)
人間にたとえるなら、学習は「試験勉強」、推論は「本番の試験」に近い関係です。企業活動に置き換えれば、学習は製品開発、推論は完成した製品を顧客へ届け続ける運用に近いと考えると分かりやすいでしょう。
勉強中は問題を解き、間違いを確認し、次に正しく答えられるよう知識を修正します。一方、本番の試験では、その場で教科書を書き換えるのではなく、それまでに身につけた知識を使って問いに答えます。AIも基本的には同じです。
| 観点 | 学習(Training) | 推論(Inference) |
|---|---|---|
| 目的 | AIの能力を作る・改善する | 完成したAIを使う |
| モデルの重み | 更新する | 原則として固定 |
| 主な処理 | 順伝播、誤差計算、逆伝播、重み更新 | 順方向の計算が中心 |
| 重視する性能 | 大規模並列性、スループット、メモリ容量・帯域 | レイテンシ、電力、メモリ効率、単位コスト |
| 代表的なハードウェア | GPU、TPUなど | GPU、ASIC、NPU、推論アクセラレータ |
| 経営的な見方 | 主に能力を作るための費用 | 主に能力を使い続けるための費用 |
| ※Arpable編集部整理(2026年9月時点)。 | ||
ChatGPTやClaude、Geminiへ質問して返答を受け取る日常的な利用の多くは「推論」です。そのたびに基盤モデルが一から日本語やプログラミングを学び直しているわけではありません。
では、なぜAI開発には大量のGPUが必要なのでしょうか。その答えは、学習が「答えを出す」だけでは終わらないことにあります。
学習は「答えて終わり」ではなく、「答えて直す」
学習が大量の計算を必要とする理由は、答えを出した後に誤差を計算し、モデル自身を修正するからである。

ニューラルネットワークの学習では、まず入力データから予測結果を出します。次に、その結果と正解との差を測り、どこを直せば誤差を小さくできるかを計算します。
その誤差をネットワークの後ろ側からさかのぼり、それぞれの重みをどの方向へ、どの程度変えるべきかを求める処理が逆伝播(Backpropagation)です。
学習のサイクルを単純化すると、次の4段階になります。
- 答える:入力データから予測する
- 採点する:正解との差を測る
- 原因をさかのぼる:どの重みが誤差に影響したか計算する
- 書き換える:重みを更新して、次の予測を改善する
この処理を大量のデータに対して繰り返すため、学習では巨大な計算量が発生します。大規模モデルでは、この計算を多数のGPUやTPUへ分散させて処理します。
学習は「答えを出す計算」だけではなく、「モデルを書き換える計算」まで含んでいます。ここが推論との最初の大きな分かれ目です。
なぜAIの学習にはGPUが使われるのか
GPUがAI学習に強い理由は、大量の行列演算を同時並行で処理する学習ワークロードと相性がよいからである。
GPUはもともと、画像を構成する大量の画素を並列に計算するため発展してきました。この「大量の計算を同時に処理する」という性質が、ニューラルネットワークの学習とよく合います。
学習で重要なのは、一つの計算だけを世界最速で終わらせることではありません。巨大な行列演算を大量に流し続け、全体としてどれだけ多く処理できるかというスループットが重要です。

工場のラインを想像すると分かりやすいでしょう。一台を世界最速で組み立てることより、ライン全体で1時間に何台を安定して生産できるか。学習で重視されるスループットは、この総処理能力に近い考え方です。
対照的に、コンビニのレジで問われるのは、一人ひとりを待たせず素早くさばく応答の速さです。これは、後で説明する推論で重視されるレイテンシに近い考え方です。
さらに学習時には、モデルの重みだけでなく、勾配、オプティマイザの状態、逆伝播に必要な中間データなども保持します。そのため、演算性能だけでなくHBM(High Bandwidth Memory)の容量と帯域も重要になります。
GPU・FPGA・ASIC・NPUそのものの違いと役割は、GPU・FPGA・ASIC・NPUの使い分けで詳しく整理しています。
推論は「完成したAIを使う」仕事
推論では学習済みの重みを使って答えを生成するため、重み更新よりも応答速度と運用効率が重要になる。
たとえばChatGPTに「東京のおすすめ観光地を教えて」と入力すると、モデルは学習済みの重みで入力を処理し、次に続くトークンを予測しながら回答を組み立てます。そのたびに日本語を一から学び直しているわけではありません。
通常の推論では、学習時に必要だった逆伝播や大規模な重み更新は行いません。それなら推論は簡単で、計算量も問題にならないように思えるかもしれません。
しかし生成AIが社会へ普及すると、別の問題が現れます。一回の推論は学習全体よりはるかに軽くても、それを何百万回、何億回と繰り返すからです。しかも対話型AIでは、ユーザーは何時間も待ってくれません。なお、長く「考える」推論モデルやAIエージェントでは、1回の応答で生成するトークンやモデル呼び出し回数が増え、推論側の計算量も膨らみます。
そこで推論では、ピーク性能だけでなく、レイテンシ、消費電力、メモリ効率、同時実行数、そして1トークン当たり、さらにいえば1件の業務を完了するまでの総コストが重要になります。
学習が「大きな工場をどれだけ高効率で回せるか」という問題なら、推論は「顧客から注文が来るたび、速く、安く、途切れず届けられるか」という運用の問題へ変わるのです。
なぜ推論では専用チップが注目されているのか
推論では最高性能だけでなく「速く、安く、省電力で答えを返す」ことが重要になり、専用設計の余地が大きくなる。
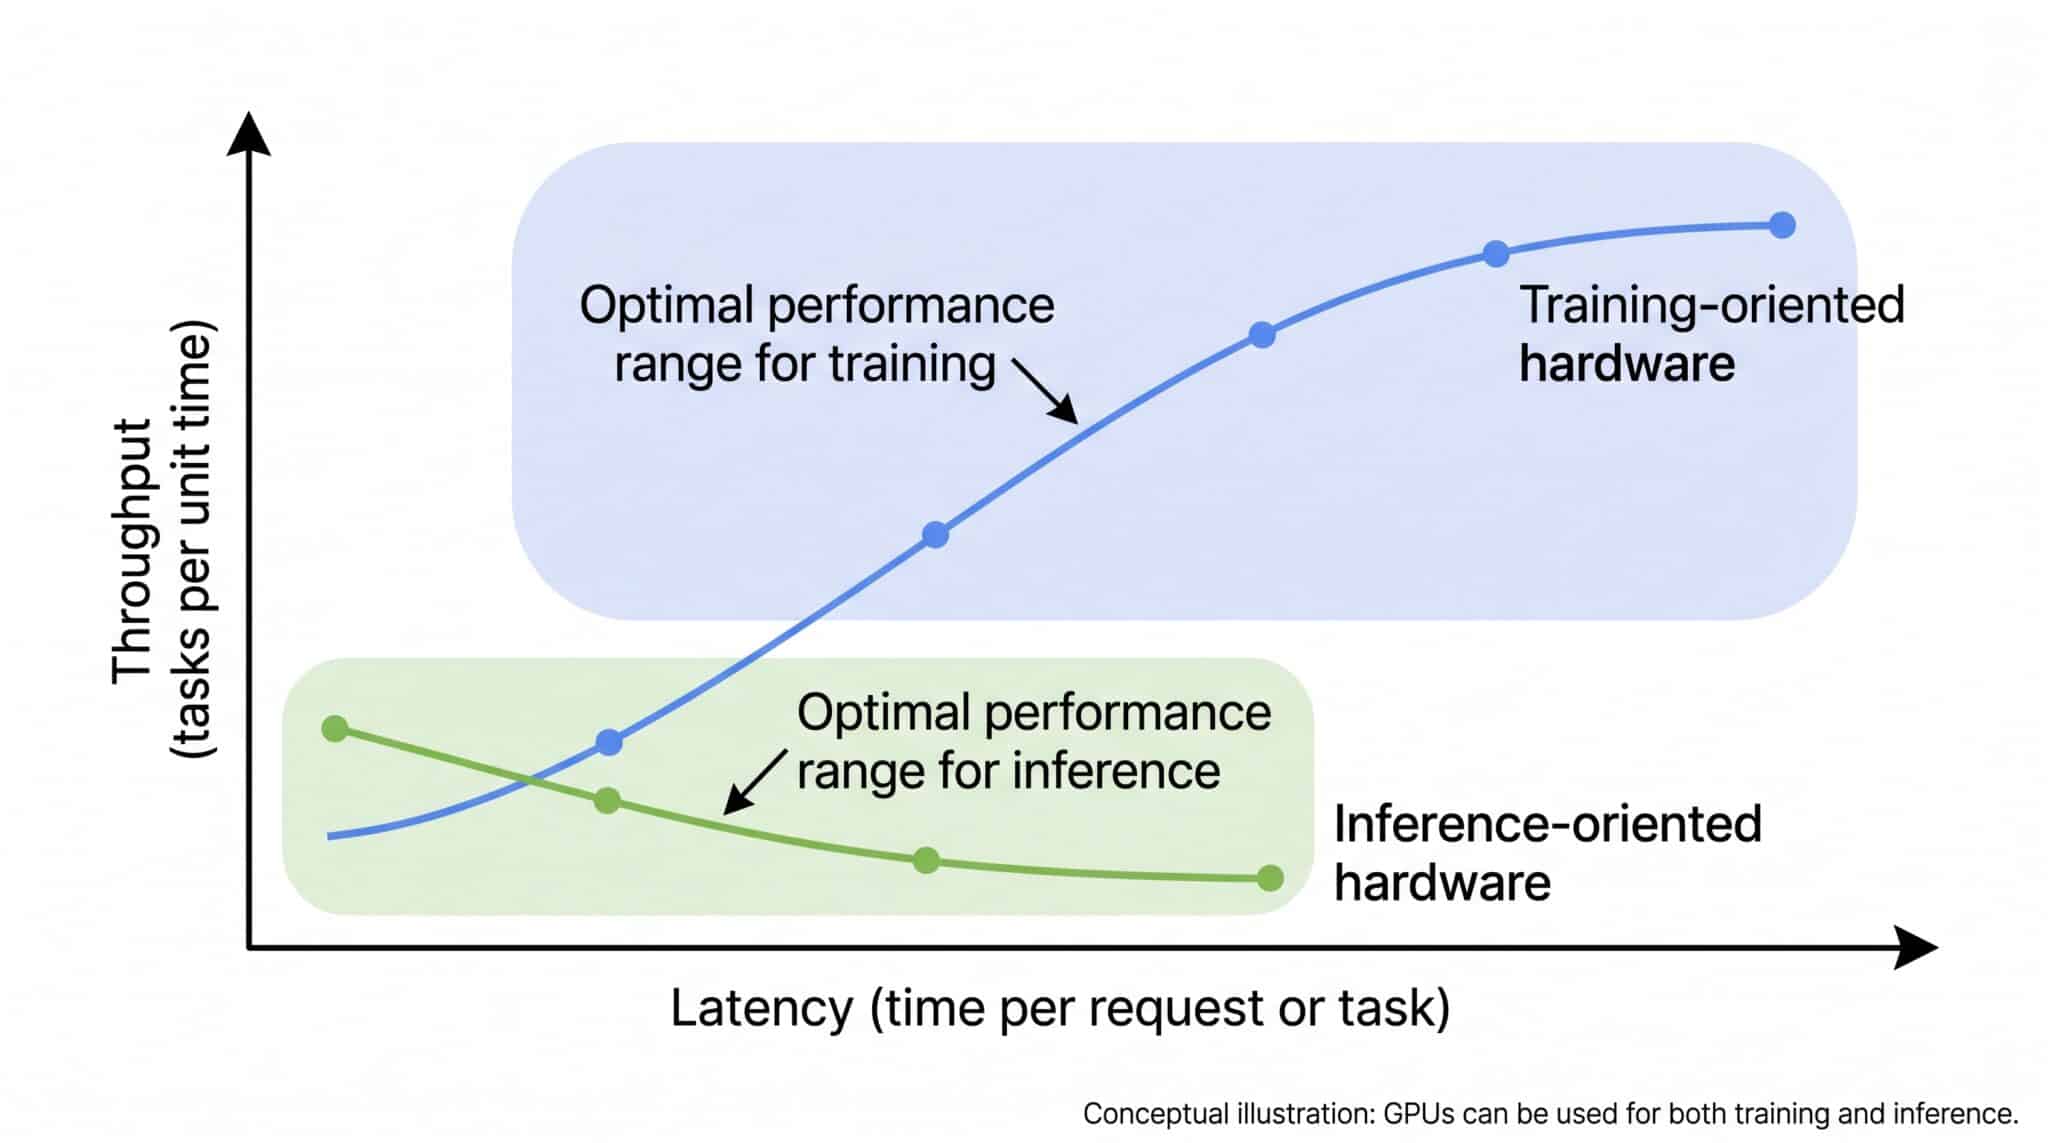
「学習チップ」と「推論チップ」という完全に別々の2種類の半導体が存在する、と考えるのは正確ではありません。GPUは学習にも推論にも使えます。
一方、推論では処理内容や運用条件を絞り込みやすいため、特定用途へ最適化したASICやNPU、専用アクセラレータが力を発揮しやすくなります。
象徴的なのがGoogleの第8世代TPUです。Googleは2026年4月、大規模な事前学習を主眼とするTPU 8tと、回答生成(sampling)、モデル提供(serving)、reasoning(推論モデルの思考処理)を主用途とし、ポストトレーニングや高並列reasoningにも最適化したTPU 8iを発表しました(Google公式発表、Google Cloud technical deep dive)。
その前段として、Googleは2025年に第7世代TPUのIronwoodを「推論向けに専用設計した最初のTPU」と位置づけて発表しています。Google自身が第8世代を「agentic era」に向けたチップとして打ち出していることからも、AIエージェント時代の大量推論を見据えて最適化軸が分かれていることがうかがえます(Google「Ironwood: The first Google TPU for the age of inference」)。
同じAIでも、学習させるのか、大量の利用者へ繰り返し届けるのかによって、最適な計算機は変わります。AI半導体の世界で起きているのは「GPUが終わる」という話ではなく、役割分担が深まっているという変化です。
推論特化アーキテクチャの具体例は、NVIDIA×Groqと推論特化LPUの仕組みで詳しく解説しています。
ここからは、推論の「速さ」と「原価」を左右する、もう一つの重要な要素――メモリとデータの動き――を見ていきます。
推論のボトルネックは演算だけではない
LLM推論では演算性能だけでなく、重みやKVキャッシュを運ぶメモリ容量・帯域が性能と原価を左右する。
 図:HBMとオンチップSRAMの配置・帯域特性を対比した概念図。実際のAIチップは用途に応じて複数のメモリ階層を組み合わせ、GPUも学習・推論の双方に利用される。
生成AIの推論は、大きくPrefillとDecodeという二つの工程に分けると理解しやすくなります。
Prefillは、ユーザーから渡された入力トークンをまとめて読み込み、出力生成の準備をする工程です。大量の行列演算を並列に処理できるため、比較的「計算性能」を生かしやすい処理です。
一方のDecodeは、文章を1トークンずつ順番に生成していく工程です。そのたびにモデルの重みや、それまでの文脈を保持するKVキャッシュを読み出す必要があります。
このためDecodeでは、演算器そのものが高速でも、必要なデータがメモリから届かなければ待ち時間が発生します。推論ではFLOPSの大きさだけでなく、メモリ容量、メモリ帯域、データ移動、電力まで含めて考える必要があります。

イメージとしては、高速道路の車線を増やすだけでは物流全体が速くならないのと同じです。必要なデータを必要な場所へ、必要なタイミングで届けられなければ、演算器は待たされます。厨房で言えば、食材が遠くの倉庫ではなく手元の棚にあるほど、料理を速く出せるのと似ています。
NVIDIAは推論TCOを考える際、単純なGPU時間単価やFLOPSだけでは不十分で、1トークン当たりのコスト(cost per token)が重要だと説明しています(NVIDIA AI Inference)。
Microsoftは2026年1月のFY2026第2四半期決算説明会で、AI基盤の第一層を「Cloud & Token Factory」と呼び、その重要な最適化指標としてtokens per watt per dollar(1ワット・1ドル当たりのトークン生成量)を挙げました。シリコン、システム、ソフトウェアを組み合わせ、利用率を高めながらTCOを下げる考え方です(Microsoft FY2026 Second Quarter Earnings Conference Call)。
AIチップ競争は、ピーク演算性能だけを競う世界から、メモリ・電力・ソフトウェアを含むシステム全体の効率競争へ広がっています。
学習と推論では「お金のかかり方」も違う――Arpable編集部の一次情報レビュー
主要AI企業の一次情報を横断すると、学習と推論では技術だけでなく、事業上のコスト発生構造も異なることが分かる。
 図:学習と推論のコスト構造を概念的に示したイメージ図。実データに基づくものではありません。
調査時点:2026年9月
調査主体:Arpable編集部
調査方法:主要AI事業者・クラウド事業者・半導体企業の公式資料、料金表、技術資料、決算資料を横断レビュー
主な対象:OpenAI、Anthropic、Google、AWS、Microsoft、NVIDIAほか
調査目的:学習と推論で異なるコスト構造を、一次情報からどこまで説明できるかの検証
一次情報を横断すると、学習は主にAIの「能力を作る費用」、推論は主にその「能力を使う費用」と捉えることで、技術と経営の両方がつながります。
| 観点 | 学習 | 推論 |
|---|---|---|
| 何をするか | モデルの能力を作る・改善する | 完成した能力を使う |
| 主な発生時点 | モデル開発・更新時 | AI利用時に繰り返し発生 |
| 主な原価ドライバー | GPU/TPU時間、データ、事前学習、ポストトレーニング、RL、評価 | 入出力トークン、文脈長、同時実行、キャッシュ、電力、設備稼働率 |
| 経営上の性格 | 主に開発・更新投資 | 主に利用量連動の継続原価 |
| 主な最適化軸 | 学習時間、計算量、モデル性能 | 1トークン当たりのコスト、電力効率、キャッシュ、バッチ、量子化 |
| 注意点 | 最初の一回だけではない | 利用量へ完全比例するとは限らない |
| ※出典:OpenAI、Microsoft、Google、AWS、Anthropic、NVIDIA等の一次情報を基にArpable編集部整理(2026年9月時点)。 | ||
※推論基盤を自社保有する場合は、設備の減価償却や予約容量など固定費・準固定費も発生します。ここでいう「利用量連動」とは、処理量が増えるほど必要な計算・電力・容量が増え、総原価や追加投資へ反映されるという意味です。
OpenAIは2026年の公式資料で、学習計算を将来の能力を作るもの、推論計算を現在の仕事を届けるものとして区別しています(OpenAI「A scorecard for the AI age」)。さらに同資料では、単純なトークン単価だけでなく、人の確認、再試行、手戻りも含め、品質基準を満たす業務を1件完了するまでのcost per successful taskを見る考え方を示しています。
この説明を企業経営へ翻訳すると、学習は主に「知能を作り、更新するための開発・更新投資」、推論は主に「知能を使うほど積み上がる継続原価」と整理できます。
ただし、ここでいう「開発・更新投資」は管理会計・事業構造上の表現です。モデルの学習にかかる費用が、財務会計上すべて資産計上されるという意味ではありません。
なぜ推論コストは企業経営の問題になるのか
生成AIでは利用回数が増えるほど計算処理も増えるため、推論効率がサービスの粗利率とユニットエコノミクスに直結する。
従来のSaaSでは、利用者が一人増えても追加原価が比較的小さいサービスが多く存在しました。生成AIでは事情が少し異なります。ユーザーがモデルを呼び出せば計算が走り、入力が長くなれば入力トークンが増え、回答が長くなれば出力トークンも増えます。
さらにAIエージェントでは、一つの業務を終えるまでに裏側でモデルを何度も呼び出す場合があります。表面上は「1回の仕事」でも、内部では多数の推論が走る可能性があります。
主要AI事業者の料金体系を見ると、この構造がよく分かります。OpenAIのAPI Pricing、AnthropicのClaude Platform Pricing、GoogleのGemini API Pricing、AWSのAmazon Bedrock Pricingはいずれも、入力・出力・キャッシュ・長文脈・バッチなど、処理量や処理方法に応じて料金体系を分けています。
ただし、API価格がAI事業者内部の推論原価そのものを示すわけではありません。価格には利益、販売政策、競争、契約条件なども含まれるためです。
それでも料金体系を見ると、どの処理を減らすと経済的価値が生まれるのかは分かります。キャッシュで同じ入力の再計算を避ける、リアルタイム性が不要な処理をバッチ化する、小型モデルへルーティングするといった施策がその例です。
高性能な大規模モデルを常にクラウドで呼び出すのではなく、用途によって小型モデルやオンデバイスAIへ処理を振り分けることも、推論原価を抑える有力な方法です。SLM・エッジAIによるAIコスト最適化戦略では、その判断軸を詳しく解説しています。
では、この推論原価は、実際の企業業績にどこまで表れているのでしょうか。
Microsoftの決算に見る「AI利用増と粗利率」の関係
推論効率は技術者だけの問題ではなく、すでに大手クラウド企業の売上原価や粗利率に現れる経営課題である。
Microsoft Cloudの粗利率は、FY2025通期の69%からFY2026通期には66%へ低下しました(Microsoft FY2026 Q4 Metrics)。またMicrosoftはFY2026の四半期開示で、AIインフラへの継続投資とAI製品利用の拡大が粗利率を押し下げる一方、AzureやMicrosoft 365 Commercial cloudの効率化がその一部を相殺したと説明しています(Microsoft FY2026 Q3 Performance)。なお、第4四半期のMicrosoft Cloud粗利率は65%で、同社はAzureへの売上構成の変化も押し下げ要因に挙げています(Microsoft FY2026 Q4 Earnings Conference Call)。
ここから導くべき結論は、「AIを使えば使うほど赤字になる」ではありません。重要なのは、利用量が増える速度に対して、1トークン当たり、あるいは1件の業務を完了するまでの推論原価をどこまで下げられるか、という点です。
従量課金なら利用増によって売上も増えやすい一方、定額制では一人あたり利用量だけが増えると粗利率を圧迫する可能性があります。逆に、キャッシュ、バッチ、小型モデルへのルーティング、量子化、専用チップ、ソフトウェア最適化によって単位原価を下げられれば、利用増と利益成長を両立できます。
つまり推論性能は、もはや「AIが何トークン出せるか」という技術指標だけではありません。AI事業の粗利率を左右する経営指標にもなりつつあります。
ただし、ここまでの整理を「学習は一度だけ、推論だけが続く」と理解すると、別の誤解が生まれます。
「学習は最初の一回だけ」ではない
学習も新モデル、ポストトレーニング、Fine-tuning、RL、蒸留によって繰り返されるため、一度きりとは言えない。
学習と推論を「開発側」と「運用側」のコストとして分けると理解しやすくなりますが、これを「学習は最初の一回だけ」と覚えてしまうと正確ではありません。
現在の大規模モデルは、事前学習を終えた後にもポストトレーニング、Fine-tuning、強化学習、安全性改善、評価、蒸留などを繰り返します。新しいモデル世代を作れば、大規模な学習計算も再び発生します。
さらに蒸留では、大きな教師モデルを使ってデータを作り、小さなモデルを追加学習することで、その後の推論コストを下げることがあります。つまり実務では、追加の学習コストを先に払って、その後の大量の推論原価を下げるという選択もあります。
学習用GPUと推論チップはどう使い分けるのか
最強のチップを探すのではなく、学習か推論か、クラウドかエッジか、何を最適化するかから判断することが重要である。
大規模モデルを一から開発するのであれば、巨大な行列演算を並列処理し、大量のメモリを扱える基盤が必要です。そのためGPUや学習向けTPUなど、大規模並列処理に強い基盤が重要になります。
一方、本番サービスで大量の問い合わせを処理する場合は、応答速度、1トークン当たりコスト、消費電力、同時実行数、メモリ容量、稼働率などの比重が高まります。
| 用途 | 重視するポイント | 候補となる基盤 |
|---|---|---|
| 大規模なモデル学習 | 並列計算、HBM容量・帯域、クラスタ性能 | GPU、学習向けTPUなど |
| クラウド推論 | レイテンシ、1トークン当たりコスト、同時実行、電力 | GPU、ASIC、推論アクセラレータ |
| 大量バッチ推論 | スループット、稼働率、単位コスト | GPU、ASIC、専用クラウド基盤 |
| エッジ・端末AI | 低消費電力、低遅延、ローカル処理 | NPU、エッジ向けASICなど |
| ※出典:NVIDIA、Google、AWS、Microsoft等の公式資料を基にArpable編集部整理(2026年9月時点)。 | ||
「GPUかASICか」という製品カテゴリーから入るのではなく、「何を処理し、何を最適化するのか」から考えるのが基本です。
NVIDIA Rubinを含む主要AIハードウェアの競争軸については、NVIDIA Rubinと競合AIハードウェア戦略でも詳しく整理しています。
選び方の物差しは見えてきました。では2026年、その物差しそのものはどう変わっているのでしょうか。
2026年、AIチップ競争で何が変わっているのか
AIチップ競争は「どれだけ計算できるか」だけでなく、「知能をどれだけ安く効率的に届けられるか」へ広がっている。
より高性能なAIを作るために、大規模な学習計算が重要であることは変わりません。一方、AIが検索、Copilot、業務システム、AIエージェント、スマートフォンへ広がるほど、本番環境で発生する推論回数も増えていきます。
そこで半導体企業やクラウド事業者が重視しているのが、1トークン当たりのコスト、電力当たりのトークン生成量、レイテンシ、メモリ効率、キャッシュ効率といった指標です。
GoogleのTPU 8t/8i、Microsoftのtokens per watt per dollar、NVIDIAの1トークン当たりコスト。前述の各社の動きは、いずれも「推論の単位原価をどう下げるか」という同じ問いに向かっています。
ここで興味深いのは、立場によって「原価」の物差しが変わることです。半導体・インフラ側では1トークン当たりのコストが重視される一方、AIサービス側では、期待する成果を1件得るまでの総コストが重要になります。つまり競争は、単に「何トークンを安く出せるか」から、「必要な仕事をいくらで完了できるか」へも広がっています。
AIの競争は、「どれだけ賢く作れるか」だけでなく、「その知能をいくらで届け続けられるか」まで含むようになりました。これが、2026年のAIインフラを見るうえで重要な変化です。
AIインフラ全体の変化については、AIインフラ市場と次世代計算基盤の展望も参照してください。
一次情報からどこまで言えるのか
推論の経済的重要性は強く確認できるが、「推論が学習を完全に上回った」と業界全体で断定できる一次統計はない。
今回のArpable編集部による一次情報レビューでは、主要企業の公式料金、技術資料、IR資料から、学習と推論の役割分担、推論単位原価の最適化、AI利用増と粗利率の関係について、この整理と整合する記述を複数の一次情報から確認できました。
一方で、「AI計算の何%がすでに推論になった」「推論市場が学習市場の何倍になる」といった業界全体の比率や将来市場規模は、市場調査会社や金融機関の推計に依存する部分があります。そのため、本記事ではこうした予測値を中核主張の根拠には使いません。
また、半導体各社が示す「何倍高速」「何%低コスト」といった数値も、モデル、精度、バッチサイズ、レイテンシ、ソフトウェア、比較対象によって変わります。
重要なのは、各社の「何倍速い」という数字そのものではありません。何を原価として捉え、何を下げようとしているかです。その視点で見ると、2026年のAI基盤競争は、推論の単位原価、電力、メモリ、レイテンシをめぐる競争へ明確に広がっています。
まとめ――学習は「知能を作る」、推論は「知能を届ける」
学習と推論の違いを理解すると、GPU・推論チップの設計思想からAIサービスの採算まで一本の線でつながる。
 図:AIの社会実装における「適材適所」。クラウドでの学習、モデル最適化、推論サーバーとエッジデバイスへの展開を示す。
AIの学習では、モデルが答えを出し、誤差を測り、逆伝播によって重みを修正します。そのため、大量の並列演算、大容量メモリ、高いスループットが重要になります。
推論では、学習済みの重みを使って答えを生成します。逆伝播は原則不要ですが、本番サービスでは大量の利用を低レイテンシ・低コスト・低消費電力で処理し続けなければなりません。
だからこそ、推論ではGPUに加えてASICやNPUなど、多様なアーキテクチャが競争する余地があります。そして企業経営の視点では、知能を作るための費用と、その知能を届け続けるための費用では、原価の発生の仕方が異なります。
冒頭の問いに戻りましょう。ChatGPTは、質問を送るたびに一から学習しているわけではありません。しかし、質問を送るたびに「推論する」という仕事は発生します。
だから生成AIが普及すればするほど、問われるのは「どれほど賢いAIを作れるか」だけではありません。
「その知能を、いくらで社会へ届け続けられるか」。学習と推論の違いは、AIの仕組みの違いであると同時に、AIビジネスの経済構造の違いでもあるのです。
専門用語まとめ
本文で登場した学習・推論・AIチップ関連の主要用語を、短く振り返るための一覧である。
- 学習(Training)
- データを使ってモデル内部の重みを調整し、能力を作る工程。
- 推論(Inference)
- 学習済みモデルを使って実際の入力に対する答えを生成する工程。
- 逆伝播(Backpropagation)
- 出力誤差をネットワークの後ろから伝え、各重みをどの程度修正するか計算する仕組み。
- GPU
- 大量の並列計算に強い演算装置。AI学習・推論の双方で広く利用される。
- HBM
- High Bandwidth Memoryの略。GPUやAIアクセラレータで使われる高帯域メモリ。
- KVキャッシュ
- LLMが過去の文脈を効率よく再利用するため保持するKey・Valueの中間情報。
- Prefill
- 入力トークンをまとめて処理し、出力生成の準備をする推論工程。
- Decode
- 学習済みモデルを使い、出力トークンを逐次生成していく推論工程。
- ASIC
- 特定用途へ最適化して設計された専用半導体。
- NPU
- Neural Processing Unitの略。ニューラルネットワーク処理へ特化した演算装置。
- TCO
- Total Cost of Ownershipの略。導入、設備、電力、運用などを含む総保有コスト。
参考文献 / 出典
本記事は主要AI事業者、クラウド事業者、半導体企業の公式資料と法定開示を優先して構成している。
一次情報
- OpenAI「A scorecard for the AI age」
- OpenAI「API Pricing」
- Anthropic「Claude Platform Pricing」
- Google「Gemini Developer API Pricing」
- Google「Our eighth generation TPUs: two chips for the agentic era」
- Google Cloud「TPU 8t and TPU 8i technical deep dive」
- Google「Ironwood: The first Google TPU for the age of inference」
- Amazon Web Services「Amazon Bedrock Pricing」
- NVIDIA「AI Inference」
- Microsoft「FY2026 Second Quarter Earnings Conference Call」
- Microsoft「FY2026 Q3 Performance」
- Microsoft「FY2026 Q4 Metrics」
- Microsoft「FY2026 Q4 Earnings Conference Call」
- Microsoft「FY2026 Form 10-K」
調査・整理:Arpable編集部(2026年9月)。半導体ベンダーの性能値は、モデル、精度、バッチサイズ、レイテンシ、ソフトウェア、比較条件によって異なります。本記事では各社公称値を普遍的な実測性能として扱わず、各社がどの性能指標を最適化しているかを中心に整理しています。
次に読むならこの3本
学習と推論の違いを起点に、AI半導体の使い分け、推論特化基盤、推論原価の最適化へ理解を広げる3本である。
補足Q&A
検索時に生じやすい「学習用GPU」「ChatGPTの学習」「推論チップ」の疑問を、本文の要点から簡潔に整理する。
Q1.
学習用GPUと推論用GPUは別物ですか?
A1.必ずしも別物ではなく、同じGPUを学習にも推論にも使えます。
ただし、学習では大規模並列性やメモリ容量・帯域が重視され、推論ではレイテンシ、電力、1トークン当たりのコストがより重要になります。そのため、用途ごとに最適化されたGPUやASIC、NPUなどが使い分けられています。
Q2.
ChatGPTを使うと、その場でAIは学習しているのですか?
A2.通常の会話ごとに、基盤モデルの重みそのものを更新しているわけではありません。
基本的には学習済みモデルを使った推論です。会話履歴やメモリ機能などでユーザーごとの文脈を保持することと、基盤モデルそのものを再学習することは別の仕組みです。なお、会話データを将来のモデル改善に使うかどうかは、各サービスの設定や規約によって異なります。
Q3.
なぜ推論向けの専用チップが注目されているのですか?
A3.推論では、速く・安く・省電力で大量の処理をさばくことが重要で、特定処理へ最適化した設計が有利になる場面があるからです。
GPUは推論にも使えますが、特定の処理へ最適化したASICやNPUは、レイテンシ、メモリ効率、消費電力、単位コストで有利になる場面があります。
更新履歴
検索意図と2026年のAIインフラ動向に合わせ、学習・推論・コスト構造の説明を継続的に更新している。
- 2026年9月26日:2026年版へ全面改稿。学習と推論の違いを主軸に再構成し、学習用GPU・推論チップ・コスト構造、Arpable編集部の一次情報レビューを追加。図表と一次情報の精度も更新。
- 2026年3月12日:初版公開。