※本記事は継続的に最新情報へアップデートしています。
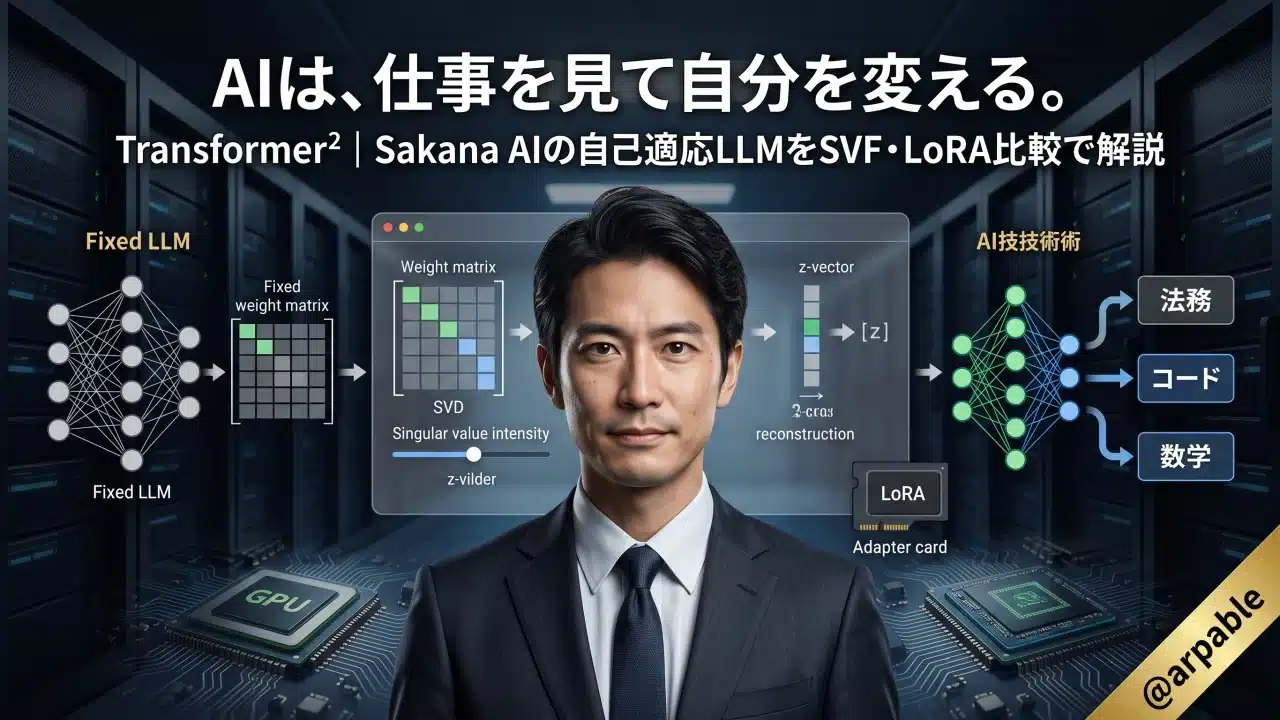
法務では契約書を読み、開発ではコードを書く。仕事が変われば、人間は頭の使い方を変える。それなのに、LLMはなぜ同じ重みのままなのか。Sakana AIのTransformer²とは、「仕事を見てから自分を変える」という発想でこの問いに挑んだ自己適応型LLMの研究である。
2026年のいま重要なのは、「最大16%改善」という数字そのものではない。固定されたAIから、状況に応じて能力の使い方を変えるAIへという転換点を理解することである。
✅ 先に結論
Transformer²は、入力タスクに応じて学習済みの「Expert(タスク別に学んだz-vector)」を選択・合成し、LLM内部の重みの使い方を変える自己適応フレームワークです。
- 核心:SVFで重み行列の特異値側だけを調整し、モデル全体を学び直さず能力の「配合」を変える。
- 違い:LoRAが軽量な専門化を担うのに対し、Transformer²は推論時に「どの能力を使うか」まで決める。
- 限界:自己適応と再帰的自己改善(RSI)は別物。Transformer²は完成した自己進化AIではない。
Transformer²とは?――「仕事を見てから自分を変える」LLM
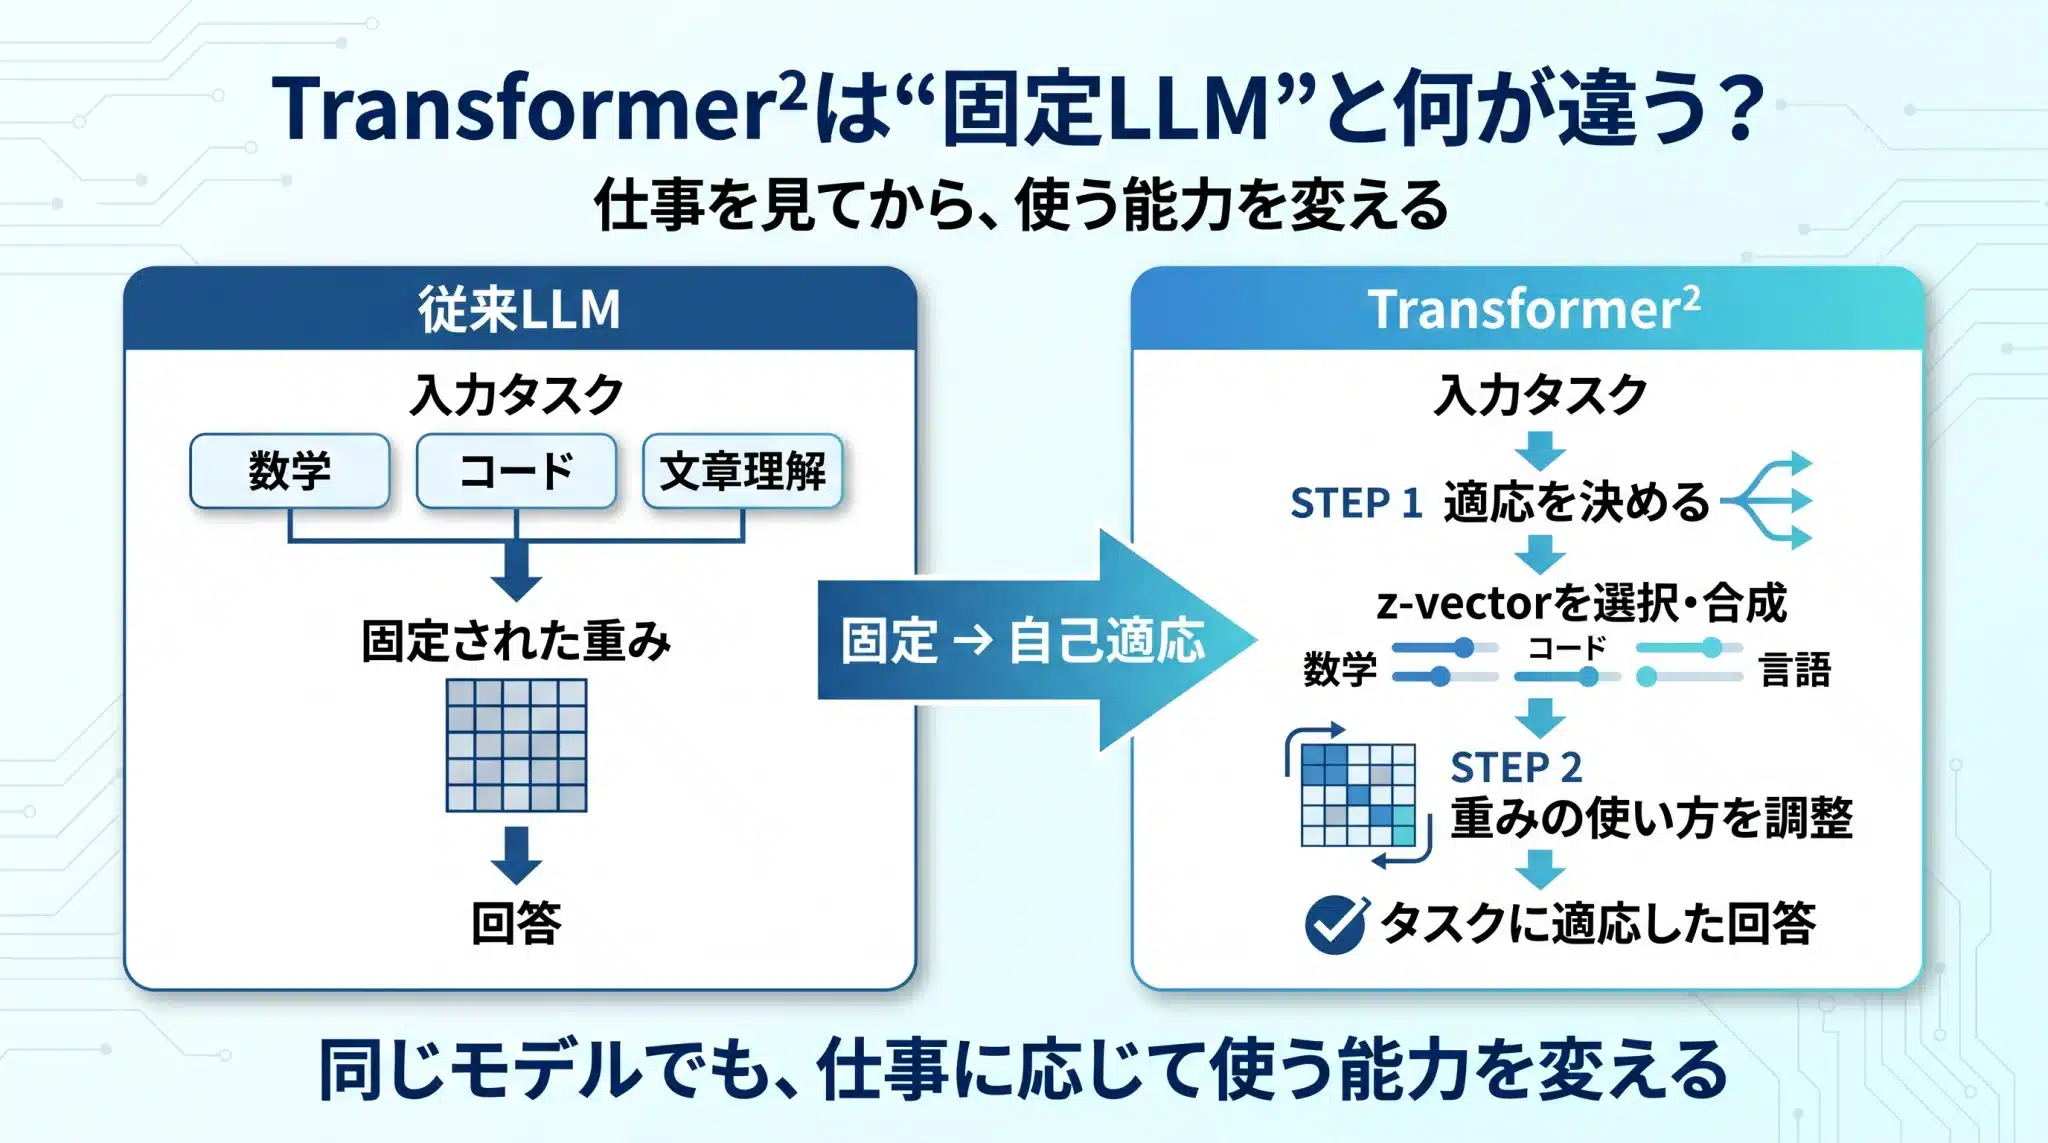
Transformer²の革新性は、学習後のモデルを固定したまま使うのではなく、推論時にタスクへ合わせて重みの働き方を変える点にある。
一般的なLLMは、事前学習や事後学習を終えた後、基本的に同じ重みで数学にもコードにも文章理解にも向き合います。Transformer²はそこへ「推論時の適応」を持ち込みました。
Sakana AIが2025年1月15日に公開したTransformer²(Transformer-Squared/Transformer2)は、①入力された仕事の性質を見極め、②その仕事に合うようモデルを適応させて回答する、という2段階の仕組みです。Sakana AI公式も、名称の「²」はこのtwo-step processを反映したものだと説明しています。
モデルを毎回ゼロからファインチューニングするわけではありません。あらかじめ学習した小さな適応情報を選択・合成し、モデル本体の重みの働き方を変えます。研究成果はICLR 2025のConference Paperとして発表されています。
Transformer²が解こうとしているのは、従来のファインチューニングが抱える二つの課題です。学習にコストがかかること。そして、一度専門化すると振る舞いが固定されやすいことです。
特定用途向けにあらかじめ専門化するのではなく、未知の仕事が来た時点で、すでに持つ能力から最適な組み合わせを作る。この発想が、Transformer²を単なる軽量ファインチューニング手法と分けるポイントです。
Sakana AI全体の研究思想や、モデルマージ、AI Scientist、Namazu、Fuguなどへの展開は、Sakana AIとは?何をしている会社かをM2N2・Namazu・Fuguから読み解く【2026年版】で整理しています。
核心技術SVF――巨大なLLMの「つまみ」だけを動かす
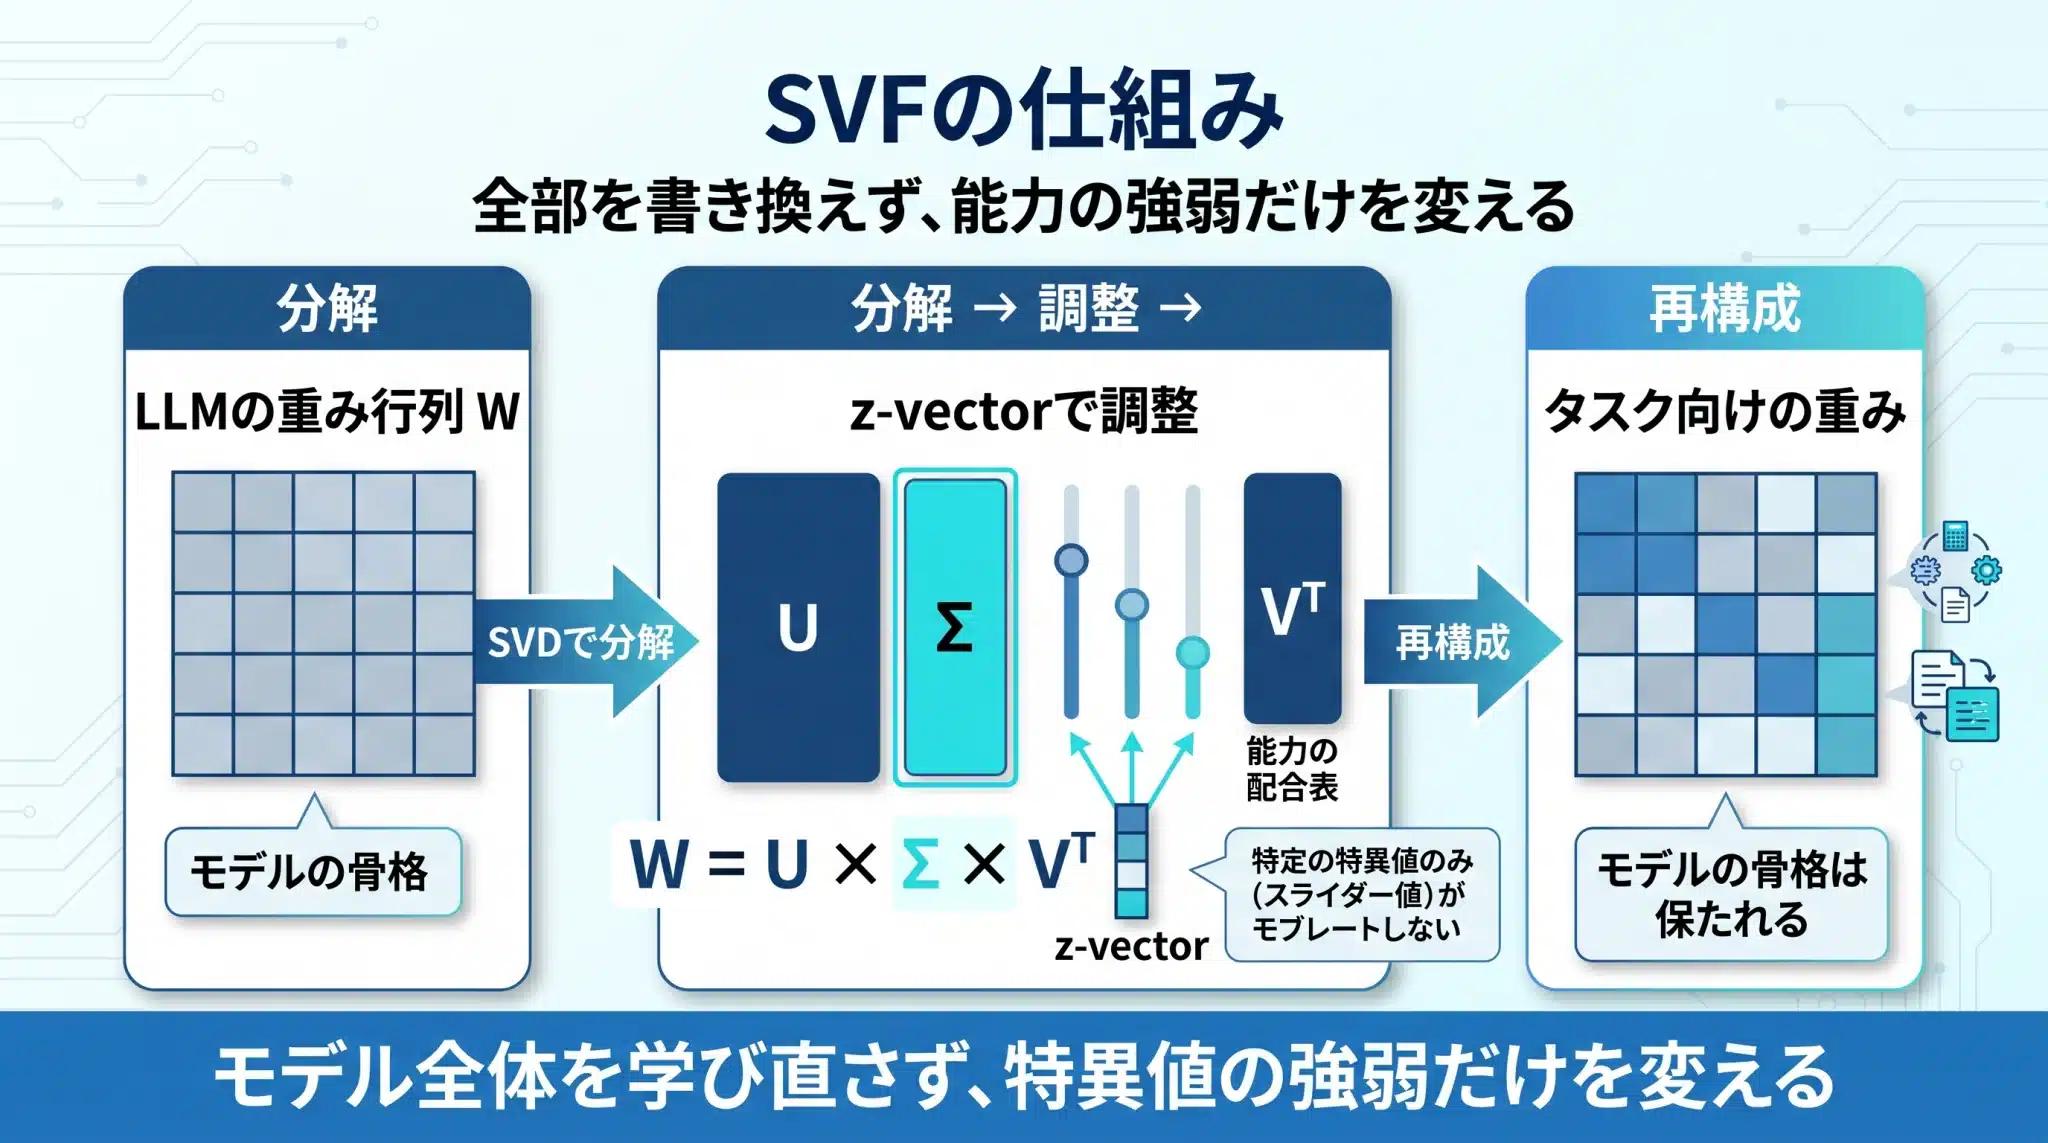
SVFは巨大なモデル全体を書き換えず、重み行列を分解して「どの能力をどれだけ使うか」だけを調整する手法である。
Transformer²の核心がSVF(Singular Value Fine-tuning)です。SVFでは重み行列WをSVD(特異値分解、Singular Value Decomposition)でU・Σ・Vᵀに分解し、中央の特異値Σの強弱をz-vectorで調整します。
要するに、モデル全体を学び直すのではなく、「能力そのもの」ではなく「能力の使い方」を変えるという発想です。数学ではある成分を強め、コード生成では別の成分を前面に出す。その配合を表す小さなベクトルがz-vectorです。
なぜ特異値に注目するのでしょうか。SVDでは重み行列を、方向を表すU・Vᵀと、その方向がどれだけ強く働くかを表すΣへ分けられます。Transformer²は主にこの「強さ」の部分へ介入するため、モデルの構造を大きく崩さずにタスク固有の調整を行えます。
もう一つの利点が、組み合わせやすさです。SVFのz-vectorは線形に混ぜやすく、複数のExpertを組み合わせるFew-shot adaptationの土台になっています。
さらに、学習方法にも特徴があります。SVFのz-vectorは強化学習で学習されます。著者らの実験では、同じRL目的をLoRAへ適用すると学習が不安定になりやすかった一方、SVFでは安定して改善しました。これは「LoRAよりSVFが常に優れる」という一般論ではなく、この論文の設定ではSVFのパラメータ化がRLと噛み合ったという結果です。
料理人に例えると、z-vectorは「配合表」
世界中の料理を作れる熟練シェフでも、寿司とパンでは使う技法の比重が違います。z-vectorはシェフの腕前そのものではなく、注文ごとに「どの技法をどの強さで使うか」を指定する配合表です。Transformer²はシェフを再教育するのではなく、今の仕事に合う能力の配合へ切り替えるのです。
LoRAとは何が違うのか
LoRAがモデルを軽量に専門化する技術だとすれば、Transformer²は「今の仕事にどの専門能力を使うか」まで推論時に決める。
LoRAも、モデル全体をファインチューニングせず、小さな追加パラメータで特定用途へ適応させる代表的なPEFT技術です。違いは、Transformer²が推論時の能力選択・合成まで扱う点にあります。
| 比較軸 | LoRA | Transformer² |
|---|---|---|
| 基本思想 | 特定用途向けの軽量な差分を学習 | タスクを見てモデル自身の使い方を適応 |
| 主な調整方法 | 低ランク行列を追加 | SVDで分解した成分の強弱をz-vectorで調整 |
| 推論時 | 原則として準備済みAdapterを利用 | タスク条件に応じてz-vectorを選択・合成 |
| 未知タスク | 準備したAdapterとの適合性に依存 | 複数の学習済みExpertを組み合わせて適応を試みる |
| 成熟度 | 実用技術として広く普及 | 研究フレームワーク |
| ※出典:Transformer-Squared: Self-adaptive LLMs(ICLR 2025)。評価条件は限定されており、「SVFが常にLoRAより優れる」という意味ではない。 | ||
論文では、SVFの学習対象パラメータ数は著者らのLoRA実装の10%未満で、複数のテキストタスクでLoRAを上回りました。ただしLoRAはすでに成熟した実用技術であり、単純な勝敗ではありません。LoRAが「軽く専門家を作る」なら、Transformer²は「今の仕事には誰を使うか」まで決める、という違いです。
論文ではLoRAを未知タスクへ転用したとき、一部で性能低下も確認されています。これはLoRA一般の欠点というより、特定タスクへの専門化と、未知タスクへ柔軟に適応することは別の問題だと示す結果です。Transformer²は後者を正面から扱っています。
MoE(Mixture of Experts)とも役割が異なります。一般的なMoEはモデル内部でトークンごとにExpertをルーティングしますが、Transformer²は入力やタスク条件に応じ、サンプルまたはタスク単位で適応用z-vectorを選択・合成します。
Transformer²はどう自分を変えるのか――2段階推論と3つの適応戦略
Transformer²は、まず「どの能力を使うか」を決め、その後に調整済みの重みで回答する。違いは、その能力選択の方法にある。
Transformer²の2段階構造はシンプルです。第1段階で入力の性質や少数の評価例から適応方法を決め、第2段階でz-vectorを選択・合成し、調整後の重みで回答します。
ただし、3つの方式が同じ手順でタスクを分類するわけではありません。Promptは「選ぶ」、Classifierは「分類Expertに選ばせる」、Few-shotは「複数Expertの配合を探す」と覚えると違いが見えます。
Prompt-based adaptation
専用の適応プロンプトでタスクを判定し、対応する学習済みz-vectorを選びます。追加学習が不要な一方、分類精度はプロンプトとモデル自身の判断に依存します。
Classifier-based adaptation
タスク分類そのものを、SVFで学習した分類専用Expertへ任せます。別モデルを用意するのではなく、同じLLMにタスク識別の役割を覚えさせる方式で、論文ではLlama3-8BとMistral-7BでPrompt方式より高い分類精度が報告されています。
Few-shot adaptation
少数の評価例を手がかりに、複数の学習済みz-vectorをどの比率で組み合わせるかを探索します。一般的なFew-shot promptingのように例を毎回プロンプトへ足すのではなく、モデル内部で使う能力の配合比を決める方式です。
論文ではCEM(Cross-Entropy Method)を使って配合係数を探索します。主実験で使う評価例はタスクごとに最大10件で、探索は各プロンプトのたびではなく対象タスクごとに一度です。追加実験では3〜5件でも効果が現れ、10件を超えると改善が頭打ちになる傾向が示されました。つまりFew-shot adaptationの発想は、「毎回長い例を付ける」のではなく、少数例からその仕事専用の能力配合を先に見つけることにあります。
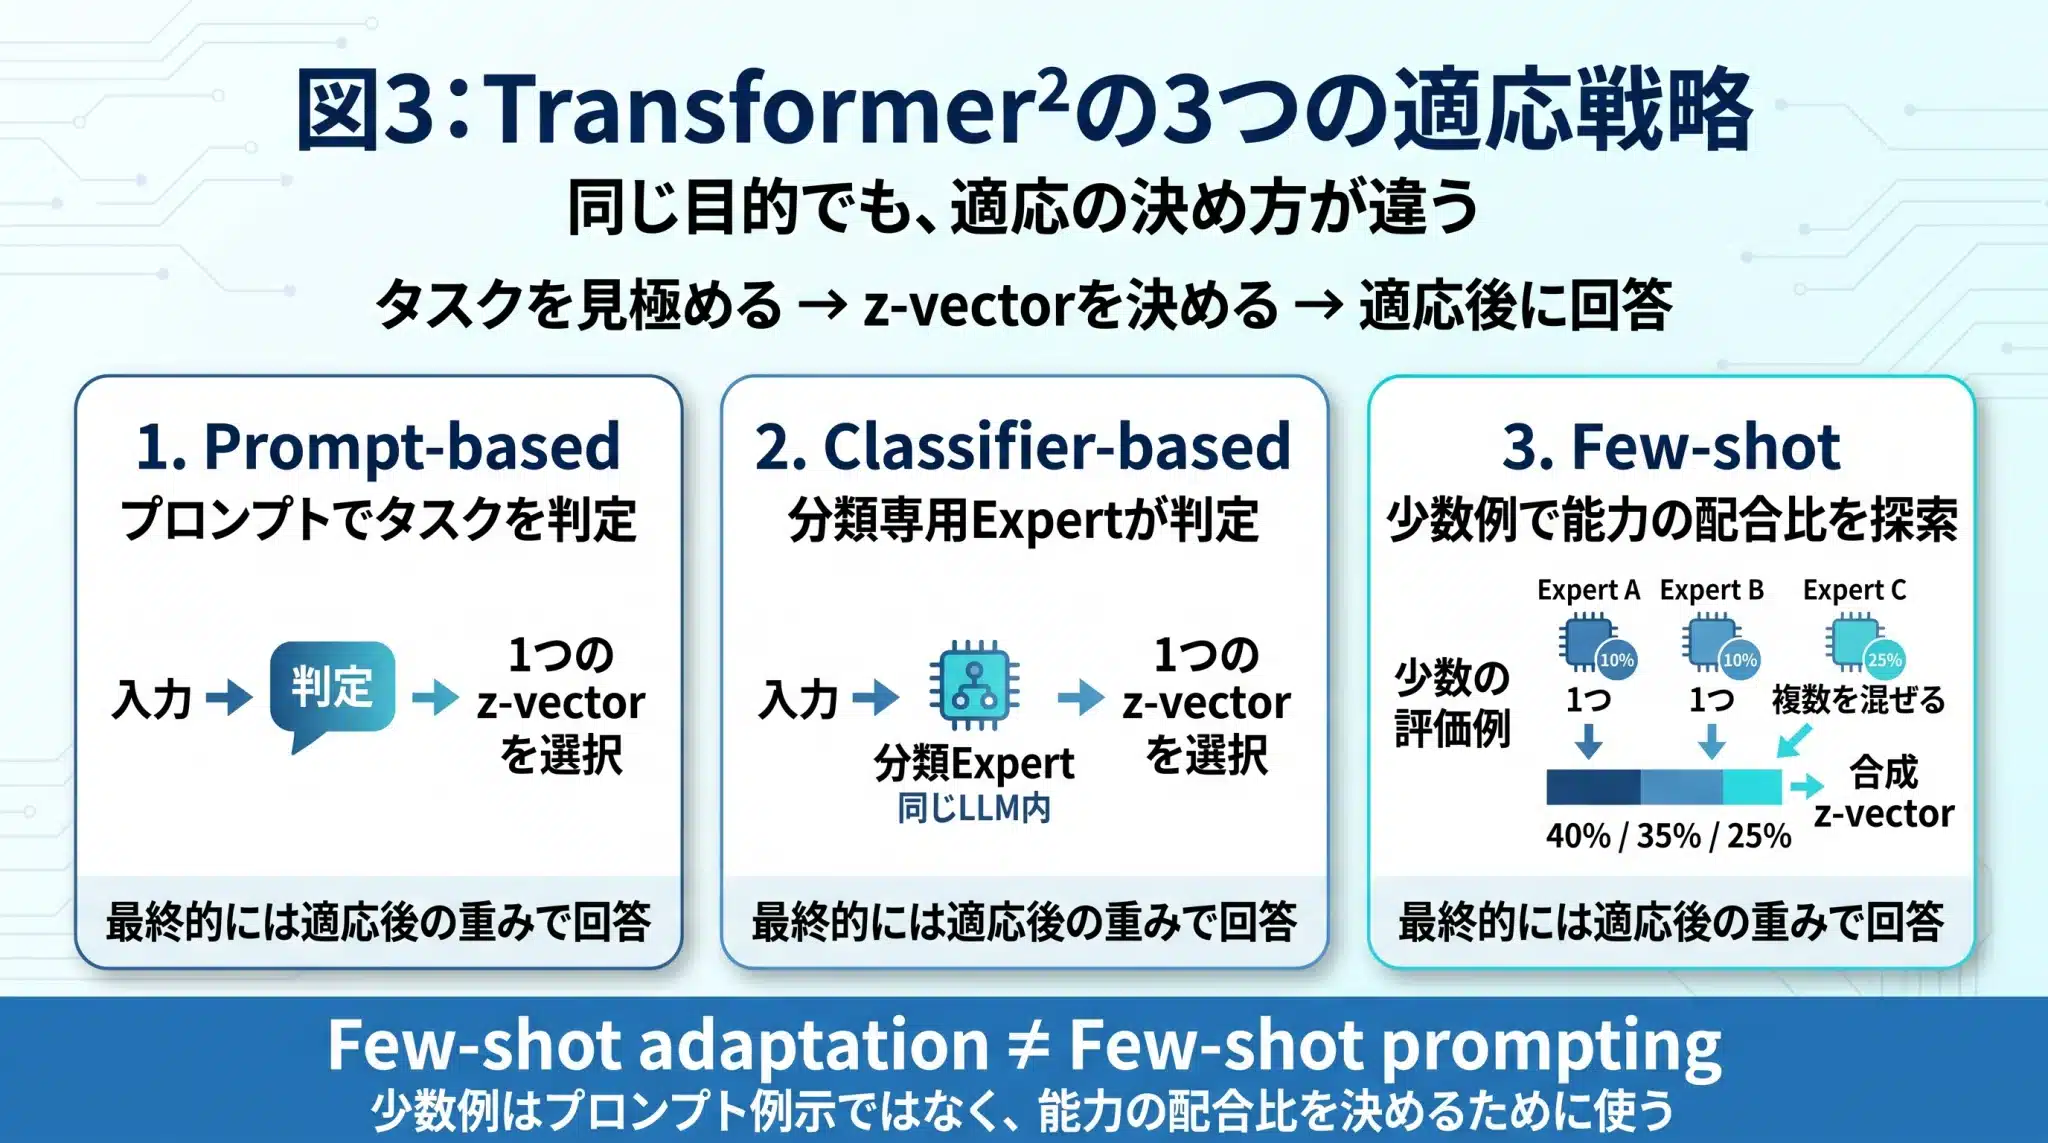
論文のMATH適応では、GSM8K由来の数学Expertだけでなく、プログラミングや論理推論に関係するExpertも組み合わされました。未知の仕事へ向き合うとき、既存能力を一つ選ぶだけでなく、複数の能力を「混ぜる」ところがTransformer²の面白さです。
実験から何が分かったのか――性能・能力転送・コスト
実験が示したのは「何でも16%伸びる」ことではなく、既存能力の再構成で未知タスクへ適応できる可能性と、その限界である。
| 実験 | 結果 | 意味 |
|---|---|---|
| SVF / GSM8K | Mistral-7B:42.83 → 49.74 | 特定条件では約16%改善 |
| Few-shot / HumanEval | Mistral-7B:43.29 → 47.40 | 未知タスクでも能力合成が有効な例 |
| Cross-model | 3タスク中2タスクで改善 | z-vector転送の可能性。ただし一般化は未証明 |
| Prompt方式の追加推論 | MATH 13%、HumanEval 19%、ARC-Challenge 47% | 自己適応には推論コストがある |
| ※出典:Transformer-Squared: Self-adaptive LLMs(ICLR 2025)。モデル・タスク・適応方式により結果は異なる。 | ||
「最大16%」はSVFの特定条件での結果
GSM8Kでは、Mistral-7B-Instruct-v0.3のベーススコア42.83に対し、SVFは49.74でした。絶対値で6.91ポイント、ベース比で約16%の改善です。Llama3-8Bも75.89から79.15へ改善しました。
ただし、これは既知タスクでSVFそのものを評価した結果です。未知タスクへのTransformer²本体では、Mistral-7BのHumanEvalが43.29からFew-shotで47.40へ改善する一方、MATHでは方式によってベースを下回るケースもありました。改善幅はモデル・タスク・適応方式で変わります。
専門化は、別の仕事では足かせにもなる
Llama3-70Bでは、MATHへ別タスクで学習したLoRAを適用すると40.64から25.40まで低下しましたが、Transformer²のPrompt方式は40.44とベース性能をほぼ維持しました。ここで重要なのは「専門化すれば強くなる」ではなく、必要な専門能力を必要なときに選べるかという視点です。
能力は別モデルへ移せるのか
Llama3-8Bで学習したz-vectorをMistral-7Bへ転用する実験では、3つの未知タスクのうちHumanEvalとARC-Challengeで改善し、MATHは13.02から12.65へわずかに低下しました。能力転送の可能性は見えますが、異なる構造のモデル間でも一般化できると証明されたわけではありません。
適応にもコストがかかる
Prompt-based adaptationでは、回答前に適応を決める追加推論が必要です。論文では第2パスに対する第1パスの推論時間比が、MATHで約13%、HumanEvalで約19%、ARC-Challengeで約47%でした。ARC-Challengeは回答生成が短いため比率が大きく見えますが、自己適応にも時間と計算資源が必要という点は変わりません。
Few-shot adaptationにも別のトレードオフがあります。Expertの配合探索はタスクごとの一回限りなので、同じ種類の仕事を大量に処理するほど1件当たりの負担は薄まります。逆に、数件だけ処理する単発タスクでは探索コストが割高です。論文自身も、プロンプト数が少ない場合はPrompt方式など別の適応方法が適する可能性を指摘しています。
自己適応は自己改善ではない――2026年のSakana AI研究から境界を見る
Transformer²、Text-to-LoRA、RSIは同じ技術ではない。並べて見ることで「適応」と「自己改善」の境界がむしろ鮮明になる。
Transformer²は入力に応じて学習済み能力を選択・合成しますが、自分で新しいコードや学習アルゴリズムを発明し、改善を再帰的に続けるわけではありません。より正確には、「学習済みの能力を、推論時に動的に再構成するAI」です。
| 観点 | 自己適応(Transformer²) | 自己改善(RSI) |
|---|---|---|
| 主に何を変えるか | 学習済み重みの使い方、z-vectorの選択・配合 | コード、アルゴリズム、学習方法、AI開発プロセスなど |
| 新しい能力 | 学習済み能力を選択・合成する | 新しい改善方法や能力そのものの生成を目指す |
| 現在地 | ICLR 2025で検証された研究フレームワーク | RSI Labなどで研究が進む段階 |
| ※自己適応とRSIは別の技術軸であり、Transformer²がそのままRSIへ発展するという意味ではない。 | ||
Arpableの自己進化型AIとは?AIの自己改善は“Critical”に近づいたのか【2026年版】では、自己改善の進展をLevel 1〜4で整理しています。その枠組みで見ると、Transformer²はLevel 3以上の「AI開発プロセスの改善」ではなく、モデル内部の重みの使い方を変える「自己適応」という別軸です。
Text-to-LoRA/Doc-to-LoRA――能力や知識を必要なときに与える
2025年6月12日に発表されたText-to-LoRAは、自然言語でタスクを説明すると、その仕事向けのLoRA AdapterをHypernetworkが生成する研究です。2026年2月27日のDoc-to-LoRAは、文書からAdapterを生成し、新しい知識をモデルへ取り込む方向へ広げました。
Transformer²とこれらは同じ仕組みでも、直接の後継でもありません。ただし、巨大なモデルそのものを毎回作り直すのではなく、必要な能力や知識を必要なときに与えるという問題意識には共通点があります。
違いを一言でいえば、Transformer²は「既に持つExpertをどう使い分けるか」、Text-to-LoRAは「タスク記述から新しいAdapterをどう作るか」、Doc-to-LoRAは「文書の知識をどうAdapterへ変換するか」を扱います。同じ「適応」でも、変えている対象は異なります。
RSI Lab――改善対象はモデルから研究開発プロセスへ
2026年6月5日、Sakana AIはRecursive Self-Improvement Lab(RSI Lab)の始動を発表しました。RSI Labでは、Agent Native Model、AI Scientist、AIによるAI開発・改善ループなど、モデル単体より広い研究開発プロセスを対象にしています。
これはTransformer²→Text-to-LoRA→RSIという直線的な技術進化の年表ではありません。「何を適応・改善の対象にするか」を比較すると、重みの使い分け、Adapter生成、研究開発プロセスという違いが見えてきます。
研究史として興味深い符合もあります。Transformer²論文は、自らの重みを書き換えて適応する研究の先行例としてJürgen Schmidhuber氏の1993年の研究を引用しています。その同氏は2026年9月24日にSakana AIのChief Scientific Advisorとして参画し、RSI Labにも関与しました。ただし、これをもってTransformer²とRSIが直系の技術系譜にあるとは言えません。
企業にとってTransformer²は何を意味するのか
Transformer²は完成製品ではないが、「最強モデルを一つ選ぶ」から「仕事に応じて能力を配置する」への発想転換を先取りしている。
企業AIでは、単一LLM+RAG、用途別Adapter、複数モデルのルーティング、SaaS利用などが併存しています。用途へ最適化するほど性能や安全性を高めやすい一方、評価、更新、監査、権限管理の対象も増えます。
Transformer²が投げかけるのは、「モデルを増やす前に、一つのモデルの中で能力を切り替えられないか」という問いです。現時点でそのまま企業導入する完成製品ではありませんが、「最強モデルを一つ選ぶ」から「仕事に合わせてモデルや能力を配置する」へ移る企業AI設計を考えるうえで示唆があります。
企業のLLM選定をモデル単体の順位ではなく配置設計から考えたい方は、LLMモデルポートフォリオ設計2026|単体比較からモデルレイヤー戦略へも参照してください。
企業が持ち帰るべき3つの判断軸
1つ目は「仕事が繰り返されるか」です。Few-shot方式の探索コストはタスクごとの一回限りなので、同種タスクを大量処理するほど考え方との相性がよくなります。2つ目は「能力を切り替える価値があるか」です。法務、コード、推論のように要求能力が明確に変わる仕事ほど、自己適応という設計思想が効いてきます。
3つ目は「適応後を評価できるか」です。モデルが状況に応じて変わるほど、企業側には「どのExpertを使ったか」「適応後に品質が上がったか」「安全性が崩れていないか」を評価・監査する仕組みが必要になります。自己適応はモデル管理を消す魔法ではなく、管理対象を“モデルの数”から“能力の切り替え”へ変える可能性を持つ技術です。
一次情報からどこまで言えるか――Living Intelligenceは将来ビジョン
論文が実証したのは限定条件での動的適応であり、継続的に自律進化する「Living Intelligence」は将来像として分けて読む必要がある。
Sakana AIはTransformer²を、静的なモデルから環境やタスクに応じて変化する「Living Intelligence」へ向かう構想の一部として描いています。しかし、この言葉は現在のTransformer²が実証した機能そのものではありません。
一次情報で確認できることは、限定されたモデルとタスクで、学習済みz-vectorを選択・合成し、未知タスクへ動的に適応できたこと、クロスモデル転送の一部で改善が見られたこと、適応に追加推論コストが生じることです。
一方、長期間にわたって経験を蓄積し続けること、自ら新しい能力を発明すること、異質なモデル間で能力を自由に移植すること、安全に自律更新し続けることまで実証されたわけではありません。Transformer²は「完成した自己進化AI」ではなく、固定されたLLMをどう動的な存在へ変えるかを問う研究です。
まとめ――Transformer²の価値は「16%」ではない
Transformer²が残した最も重要な問いは、「AIは一度学習したら、なぜ同じ自分のままでいなければならないのか」である。
法務では契約書を読み、開発ではコードを書く。人間が仕事に応じて頭の使い方を変えるように、AIも固定されたままである必要はない――。Transformer²は、その可能性をSVFと動的なExpert選択で示しました。
もちろん、Transformer²は完成した自己改善AIではなく、すべてのタスクで性能を上げる万能技術でもありません。それでも、AIの価値は完成時の性能だけでなく、目の前の仕事に合わせて持っている能力をどう使い直せるかでも測られるという新しい見方を残しました。
2026年のいま、Transformer²は「最新モデル」ではありません。しかし、冒頭で投げかけた「AIは一度学習したら固定されたままでよいのか」という問いは、発表当時よりむしろ重くなっています。
次に見るべき競争軸は、モデルがどれだけ大きいかだけではありません。持っている知能を、目の前の仕事に合わせてどう組み替えられるか。Transformer²は、その問いを私たちに残した研究です。
専門用語まとめ
Transformer²を理解するために必要な専門用語を、数式に深入りせず実務読者向けに整理する。
- Transformer²
- Sakana AIが提案した自己適応型LLMフレームワーク。推論時にタスク条件を判定し、モデルの重みの働き方を動的に調整する。
- SVF
- Singular Value Fine-tuning。SVDで分解した重み行列の特異値側を調整し、少ないパラメータでタスク適応を行う手法。
- SVD
- 特異値分解(Singular Value Decomposition)。行列を複数の数学的な成分へ分解する方法。
- z-vector
- SVFで学習される適応ベクトル。重み行列の各成分をどの程度強めるか、弱めるかを表現する。
- LoRA
- Low-Rank Adaptation。巨大なモデル本体を直接更新せず、小さな低ランク行列を追加学習する代表的なPEFT手法。
- RSI
- Recursive Self-Improvement。AIがAIシステムや学習・開発プロセスを改善し、その成果をさらに次の改善へつなげる再帰的自己改善の考え方。
参考文献 / 出典
Transformer²の仕様・実験結果・後続研究は、Sakana AI公式発表とICLR 2025の原論文を中心に確認した。
Transformer²
- Sakana AI – Transformer²: Self-Adaptive LLMs(2025年1月15日)
- Transformer-Squared: Self-adaptive LLMs – ICLR 2025 Conference Paper
- Transformer-Squared: Self-adaptive LLMs – arXiv
Text-to-LoRA / Doc-to-LoRA
- Sakana AI – Text-to-LoRA: Instant Transformer Adaption(2025年6月12日)
- Sakana AI – Instant LLM Updates with Doc-to-LoRA and Text-to-LoRA(2026年2月27日)
- Text-to-LoRA: Instant Transformer Adaption
- Doc-to-LoRA: Learning to Instantly Internalize Contexts
Recursive Self-Improvement
- Sakana AI – AIがAIを作る:Sakana AI「RSI Lab」始動(2026年6月5日)
- Sakana AI – 人工知能のパイオニア、ユルゲン・シュミットフーバー氏がSakana AIに参画(2026年9月24日)
※Transformer²、Text-to-LoRA、Doc-to-LoRA、RSIは同一技術ではありません。本稿では「何を適応・改善の対象にするか」という比較軸で整理しています。
次に読むならこの3本
Transformer²からSakana AI全体、自己改善AI、日本向け適応へ読み進めると、「適応するAI」の研究と事業の両面がつながる。
補足Q&A
検索時に生じやすいTransformer²、LoRA、自己改善AI、元祖Transformerとの違いを4問で整理する。
Q1.
Transformer²は新しいLLMですか?
A1. いいえ。既存のLLMへ適用する自己適応フレームワークです。
LlamaやMistralなどへSVFを適用し、タスク固有のz-vectorを学習します。推論時にはタスク条件に応じてz-vectorを選択・合成し、重みの働き方を調整します。
Q2.
Transformer²はLoRAより優れていますか?
A2. 一律に優れているとは言えません。
論文ではSVFやTransformer²がLoRAを上回る結果もありますが、評価条件は限定されています。LoRAは成熟した実用技術で、Transformer²は推論時の動的適応を探る研究フレームワークです。
Q3.
Transformer²は自己改善AIですか?
A3. 厳密には、自己改善AIではなく自己適応型AIです。
学習済みの適応情報をタスクに応じて選択・合成しますが、自分で新しいコードや学習方法を作り、改善を再帰的に繰り返すRSIとは区別する必要があります。
Q4.
Transformer²は、元祖「Transformer」の後継アーキテクチャですか?
A4. いいえ。Transformerアーキテクチャそのものを置き換える技術ではありません。
LlamaやMistralなど既存のTransformer系LLMの上で、推論時に重みの使い方を適応させるフレームワークです。
更新履歴
初版公開以降の主要な更新内容を記録し、2026年版で何を追加・再検証したかを明確にする。
- :初版公開。SVF、適応戦略、性能評価を中心に解説。
- :記事内容を更新。
- :2026年版へ全面改稿。LoRA比較、後続研究、RSIとの違いを追加し、一次情報を再検証。