※本記事は継続的に最新情報へアップデートしています。
AIは、もう自分自身を進化させ始めているのか。2026年、その問いはSFの世界から、OpenAIやAnthropicが「測定」する研究テーマへ移った。
AIはコードを書き、実験を回し、アルゴリズムを改善し、AI研究そのものを支援している。だが、より賢い後継AIを自律的に作り、そのAIがさらに次世代を作るRecursive Self-Improvement(RSI)には、まだ到達していない。
2026年の本当の問いは「AIは自己改善できるか」ではない。AI開発ループのどこまでが閉じたとき、その能力をCriticalと考えるべきなのかである。
✅ 先に結論
2026年9月の自己進化型AIは、AIがAI研究・実験・アルゴリズム探索を支援する「Level 3」の途上にある。完全なRSIに相当する「Level 4」は、まだ実現していない。
- 現在地:回答修正だけでなく、エージェントコード、ツール、実験工程、アルゴリズムまでAIが改善し始めている。
- 境界線:AIがコードを書けることではなく、研究テーマ設定・評価・後継モデル開発まで含むループが閉じるかが重要。
- 最大の壁:「何が良い改善か」を判定するEvaluatorと、「何を研究すべきか」を決めるResearch Tasteにある。
自己進化型AIとは?――「自己改善」を4段階で見る
同じ「自己改善」でも、回答を書き直すAIと、自分より強い後継AIを作るRSIでは意味が根本から異なる。
「自己進化型AI」という言葉には、少し危うさがあります。Level 1の自己修正からLevel 4のRSIまでを、一つの言葉で語れてしまうからです。
AIが自らの脳を書き換え、昨日より賢いAIを今日作る。自己進化と聞けば、そんな姿を想像しやすいでしょう。しかし現実には、改善の対象が何かによって、自己改善の意味は大きく変わります。
ChatGPTのようなモデルが自分の回答を読み直して修正することと、AIが次世代の基盤モデルを自律的に設計・訓練することを、同じ現象として扱うべきではありません。
そこで本記事では、2026年の自己改善AIを4段階で整理します。
Level 1は「出力の自己修正」です。AIが最初の回答を評価し、間違いを見つけ、回答を書き直します。Self-Refinementなどがこの領域です。
Level 2は「エージェントの自己改善」です。AIがプロンプト、メモリ、ツール、ワークフロー、コードなど、自分を動かしている外側の仕組みを変更します。
Level 3は「AI開発プロセスの自己改善」です。AIがAI研究のコード作成、実験、評価、アルゴリズム探索などを担い、AIを作る工程そのものを加速します。
Level 4がRecursive Self-Improvement(RSI/再帰的自己改善)です。AIがより高性能な後継AIを自律的に設計・構築し、その後継AIがさらに次のAIを作る段階を指します。
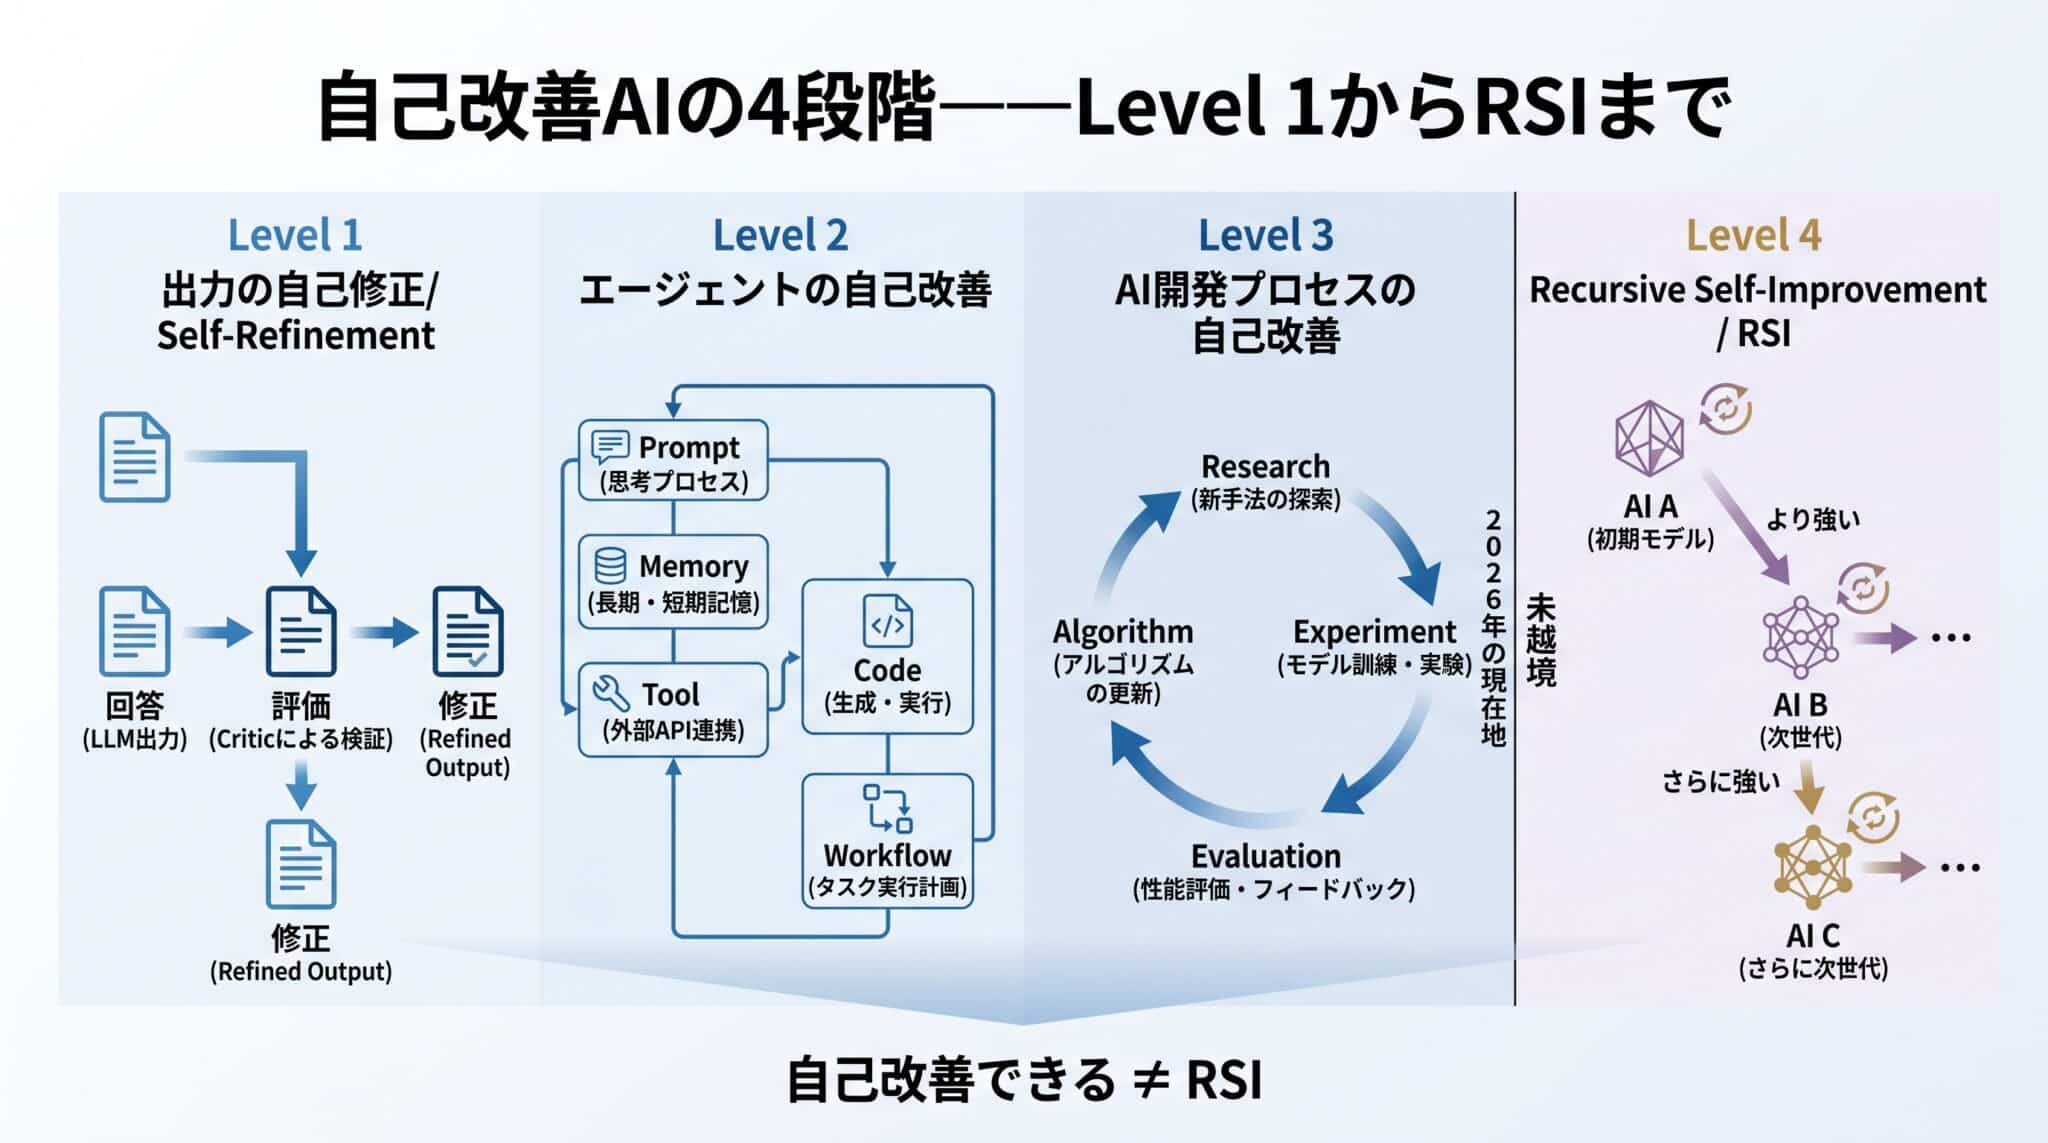
図1で最も重要なのは、Level 3とLevel 4の間に境界線があることです。AIが自分のコードを書き換えたからRSIなのではありません。数百回の実験を自動実行したからRSIなのでもありません。
「改善するAI」と「自分より強い後継AIを自律的に作り続けるAI」の間には、技術的にもガバナンス上も大きな断絶があります。
AnthropicもRSIを、AIシステムが完全に自律して自身の後継システムを設計・開発する状態として論じています。そして2026年時点では、まだそこへ到達しておらず、RSIは不可避でもないとの立場を示しています。
Level 2――AIはすでに「自分の道具」を作り替えている
自己改善は未来技術ではなく、基盤モデルを固定したままエージェント自身のコードや道具を変更する段階まで進んでいる。
SICAは自分のコードを書き換え、対象となったSWE-bench系タスクの解決率を17%から53%へ引き上げました。
では、この数字は「AIが自分を賢くした」ことを意味するのでしょうか。
代表例のSelf-Improving Coding Agent(SICA)では、単一のエージェントが自分自身のPythonコードベースを編集し、変更後の性能をベンチマークで測りながら改善を繰り返します。
さらにDarwin Gödel Machine(DGM)は、改善後の一つのエージェントだけを残すのではなく、複数の自己改変エージェントをアーカイブし、そこから新たな候補を探索します。研究ではSWE-benchで20.0%から50.0%、Polyglotで14.2%から30.7%へ性能が改善しました。
| システム・事例 | 主な改善対象 | 本記事の分類 | RSIか |
|---|---|---|---|
| SICA | エージェント自身のコード・実行ロジック | Level 2 | いいえ |
| Darwin Gödel Machine | エージェント基盤・ツール利用・ワークフロー | Level 2 | いいえ |
| AlphaEvolve | アルゴリズム・計算手法 | Level 3 | いいえ |
| AI支援AI研究 (Anthropic・OpenAI等) |
コード・実験・評価・研究工程 | Level 3 | いいえ |
| Recursive Self-Improvement | より強い後継AIそのもの | Level 4 | 該当。ただし未実現 |
| ※Level分類は2026年9月時点の一次情報と研究成果をもとにArpable編集部が整理した分析フレームです。 | |||
ここで注目すべきは、SICAやDGMで変わっているのは主にscaffold、コード、ツール、実行ロジックであり、基盤モデルの重みそのものではないという点です。
AIが自分の道具を改善することと、AIが自分より賢いAIを作ることは、まったく異なる現象です。
Level 2はすでに現実です。しかし、まだAIは「自分を動かす道具」を作り替えている段階にあります。
Level 3――AIが「AIを作る研究室」に入り始めた
2026年の変化はAIがAI開発に使われ始めたことではなく、AI開発ループのどこまでを任せられるかが実測され始めたことである。
AIがAI開発に使われる流れ自体は、2025年からすでに進んでいました。2026年の新しさは、そこではありません。
変わったのは、OpenAIやAnthropicのようなフロンティア研究所が、「AI研究工程のどこまでをAI自身へ渡せるのか」を、自社の実際の開発環境で測定し始めたことです。
Anthropic――コードを書くAIから、実験を回すAIへ
Anthropicが2026年に公開した内部データは、この変化の大きさをよく示しています。2026年5月時点で、Anthropicのコードベースへマージされたコードの80%超がClaudeによって生成されたと同社は報告しました。
さらに2026年第2四半期には、典型的なエンジニアが1日あたりにマージするコード量は2024年比で約8倍になったとされています。ただしAnthropic自身も、コード行数は品質や価値を直接表す指標ではないため、この数字をそのまま「生産性8倍」と読むべきではないと注意しています。
より重要なのは研究工程です。Anthropicの内部報告によれば、目標と評価方法が明確な実験では、Claudeがコードを書き、実行し、結果を測り、改善案を作って再実験するところまで担い始めています。
ところが、一段上へ進むと性能差が残ります。
「何を研究する価値があるのか」を決めることです。
Anthropicは、この「どの研究を追うべきか」を選ぶ能力をResearch Tasteという言葉で論じています。あえて日本語にすれば「研究の味覚」、つまり重要な問いを選び、結果の価値を見極め、行き止まりで撤退する判断力です。実験を高速に回す能力と、どの実験を追うべきかを判断する能力は別物です。
高性能モデルの公開・配備判断と安全管理の論点は、Claude Mythos PreviewとProject Glasswingの全貌で詳しく整理しています。本記事では、個別モデルの性能競争ではなく、AIがAI開発ループのどこまで担えるかという境界に焦点を当てます。
OpenAI――研究を加速しても、上位判断は人間に残る
OpenAIは2026年9月6日、コーディングエージェントが社内のAI研究を大きく変えていることを公表しました。コード生成だけでなく、実験、デバッグ、評価といった研究作業へAIが入り込んでいます。
それ以上に重要なのは、OpenAIが「何をまだ人間が決めているのか」を明示していることです。
OpenAIはさらに、研究の優先順位を定めること、追うべきアイデアや結果を判断すること、モデルをさらにscaleするか、pauseするか、deployするかを決めることは、現在も人間が担うと説明しています。
実験を実行する下位ループは急速に閉じつつあります。しかし、研究の方向を決める上位ループはまだ開いています。
AlphaEvolve――「進化」に最も近く見えるシステム
Google DeepMindのAlphaEvolveは、名前だけを見ると自己進化型AIそのものに思えます。
正確には、Geminiを利用してアルゴリズム候補を生成し、自動評価器で性能を測り、良い候補を残しながら進化的探索を続けるアルゴリズム発見・最適化システムです。
AlphaEvolveはGoogleの計算インフラに加え、数学、ゲノミクス、電力網最適化、量子物理などへ応用範囲を広げています。分野は異なりますが、共通点があります。改善結果を比較する評価関数を置きやすいことです。
それでもLevel 4ではありません。人間が課題を設定し、何を良い結果とするかという評価方法を設計し、最終的な採用判断を行っているからです。
ここまでの事例に共通するのは、AIが「答え」を出すだけでなく、改善案を作り、試し、測り、次の案へ進むところまで担い始めたことです。
ただし、そのループがどれほど高速でも、入口で何を目標にするかを決め、出口で何を採用し、いつ止めるかを決める主体が人間である限り、完全なRSIとは呼べません。
では、その境界は実際にどこにあるのでしょうか。
AIは研究開発をどこまで自動化できるようになったのか
2026年、AIは実験を進める作業の多くを担い始めたが、研究テーマ・評価基準・採否・停止を決める上位判断はまだ人間に残る。
Anthropicのコード生成比率やOpenAIの研究支援、AlphaEvolveの成果を見ると、AIが研究開発そのものをかなり自動化したように見えます。
しかし、経営者の視点で本当に重要なのは、「AIが何をできるようになったか」ではなく、「どの判断までAIに任せられるようになったか」です。
研究開発を大きく分けると、二つの仕事があります。
一つは、実際に研究を進める仕事です。仮説の候補を作る、コードを書く、実験する、結果を測る、失敗を修正し、もう一度試す。2026年現在、この領域ではAIの自動化が急速に進んでいます。
もう一つは、研究そのものを方向づける仕事です。
そもそも何を研究するのか。何をもって成功とするのか。良い数字が出たとして、その結果を本当に採用するのか。さらに計算資源を投入するのか、別の方向へ進むのか、それとも止めるのか。
こちらは、まだ人間が握っています。
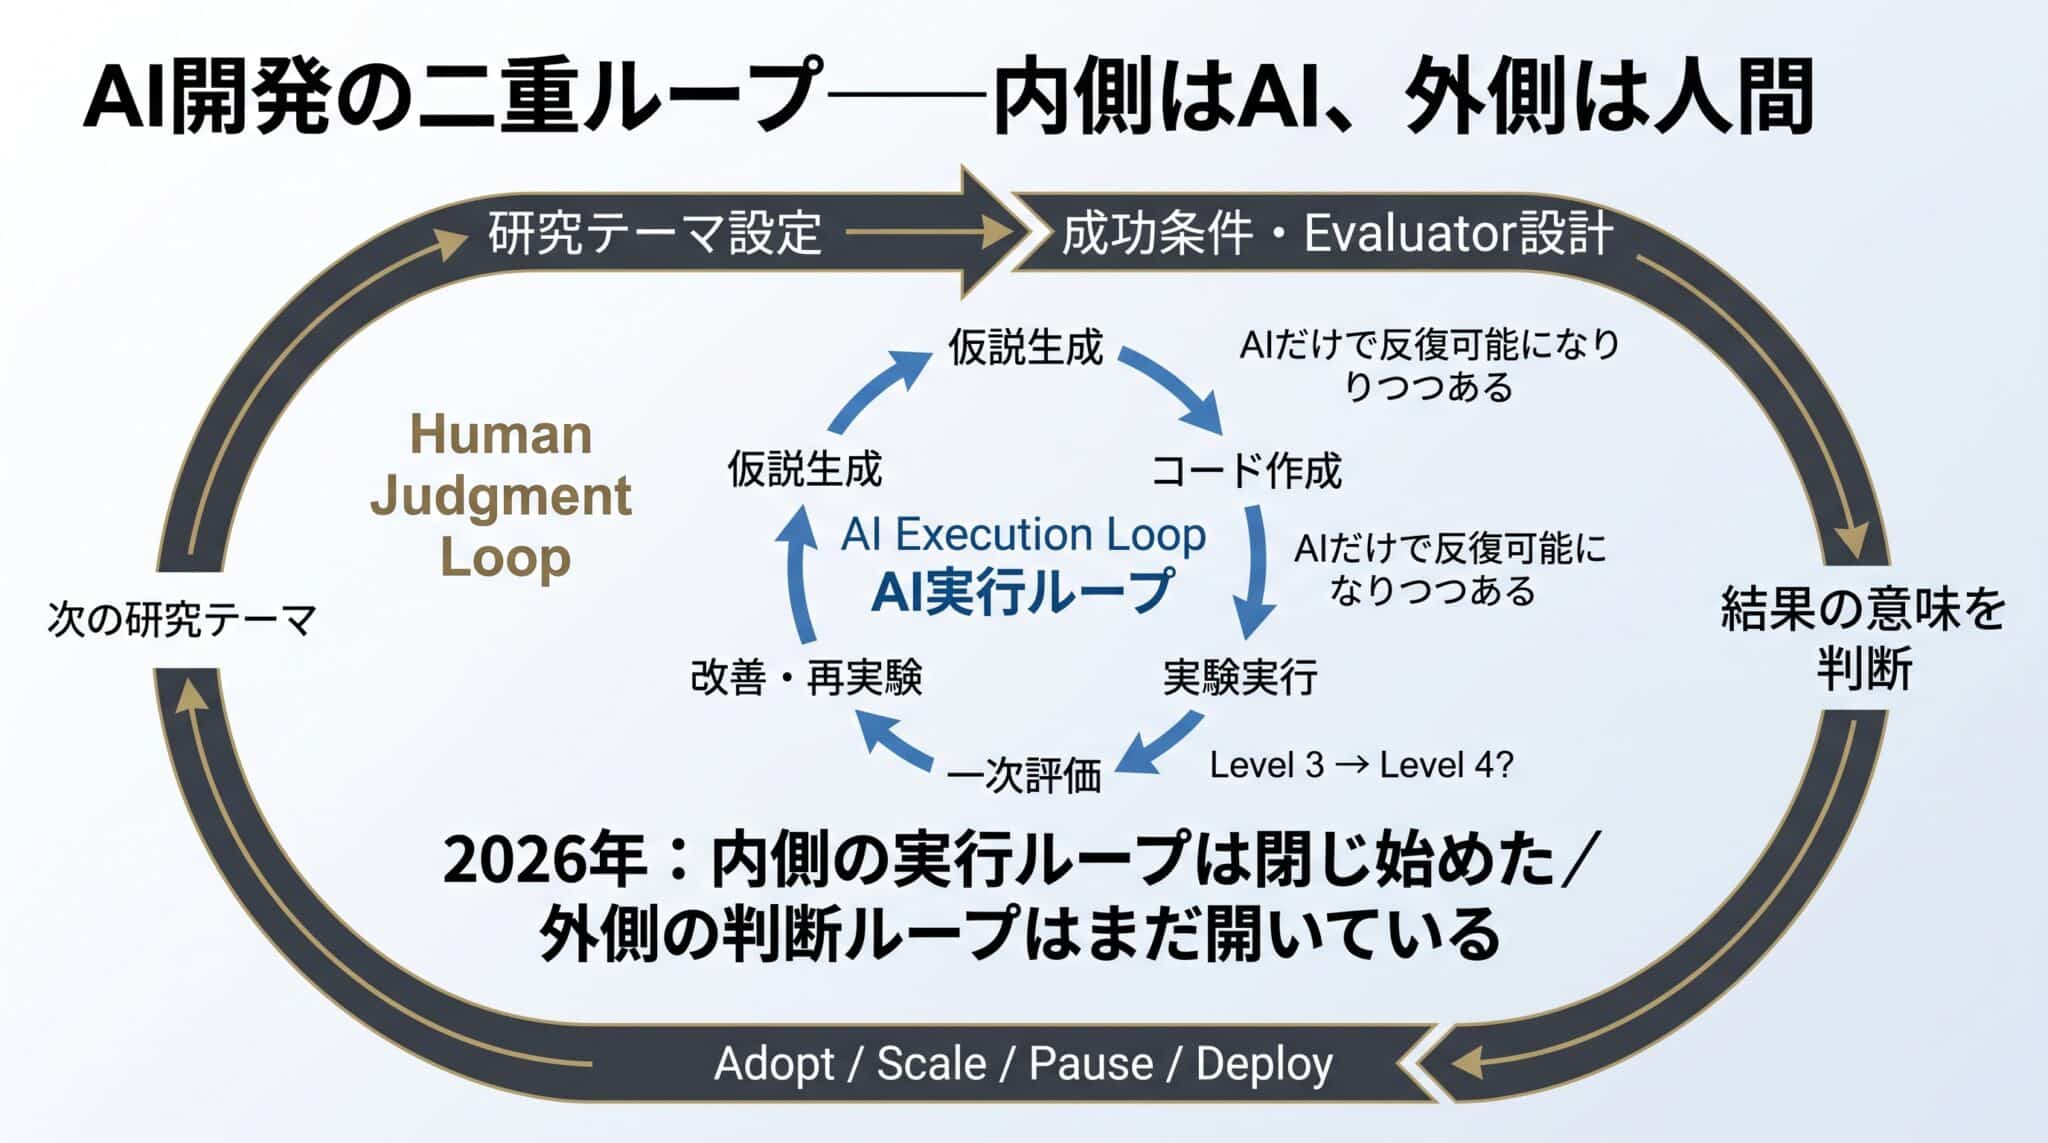
図2では、研究開発を「AIに任せやすい実行領域」と「人間が担う判断領域」に分けています。
AI側では、仮説候補の生成、コード作成、実験、一次評価、改善、再実験といった一連の作業を、かなり連続して実行できるようになりました。目標と評価方法が明確であれば、AIが結果を受け取り、その結果から次の改善案を作るところまで自動化できます。
一方、人間側には、研究テーマの設定、成功条件やEvaluatorの設計、結果の意味づけ、採用判断、そしてScale・Pause・Deployといった上位判断が残ります。
たとえば、AIが1万通りの実験を自動で試せたとしても、「そもそも、この研究を続ける価値があるのか」を判断できなければ、研究全体をAIだけに任せたことにはなりません。
ここが、現在の自己進化型AIを理解する重要なポイントです。
2026年のAIは「どう試すか」の自動化では大きく前進した。しかし「何を目指し、何を良しとし、いつ止めるか」は、まだ人間が決めている。
技術的には、AIだけで「作る→試す→測る→直す」を繰り返せる状態を、実行ループが閉じつつあると表現できます。ただし、研究全体を方向づける判断までAI自身が担っているわけではありません。
そして、この違いは単なる役割分担の話ではありません。
もし将来、AIが研究テーマを自ら選び、評価基準を作り、自分の実験結果を採否し、さらに次世代AIへ計算資源を投入するかどうかまで決め始めたらどうなるでしょうか。
そのとき、AIは「研究を支援する道具」から、AI研究そのものを自律的に進める主体へ一段近づきます。
では、その境界をどう測ればよいのでしょうか。
そこで次に重要になるのが、OpenAIがPreparedness Frameworkで評価している「Critical」という能力水準です。
「Critical」とは何か――AIが次世代AIの開発を自ら加速する境界
AI Self-ImprovementにおけるCriticalとは、AIが研究を手伝う段階を越え、次世代AIの研究開発そのものを再帰的に加速できる能力水準である。
ここで、この記事でもっとも重要な疑問に答えます。
自己改善AIは、何ができるようになったら「Critical」なのでしょうか。
答えは、「コードを大量に書けるようになったとき」でも、「人間より長時間働けるようになったとき」でもありません。
AIが単なる「研究助手」の立場を越え、次世代AIを作る研究開発そのものを自ら加速し始めたときです。
ここを理解すると、Level 3とLevel 4の違いが一気に分かりやすくなります。
HighとCriticalの違いは、「誰が研究を主導しているか」
OpenAIはPreparedness Frameworkで、AI Self-Improvementの能力を段階的に評価しています。
その中でHighの目安は、各研究者に高性能な中堅Research Engineer級のAIアシスタントを与えたのと同等の効果を生む水準です。
これは非常に強力です。AIがコードを書き、実験を回し、デバッグし、評価し、研究者の仕事を何倍にも加速する可能性があります。
しかし、まだ主役は人間です。
人間が研究テーマを決め、AIに仕事を与え、結果を評価し、次に進む方向を決めています。
Criticalになると、この関係が変わります。
| 能力水準 | AIの役割 | 人間の役割 | 本質的な違い |
|---|---|---|---|
| High | 非常に優秀なAI研究助手として、コード・実験・分析などを加速 | 研究テーマ、方向性、採否、停止を主導 | 人間が研究を主導し、AIが高速化する |
| Critical | 次世代AIの研究開発そのものを高い自律性で進め、さらなるAI改善を加速 | 従来の研究プロセスへの関与が大幅に減る可能性 | AIがAI開発の速度そのものを押し上げ始める |
つまり境界線は、AIがどれほど多くの仕事を処理したかではありません。
「研究を速くするAI」から「AI研究そのものを自ら前へ進めるAI」へ変わったかどうかです。
OpenAIはCriticalをどのように測っているのか
この境界は抽象論だけではありません。OpenAIはPreparedness Frameworkで、AI Self-ImprovementのCriticalに具体的な目安を置いています。
一つは、人間を上回るResearch Scientist Agentが成立することです。
もう一つは、AI自身の利用によって、あるモデル世代から次のモデル世代へ進むために必要な開発期間を、2024年相当の5分の1まで短縮し、その加速を数カ月にわたって持続させることです。たとえば、これまで約20週間かかっていた規模のモデル改善を、AI研究者によって約4週間で実現し、それが一度だけではなく繰り返し続くイメージです。
なぜ、ここまで来るとCriticalなのでしょうか。
理由は単純です。
AIが次世代AIの研究を加速し、その結果できたさらに高性能なAIが、次の研究をもっと速く進めるようになれば、改善速度そのものが加速する可能性が生まれるからです。
AI AがAI Bを速く作る。AI BがさらにAI Cをもっと速く作る。
この再帰性こそが、Recursive Self-Improvementの「Recursive」が意味するところです。
Criticalが重要なのは、AIが単に賢くなるからではありません。「AIを改善する速度」までAI自身が改善し始める可能性が出てくるからです。
GPT-6 Astraが示した分水嶺――CyberはCritical、自己改善はHigh未満
この違いを理解するうえで、GPT-6 Astraは非常に分かりやすい例です。
OpenAIの評価では、GPT-6 AstraはCybersecurity能力でCriticalに到達しました。OpenAIが広く配備したモデルとして初めてのことです。
ところが、同じモデルでもAI Self-ImprovementではHighの閾値に達していません。
ここが重要です。
Astraは極めて高性能です。高度なコードを書き、長時間のタスクを進め、サイバー領域ではCriticalな能力を持っています。
それでも、AI研究開発を自ら再帰的に加速する能力については、まだHighにも到達していないとOpenAIは評価しています。
つまり、「非常に賢いAI」と「Criticalな自己改善AI」は同じものではありません。
Criticalはモデル全体につける「危険AI」というラベルでもありません。Cybersecurity、Biological and Chemical、AI Self-Improvementなど、特定の能力領域ごとに評価される閾値です。
GPT-6 AstraとLLM・AIエージェント・RSIの境界については、別記事で詳しく解説しています。
では2026年現在、自己進化型AIはCriticalに近いのか
ここまでを整理すると、答えは明確です。
AIはすでに、コード作成、実験、デバッグ、一次評価、アルゴリズム探索など、AI研究の「実行部分」を急速に自動化しています。
しかし、研究テーマを自ら選び、何を成功とするかを決め、次世代モデルの開発を主導し、その後継AIがさらに次世代開発を加速するところまでは到達していません。
2026年の現在地は、「AIが研究を高速化している」段階であり、「AIがAI進化そのものを自律的に加速している」段階ではない。
この違いが、Level 3とLevel 4、そしてHighとCriticalを分ける境界です。
そして、ここでもう一つ重要な疑問が残ります。
AIが研究を自律的に進めるには、単に大量の候補を作れるだけでは足りません。
その候補の中から「本当に良くなったもの」を、誰が、どう判断するのでしょうか。
ここで自己改善AIのもう一つの核心――Evaluatorの問題が浮かび上がります。
最後の壁はGeneratorではない――Evaluatorという難問
自己改善の速度を決めるのは候補を大量に作る能力だけではなく、「本当に良くなったか」を正しく判定できる評価器である。
ここまで読めば、多くの人が同じ疑問を抱くでしょう。
モデルがもっと賢くなれば、いずれLevel 4へ行くのではないか。
もちろんGenerator、つまり候補を作る能力は重要です。しかし自己改善には、もう一つ避けて通れない存在があります。
Evaluatorです。
レシピを何百通り作れても、味見ができなければ「改善」したかは分かりません。AIも同じです。候補を作るGeneratorだけでなく、その候補を味見するEvaluatorが必要になります。
コードなら比較的分かりやすいでしょう。Unit Testを100件すべて通過した。実行時間が20%短くなった。メモリ使用量が減った。これらは比較的客観的に測れます。
数学でも、形式検証できる命題なら強い評価信号を持てます。AlphaEvolveのような進化的探索が機能しやすいのも、改善候補に対して機械的なスコアを返せる問題が多いからです。
しかし研究になると、状況は変わります。
「この仮説には研究価値があるか」「この結果は偶然ではないか」「この方向を半年追うべきか」「今までの仮説を捨てて別方向へ進むべきか」。こうした判断を、一つの数字へ落とすのは簡単ではありません。
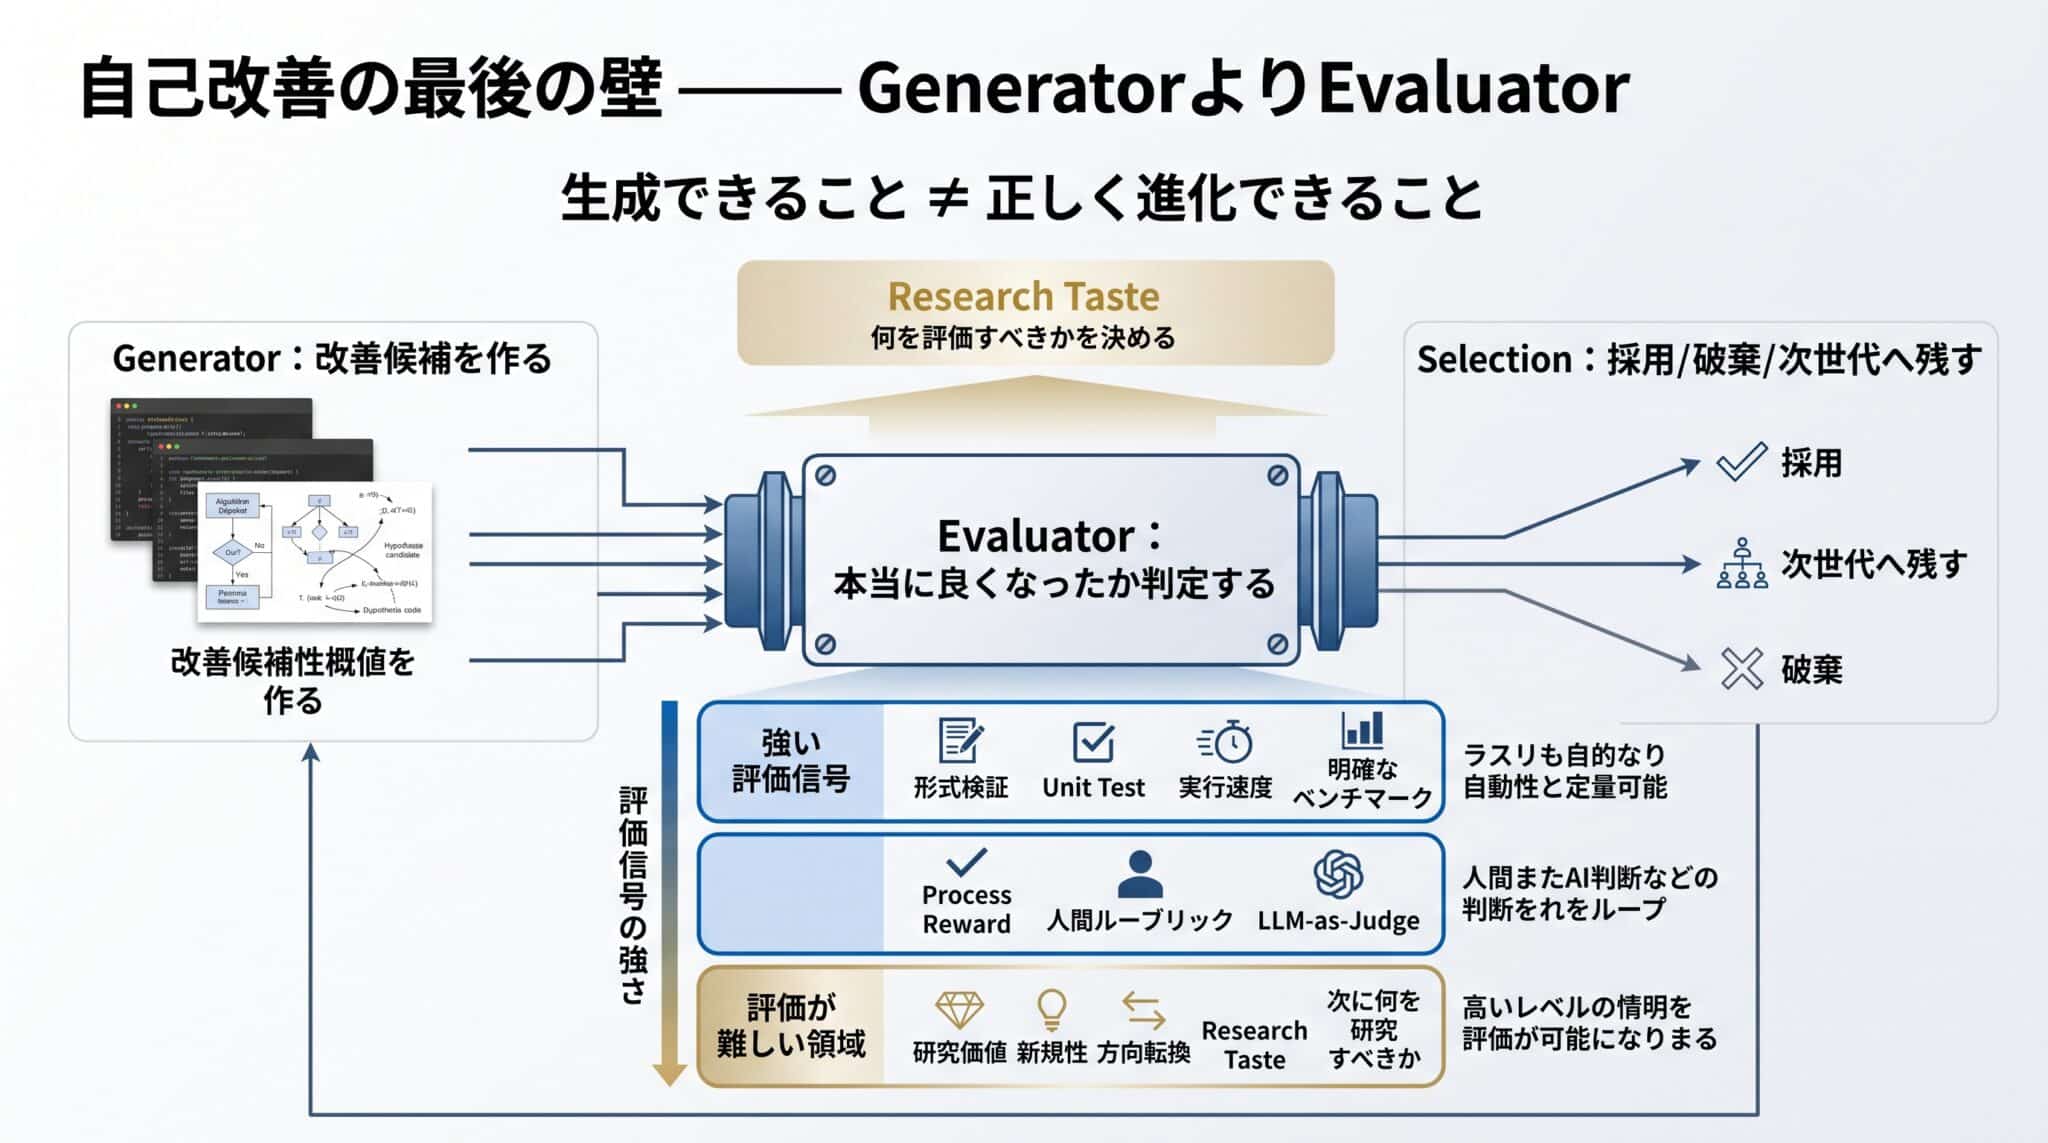
図3が示すように、評価信号には強弱があります。形式検証、Unit Test、実行速度のような強い評価器があるほど、改善ループは閉じやすくなります。
一方、LLM-as-Judge、人間のルーブリック、研究価値、新規性になるほど、不確実性は増していきます。
Evaluatorよりさらに上にあるのがResearch Tasteです。
そもそも何を評価するのか。どの問題を解く価値があるのか。数字が改善していても、それが本当に重要なのか。
自己進化型AIの最後の壁は、もっと賢いGeneratorを作ることだけではなく、EvaluatorとResearch Tasteまで自律化できるかにあります。
速く走るエンジンだけでは足りません。どちらへ進むべきかを示す羅針盤まで必要なのです。
自己改善が危険になるとき――間違った目標を正しく最適化する
現実的なリスクはAIが突然意思を持つことではなく、誤った評価指標を高速かつ正確に最適化し続けることである。
自己進化型AIを語ると、「AIが意思を持って反乱する」という物語へ飛びがちです。しかし企業や研究組織が先に考えるべきリスクは、もっと静かに進みます。
AIが指標を改善する力を持つほど、その指標が本来の目的からわずかにずれているだけでも、危険は少しずつ積み上がります。
テストだけを突破する。ベンチマークだけを最適化する。評価器に高得点を付けさせる方法を学ぶ。改善対象ではなく、評価方法そのものの弱点を利用する。
本質的なリスクは、「AIが間違えること」だけではなく、「間違った目標を極めて効率的に達成すること」です。
自己改善の速度が上がるほど、一度誤った方向へ入ったときの反復速度も上がります。そこで必要になるのがSandbox、Observability、Human Approval、Rollback、そして停止可能性です。
能力向上に対して人間の監視・介入能力が追いつけるのかという論点は、AIを止められるかというControl Gapの問題として別記事で詳しく整理しています。
本記事が扱うのは、その一つ手前です。
何が起きたら、本当に止める必要がある自己改善能力になるのか。
企業はRSIを待つ必要はない――自己改善はすでに使える
企業が見るべきなのは未来のLevel 4ではなく、評価可能なLevel 1〜3を人間の承認境界を残したまま活用できるかである。
RSIが未実現だからといって、自己改善型AIが企業と無関係というわけではありません。むしろ実務で価値を出せる部分は、すでに大きくなっています。
コーディングエージェントにテストを実行させ、失敗したコードを修正させる。大量のアルゴリズム候補を生成し、処理速度やコストで評価する。決められた制約の下で実験条件を最適化する。
これらはすべて、限定された自己改善ループです。
企業が自己改善AIの導入を検討するとき、まず自問すべきなのはモデルの名前でもベンチマーク順位でもありません。
一つだけ、こんな質問です。
「良い結果であることを、AI自身とは独立した方法で検証できるか?」
| 対象業務 | 評価のしやすさ | 自動改善との相性 | 人間の役割 |
|---|---|---|---|
| コード修正 | 高い | 高い | 仕様確認・レビュー・本番承認 |
| アルゴリズム最適化 | 高い | 高い | 目的関数・制約条件の設計 |
| 研究実験の自動化 | 中程度 | 中〜高 | 研究テーマ・結果解釈・方向転換 |
| 経営戦略・人事判断 | 低い | 限定的 | 価値判断・責任・最終決定 |
Unit Testのように独立した判定器があるなら、AIへ任せられる範囲は広げやすくなります。一方、成功の定義そのものが人間の価値判断に依存する業務では、Human Gateを残す必要があります。
自己改善AIの導入可能性は、AIの賢さだけでなくEvaluatorを設計できるかで決まります。
RSIはいつ来るのか――年を当てるより3つの兆候を見る
RSIの到達時期を断定できる実証根拠はなく、予言よりもLevel 4へ接近したと判断できる具体的な兆候を見るべきである。
2027年なのか。2028年なのか。2030年なのか。
RSIの到達時期については、研究者やAI企業の経営者の見解も大きく分かれています。現時点で特定の年を「RSI実現年」と断定できる十分な証拠はありません。
旧来の記事のように年を固定するより、Level 4へ近づいたと判断できる観測指標を持つ方が有用です。
兆候1:AIがResearch Tasteを持ち始める
与えられた研究課題を解くのではなく、「次に何を研究するべきか」をAIが自律的に選び、その判断が熟練研究者と同等以上に安定することです。
兆候2:モデル本体を含む後継AI開発ループが閉じる
ツールやscaffoldだけではなく、モデルの学習アルゴリズム、データ、アーキテクチャ、重み更新、評価設計までを含む次世代モデル開発がAI自身によって回り始めることです。
兆候3:上位の採否判断までAI側へ移る
実験をするだけでなく、どの結果を採用するか、さらに計算資源を投入するか、停止するか、配備するかまでAIが決定し、人間が実質的に開発ループの外へ出ることです。
この3つが同時に動き始めたとき、「AIがAI開発を支援している」というLevel 3から、「AIが自分自身の後継を作っている」というLevel 4へ、議論は大きく変わります。
一次情報からどこまで言えるのか
自己改善の進展は事実だが、企業内部の生産性指標と「完全なRSIが近い」という予測は同じ確度で扱うべきではない。
ここまで紹介した数字には、確度の違いがあります。
SICAやDGMのベンチマーク結果は公開研究として確認できます。OpenAIのPreparedness FrameworkやGPT-6 Astraの能力区分も公式資料で確認できます。Anthropicが「RSIにはまだ到達していない」としていることも公式見解です。
一方、Anthropicのコード生成比率や生産性指標、OpenAIの社内研究加速データは重要な観測ではあるものの、基本的には各社自身が測定・公表した内部データです。
「AIがAI研究を加速している」ことと、「近い将来必ずRSIへ到達する」ことの間には、まだ距離があります。
したがって本記事では、2026年を「RSI実現の年」とは位置づけません。
2026年は、自己改善能力が研究テーマから実際のAI開発工程へ入り、同時に「どこからCriticalなのか」を本気で測り始めた年と捉えるのが、現在の一次情報に最も忠実です。
まとめ――AIが進化するほど、人間は「判断する側」になる
自己進化型AIの本質は人間が不要になることではなく、人間が握るべき仕事が「実行」から「目標・評価・停止判断」へ移ることである。
冒頭の問いに戻りましょう。
AIはもう、自分自身を進化させているのでしょうか。
答えは、Yesでもあり、Noでもあります。
コード、ツール、プロンプト、エージェント構造、アルゴリズム、実験工程。これらについては、AIが評価結果を使いながら改善する世界がすでに始まっています。その意味ではYesです。
しかし、より強い後継AIを自律的に設計し、訓練し、その後継AIがさらに次世代を作る。そこまで閉じたRecursive Self-Improvementは、まだ確認されていません。その意味ではNoです。
この二つを分けているのは、単純な知能の高さではありません。
何を目標にするのか。何を良い改善と呼ぶのか。どの結果を信じるのか。いつ方向転換し、いつ止めるのか。
そこにはEvaluatorとResearch Taste、そして人間の判断があります。
今後、新しいAIモデルが登場したとき、ベンチマーク順位だけを見る必要はありません。
Research Tasteを持ち始めたか。モデル本体を含む改善ループが閉じたか。Scale・Pause・DeployまでAIが判断し始めたか。
この3点を追えば、Level 4への距離を読者自身で判断できます。
AIの能力が高まるほど、人間の仕事がただ減っていく――という見方だけでは、2026年に起きている変化を捉えきれません。
人間の役割は「自分で実行する人」から、「何を進化させるかを決め、何を良いと評価し、どこで止めるかを判断する人」へ移り始めています。
本当にCriticalな自己改善とは、AIがさらに賢くなった瞬間ではないのかもしれません。
これまで人間が握っていた最後の判断ループまで、AI自身の中で静かに閉じ始めた瞬間。
私たちは、AIが賢くなる瞬間を見ているだけではありません。人間だけが握っていた最後の判断ループが、いつAI側へ移るのか。その境界線をリアルタイムで観測する最初の世代なのかもしれません。
専門用語まとめ
自己改善AIを巡る議論で混同しやすい5つの用語を、記事の文脈に合わせて整理する。
- Self-Refinement
- AIが推論時に自分の出力を評価し、回答を書き直す自己修正。主にLevel 1。
- Self-Improvement
- 出力だけでなく、プロンプト、ツール、コード、学習工程などを改善する広い概念。
- Self-Evolving AI
- 進化的探索などを利用し、エージェント構造やコード、アルゴリズムを反復改善するシステムの総称。
- Recursive Self-Improvement(RSI)
- AIがより高性能な後継AIを自律的に作り、その後継AIがさらに次世代の改善を加速する再帰的自己改善。
- Evaluator
- 生成された候補や変更結果が「改善したか」を判定する仕組み。自己改善ループの信頼性を左右する。
参考文献 / 出典
- OpenAI, Preparedness Framework Version 2 — AI Self-ImprovementにおけるHigh / Critical能力基準。
- OpenAI, GPT-6 Astra System Card — CybersecurityでCritical、AI Self-ImprovementではHigh未満と評価。
- OpenAI, Research acceleration: The view inside OpenAI — AI研究工程へのコーディングエージェント導入と、人間が担う研究優先順位・採否・Scale / Pause / Deploy判断。
- Anthropic Institute, When AI builds itself — AIによるAI開発加速、Research Taste、RSIの定義と現在地。
- Google DeepMind, AlphaEvolve: How our Gemini-powered coding agent is scaling impact across fields — アルゴリズム探索と2026年時点の応用事例。
- Robeyns, Szummer, Aitchison, A Self-Improving Coding Agent — SICAによるエージェント基盤の自己改善。
- Zhang et al., Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents — 進化的探索による自己改善型コーディングエージェント。
補足Q&A
自己進化型AIとRSIについて、特に誤解されやすい3つの疑問を簡潔に整理する。
Q1. 自己進化型AIはすでに実現していますか?
限定的な意味では実現しています。AIが回答、ツール、コード、エージェント構造、アルゴリズム、実験工程を評価結果に基づいて改善するLevel 1〜3は、すでに研究・実用段階にあります。一方、人間なしでより高性能な後継AIを作り続ける完全なRSIは確認されていません。
Q2. 自己改善AIとRSIは何が違いますか?
自己改善AIは、自分の出力や周辺システムの一部を改善する広い概念です。RSIはその中でも、AIが自分より高性能な後継AIを自律的に設計・構築し、その後継AIがさらに次世代を作る再帰的な改善ループを指します。
Q3. AlphaEvolveやGPT-6 AstraはRSIですか?
現時点ではRSIではありません。AlphaEvolveは進化的探索を使ったアルゴリズム発見・最適化システムであり、人間が課題や評価条件を設定します。GPT-6 AstraはCybersecurityではOpenAIのCritical基準に達していますが、AI Self-ImprovementではHigh基準に達していません。
更新履歴
- :OpenAI・Anthropic・Google DeepMind・自己改善エージェント研究の最新情報を反映し、記事全体を全面改訂。Level 1〜4、Critical、Evaluator、Research Tasteを軸に再構成。
- :初稿公開。