※本記事は継続的に最新情報へアップデートしています。
KVキャッシュとは、LLMが過去のトークンで計算したKeyとValueを一時保存し、次のトークンを生成するたびに同じ計算をやり直さないための仕組みである。そして100万トークン級の長文では、この一時記憶そのものが巨大化し、速度・メモリ・同時処理数を左右する。
100万トークン対応とは、100万トークンを正確に理解できるという意味ではない。大きなコンテキストウィンドウは「大きな机」を持っているだけであり、その机に置いた情報を探し、結びつけ、素早く処理できるかは、モデルの長文理解力とKVキャッシュを含む推論基盤の設計で決まる。
資料を「まとめて全部入れればよい」と考えているなら、見直すべきなのはモデルだけではない。長文LLMを使いこなす鍵は、何を渡し、何を探させ、何を記憶させるかを設計する力である。
KVキャッシュは、LLMの「理解力」を高める仕組みではありません。過去の計算結果を再利用して推論を高速化する一時メモリであり、長文になるほどVRAMやメモリ帯域を消費します。長い資料で起きる問題は、次の3層に分けて考えると原因を切り分けやすくなります。
- モデルの長文理解力:重要情報を見つけ、複数箇所を結びつけられるか
- コンテキストの設計:不要情報や矛盾を混ぜず、AIが使いやすい形で渡しているか
- 推論インフラ:長い入力や会話履歴を、どれだけ速く、安く処理できるか
つまり、KVキャッシュが解くのは主に「再計算・速度・メモリ・同時処理」の問題です。一方、重要条件の見落としや矛盾した回答は、長文理解力やコンテキスト設計の問題です。KVキャッシュを理解すると、100万トークン時代の「速さの限界」と「理解の限界」を切り分けられます。
100万トークンの机に、300ページの資料を置いたらどうなるか
「入力できる」と「正確に使える」の間には、思った以上に大きな距離がある。
100万トークン級のコンテキストが使えるようになると、「全部入れればAIが全部覚えてくれる」と考えたくなります。しかし実際には、長文になるほど二つの別問題が表面化します。一つは「必要な情報を正しく使えるか」、もう一つは「その大量の情報を現実的な速度とメモリで処理できるか」です。
ここで、よくある失敗を一人の担当者に重ねて描いてみます(架空の事例です)。
経営会議を控え、三浦ナオは300ページを超える市場調査、顧客ヒアリング、契約書、技術仕様書をLLMへ読み込ませました。使用したモデルは、100万トークン級の長いコンテキストに対応しています。
「これなら、全部まとめて扱える」――そう考えていたのです。
最初の回答は的確でした。市場分析も競合評価も、提案の方向性も大きく外していません。
ところが最終確認で、契約書の中央にあった重要な解約条件が、提案書から抜け落ちていることに気づきます。
追加で確認すると、今度は別の資料に書かれた古い条件を根拠として答えました。質問を重ねるほど回答開始までの待ち時間も長くなり、会話の前半で決めた前提まで揺らぎ始めます。
「100万トークンも入るのに、なぜ重要なことを見落とすのだろう」
あなたやあなたのチームでも、同じような違和感を覚えたことはないでしょうか。
GoogleのGemini API公式ガイドでは、100万トークン以上のコンテキストを扱えるモデルが案内されています。一方、長文中から一つの情報を探す課題と、複数情報を探して結びつける課題では難しさが異なります。また、入力が長いほど、最初のトークンが返るまでの時間も一般に長くなります。
コンテキストサイズは「処理できる上限」であって、長文理解力・正確性・応答速度の保証書ではありません。

では、この「待ち時間」と「メモリの重さ」の正体は何でしょうか。その鍵を握るのが、本記事の後半で扱うKVキャッシュです。
「入る・探せる・考えられる・速く返せる」は別の性能
最大コンテキスト長だけを見ても、実際の長文性能や使い勝手は判断できない。
コンテキストウィンドウとは何か
コンテキストウィンドウとは、LLMが一回の処理で参照できる入力、指示、会話履歴、生成中の出力などが収まる作業領域です。
100万トークン対応であれば、形式上は非常に長い情報を入力できます。しかし、その全範囲から情報を同じ精度で見つけ、複数箇所を結びつけて判断できるとは限りません。
コンテキストウィンドウの大きさは作業机の広さです。資料を探す力、読み解く力、処理する速さまで同じ数字で表しているわけではありません。
| 段階 | 確認する能力 | 典型的な問題 |
|---|---|---|
| 入る | 何トークンまで入力できるか | 上限を超えると切り捨てやエラーになる |
| 探せる | 必要な情報を長文中から発見できるか | 中央や目立たない場所の条件を見落とす |
| 考えられる | 複数箇所を結びつけ、矛盾を整理できるか | 資料ごとの情報を統合できない |
| 速く返せる | 現実的な時間と費用で処理できるか | 初動が遅く、入力料金が膨らむ |
長文中から一つの文字列を見つけられても、離れた場所にある複数の条件を組み合わせて判断できるとは限りません。
長文評価ベンチマークのRULERは、単純な情報検索だけでなく、複数情報の追跡や集約を評価します。LongBench v2も、複数文書、長い会話、コード、構造化データなど、現実に近い長文推論の難しさを扱います。
「100万トークン対応」と「100万トークンを使った複雑な判断が得意」は、同じ意味ではないのです。
長文で回答品質が落ちる5つの理由
長文の問題は単純な容量不足ではなく、情報の位置・量・関係・矛盾から生まれる。
中央の重要情報が埋もれる「Lost in the Middle」
長文LLMには、文章の冒頭と末尾の情報を使いやすく、中央付近の情報を見落としやすい傾向があります。関連情報の位置を変えただけで回答性能が変化する現象は「Lost in the Middle」と呼ばれます。
モデルは改善を続けていますが、重要条件を数百ページの中央へ一度だけ置き、そのまま正確に拾ってくれることを前提にするのは危険です。
不要な情報が重要情報を薄める
質問と関係のない資料が増えるほど、LLMは重要情報と周辺情報を区別しなければなりません。人間でも、10枚から条件を探す場合と1,000枚から探す場合では負担が違います。
入力できるからといって、入力した方がよいとは限りません。
古い情報と新しい情報が衝突する
旧価格と新価格、改訂前後の契約条件、検討案と正式決定が同時に入ると、LLMが古い情報を根拠にする可能性があります。文書の日付、版、優先順位を利用者側で明示する必要があります。
複数箇所を結びつける必要がある
解約条件を一つ探す質問より、解約条件、最低利用期間、海外拠点の例外を組み合わせて契約リスクを判断する質問の方が難しくなります。必要なのは検索だけでなく、長文をまたぐ推論能力です。
会話履歴そのものがノイズになる
長い会話には、否定済みの仮説、訂正前の数字、雑談、重複した説明も残ります。古い前提と新しい指示が競合すれば、現在の目的が埋もれます。
ここまでの原因は、どれも「AIが何を参照し、何を残しているか」に関係します。ところが、パラメータ、会話履歴、RAG、KVキャッシュは、同じ「記憶」と呼ばれていても役割が異なります。
LLMの「記憶」は一つではない
パラメータ、コンテキスト、RAG、KVキャッシュ、物理メモリは異なる役割を持つ。
「AIの記憶」という言葉が混乱を招く最大の理由は、パラメータ、コンテキスト、RAG、KVキャッシュ、物理メモリがすべて別物だからです。特にKVキャッシュは、AIが知識を覚える場所ではなく、推論中の再計算を減らすための作業メモリです。ここを切り分けると、長文LLMの問題が見えやすくなります。
| 仕組み | 人間に例えると | 利用者への影響 |
|---|---|---|
| パラメータ | 身につけた知識や技能 | 推論力、文章力、専門性 |
| コンテキスト | 机の上の資料 | 一度に扱える資料や会話量 |
| Embedding・インデックス | 図書館の索引 | 関連資料を探す精度と速さ |
| RAG | 資料を運ぶ司書 | 外部・社内情報を選んで回答へ渡す |
| KVキャッシュ | 読んだ箇所に付けた一時メモ | 応答速度、メモリ、同時処理数 |
| HBM・DRAM・SRAM・SSD | 作業台、引き出し、書庫 | 速度、容量、費用 |
パラメータはモデルが学習で身につけた能力であり、一度に読める量ではありません。パラメータ数が多くても、最新情報、長文理解、応答速度が自動的に優れるわけではありません。
RAGは外部文書から必要な部分を探し、LLMへ渡す仕組みです。コンテキストが「机に置ける量」なら、RAGは「書庫から資料を選ぶ仕組み」です。100万トークン対応でも、大量かつ更新頻度の高い文書にはRAGが有効です。詳しくはRAG完全ガイドをご覧ください。
HBMやSRAMは、重みや一時データを物理的に置く場所です。一般利用者が細かなメモリ階層を比較する必要はありませんが、長いコンテキストの性能が、記憶容量とデータを運ぶ速さにも左右されることは押さえておくべきです。半導体ごとの設計思想は、AI半導体とは?GPU・ASIC・FPGAの役割と選び方で整理しています。
では、その「推論中の作業メモリ」は、いつ作られ、なぜ長文ほど重くなるのでしょうか。答えは、LLMが回答を書き始める前の入力処理にあります。
なぜ長い資料を入れると反応が遅くなるのか|PrefillとDecode
LLMは回答を書く前に入力トークンを処理してKVキャッシュを作り、その後の生成で再利用する。
| フェーズ | 行っていること | 利用者が感じる現象 |
|---|---|---|
| Prefill | 入力トークンを処理し、後続の生成で参照するKVキャッシュを作る | 回答開始までの待ち時間 |
| Decode | KVキャッシュを参照しながら一語ずつ生成する | 回答が表示される速度 |
この2段階は、使う資源の性質が違います。一般に、Prefillは大量の入力を並列処理するため演算性能の影響を受けやすく、Decodeは一語ずつ生成しながらモデルの重みやKVキャッシュを読み出すため、メモリ帯域の影響を受けやすくなります。この違いが、後半のPrefill/Decode分離や、HBMの帯域が重視される理由につながります。
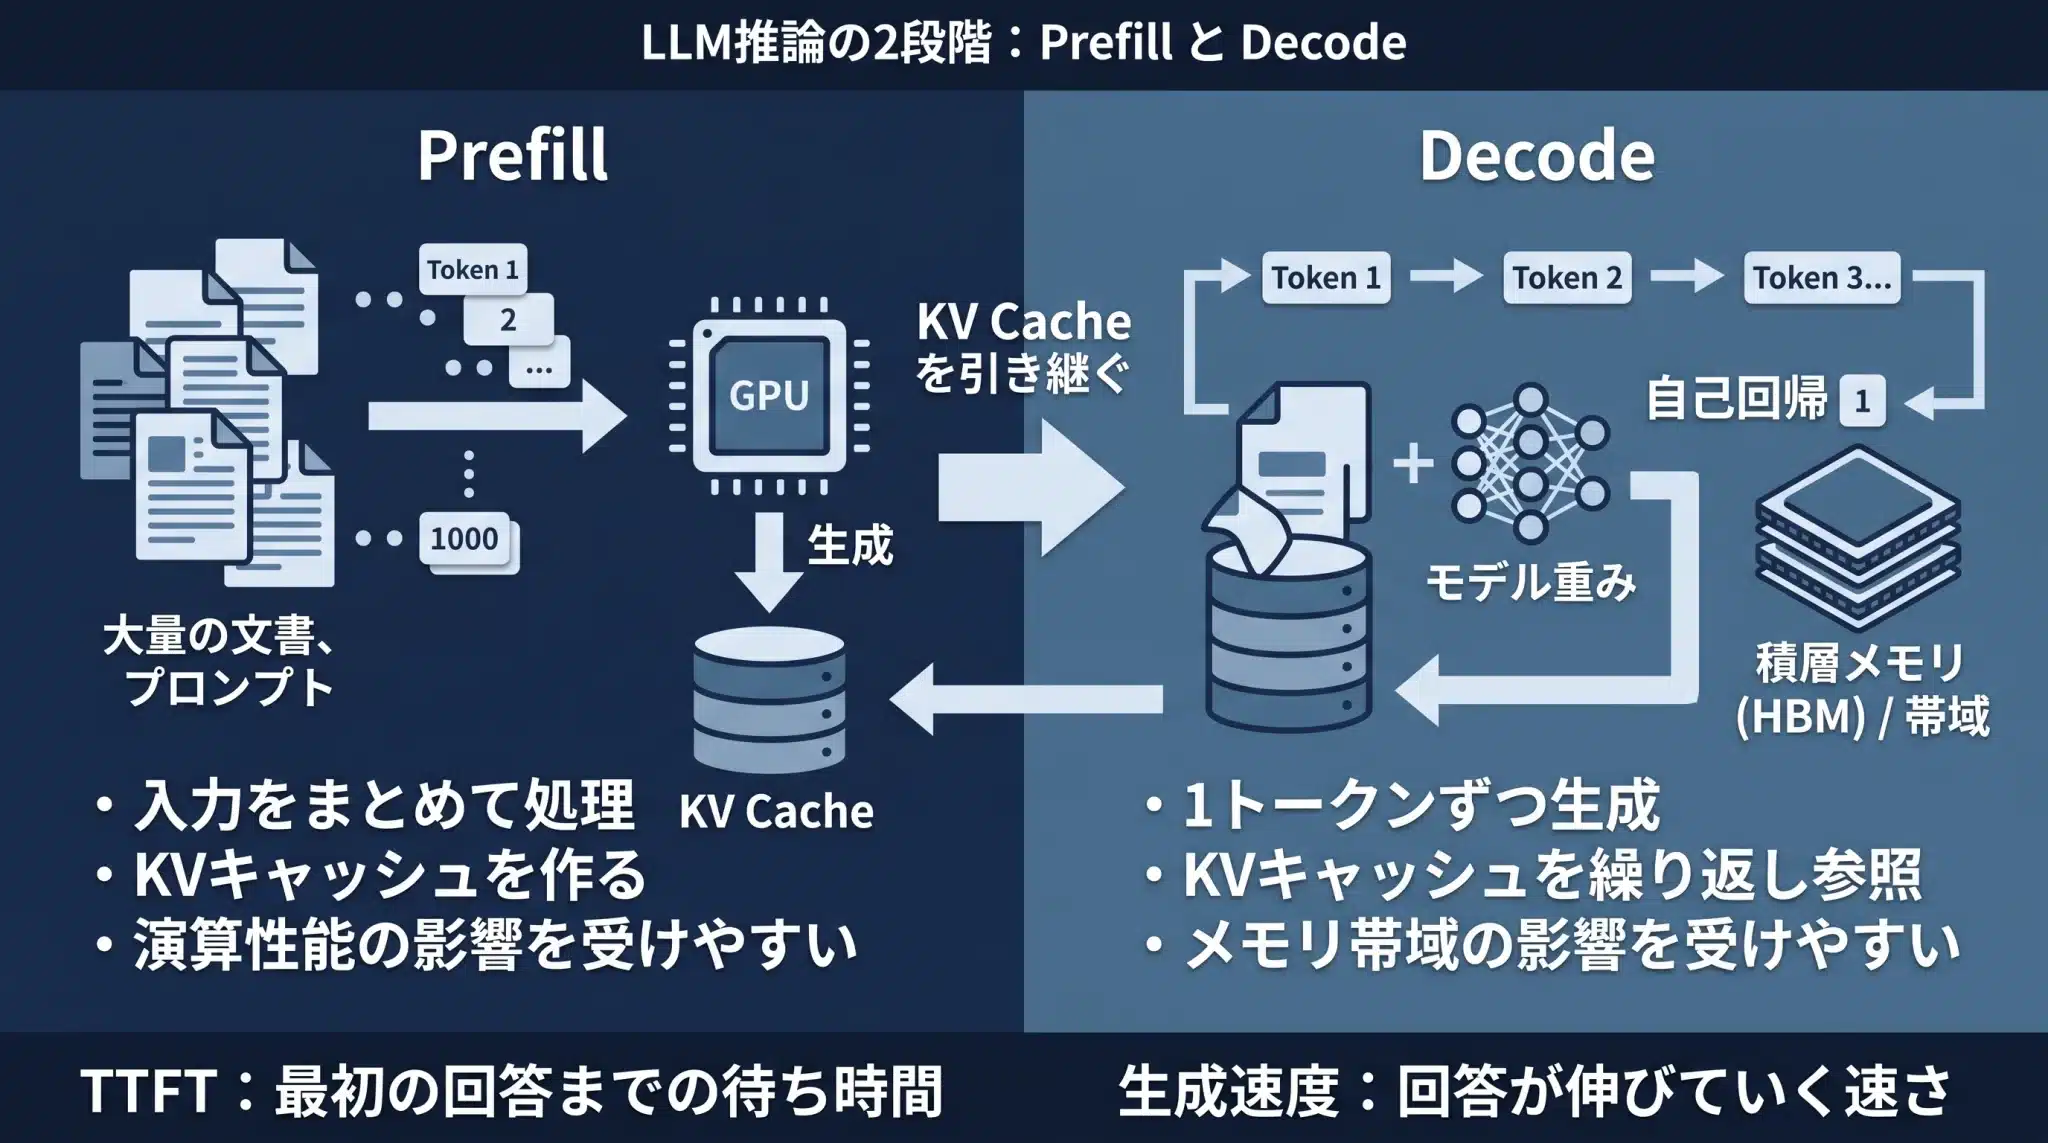
300ページの資料を渡すと、LLMは回答前に入力トークンを処理し、後続の生成で参照するKVキャッシュを作ります。このPrefillは、入力が長いほど処理量も増えるため、短い質問より最初の回答まで時間がかかります。
KVキャッシュとは?AIが過去を読み直さないための一時メモ
KVキャッシュは過去の計算結果を保存し、次の一語を作るたびの再計算を減らす仕組みである。
KVキャッシュ(Key-Value Cache)とは、Transformerが過去のトークンについて計算したKeyとValueをメモリ上へ保存し、次のトークンを生成するときに再利用する仕組みです。キャッシュがなければ、生成のたびに過去部分の計算を繰り返す必要があります。KVキャッシュは「AIの知識」ではなく、「過去を何度も計算し直さないための短期作業メモリ」です。
机の比喩でいえば、KVキャッシュは、一度読んだページを毎回読み直さずに済むよう、要点を残しておく付箋です。
仕組みをもう少し具体的に見ましょう。Transformerは新しいトークンを生成するとき、過去のトークンを参照します。たとえるなら、Keyは「どの位置にどんな情報があるか」を探すための見出し、Valueは「見つかったときに取り出す中身」です。この二つを毎回計算し直さず保存しておくのがKVキャッシュです。
保存量は、おおまかに次の式で見積もれます。
KVキャッシュ量 ≒ 2(KeyとValue)× 層数 × KVヘッド数 × ヘッド次元 × トークン数 × 1要素のバイト数
Llama 3.1 70Bと同等の構成(80層、KVヘッド8、ヘッド次元128、BF16/FP16で1要素2バイト)で単純計算すると、1トークンあたり約0.328MBです。128,000トークンで約41.9GB、同じ構成を100万トークンまで単純外挿すると約327.7GBになります。これは1リクエスト分の理論値であり、共有がない単純な場合は同時リクエスト数が増えるほど必要量も増えます。
※Arpable編集部による10進換算の理論計算。Llama 3.1 70Bの公式最大コンテキスト長は131,072トークンであり、100万トークンは規模感を示すための単純外挿です。実際の使用量は、モデル構造、KVキャッシュの精度、並列化、Prefix Cachingなどの実装によって異なります。
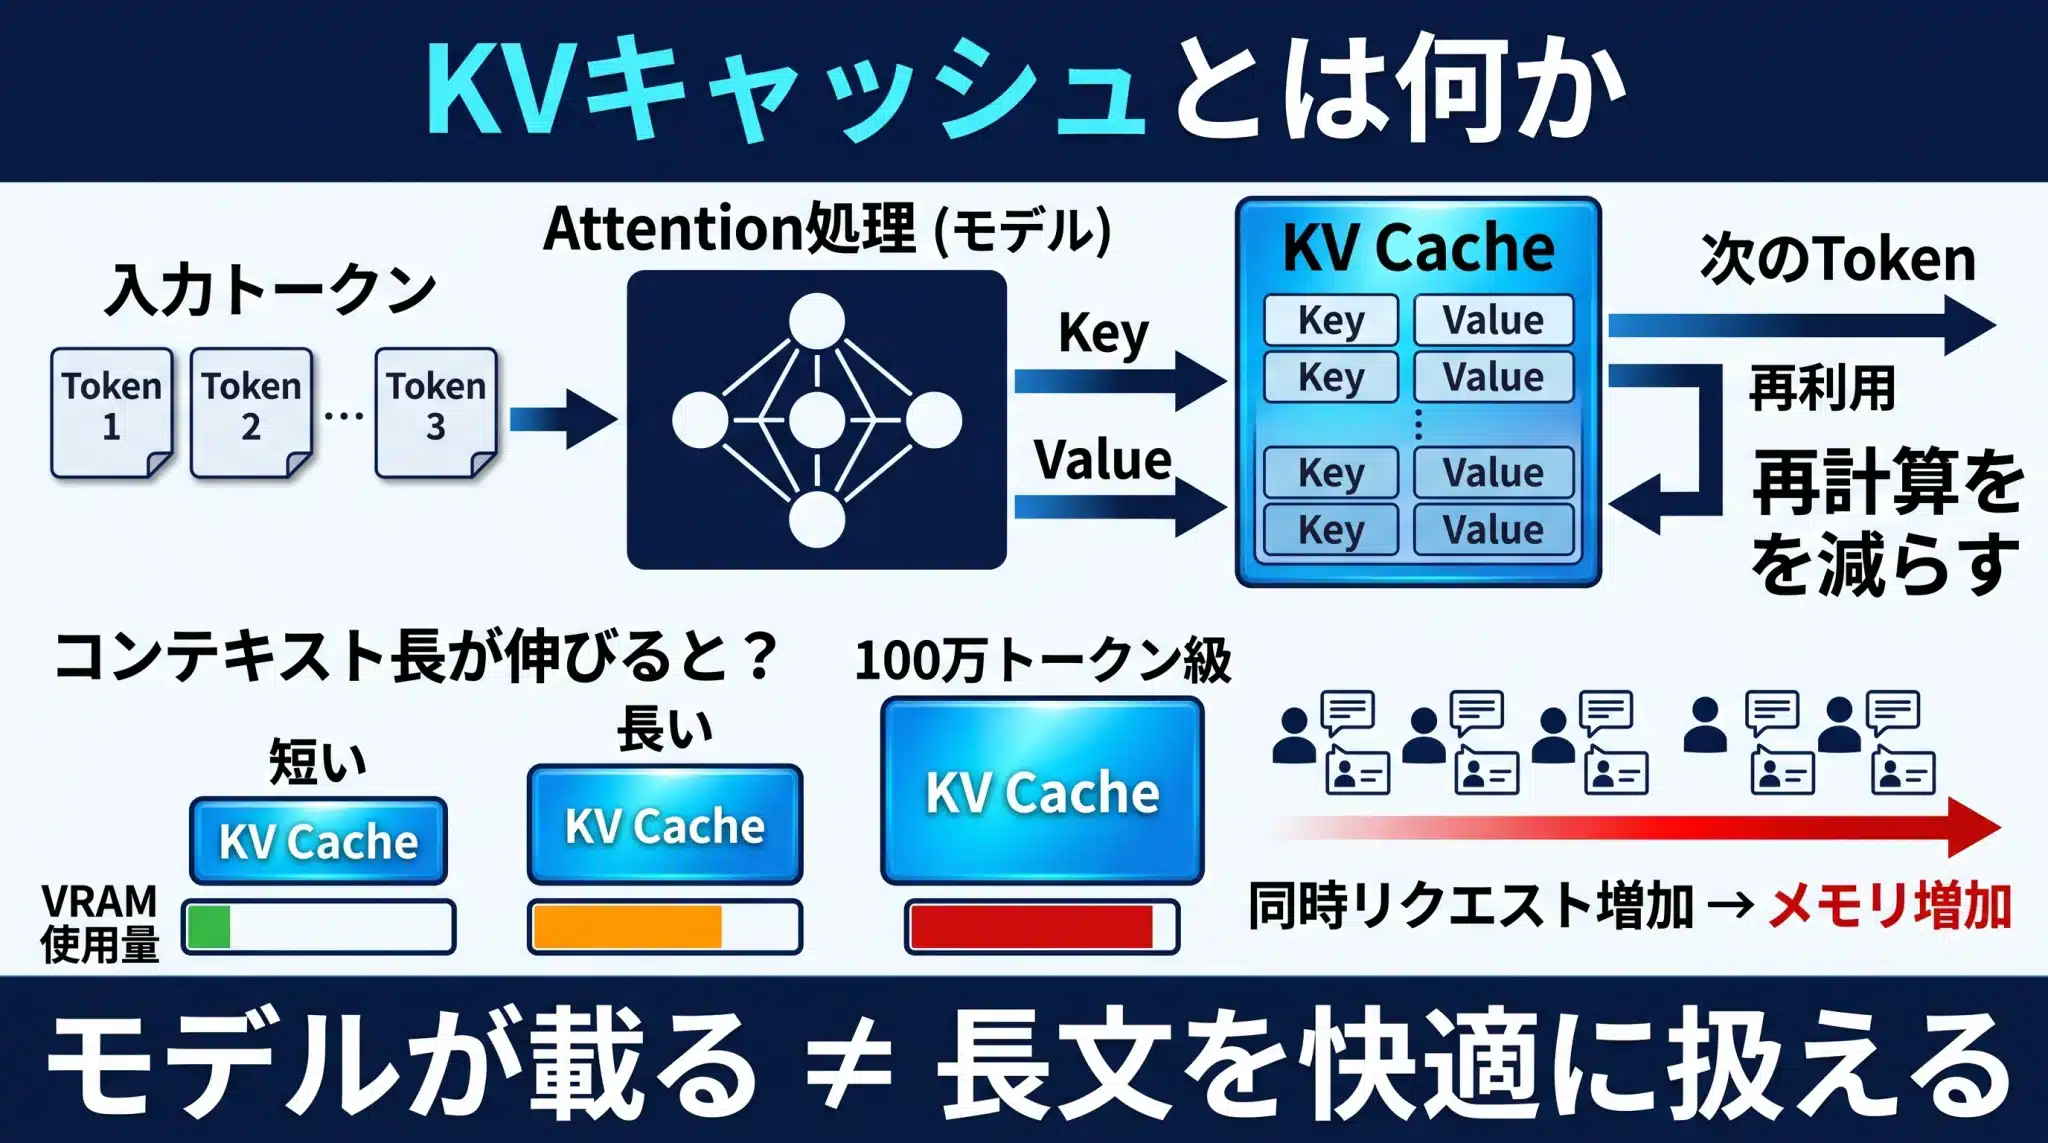
ただし、KVキャッシュは無料ではありません。コンテキストが長くなるほど保存すべきKeyとValueも増え、KVキャッシュのメモリ使用量も増大します。モデル本体を量子化して軽くしても、長文ではKVキャッシュがVRAMを圧迫することがあります。「モデルが載る」ことと「長文を快適に扱える」ことは別問題です。
ここで混同してはいけないこと
KVキャッシュは、主に速度、メモリ、同時処理数に関わる仕組みです。
重要条件の見落としは、モデルの長文理解力やコンテキスト設計の影響が大きく、「回答が悪いのはKVキャッシュのせい」と単純化できません。
KVキャッシュとPrompt Cachingの違い
KVキャッシュは、推論時に過去トークンの計算結果を再利用する内部機構です。通常はリクエストに対応して生成されますが、推論基盤によっては、共通する先頭部分のKVキャッシュを複数リクエスト間で再利用する実装もあります。
一方、Prompt/Context Cachingは、同じ長いプロンプトや文書を繰り返し使う際に、その再利用をサービスとして提供する仕組みです。どの範囲を、どの条件で、どれだけの時間キャッシュするかは、各サービスや推論基盤によって異なります。
症状から原因を見つける「長文LLM健康診断」
モデル変更の前に、問題がモデル・コンテキスト・インフラのどこで起きているかを切り分ける。
ここまで分かれば、「回答が悪い=モデルが悪い」と考える必要はなくなります。見落としなのか、Prefillが遅いのか、KVキャッシュが重いのか、同じ入力を何度も処理しているのか――症状から原因を切り分ければ、取るべき対策も変わります。あなたのAIには、次のどれが当てはまるでしょうか。
原因欄の【①理解力】【②設計】【③基盤】は、冒頭の「先に結論」で示した3層に対応しています。
| 症状 | 主に疑う原因 | 最初に試すこと |
|---|---|---|
| 文書中央の条件を見落とす | 【①理解力】情報位置、長文理解力 | 重要条件を冒頭と末尾に整理する |
| 複数資料をまたぐ判断が弱い | 【①理解力】横断推論能力 | 資料ごとに抽出してから統合させる |
| 古い条件を回答に使う | 【②設計】新旧情報の競合 | 日付、版、優先順位を明示する |
| 回答が曖昧になる | 【②設計】不要情報、目的の混在 | 質問に必要な資料だけを渡す |
| 最初の回答まで遅い | 【③基盤】長いPrefill、重い推論設定 | 入力を短くし、処理を分ける |
| 会話を続けるほど前提が崩れる | 【②設計】履歴の肥大化 | 決定事項を要約して新しい会話へ移る |
| 同じ資料への質問が毎回遅い | 【③基盤】共通部分の再処理 | Prompt/Context Cachingを確認する |
| API費用が膨らむ | 【②設計】【③基盤】大量入力の反復 | RAG、キャッシュ、要約を比較する |
| 長文でGPUメモリが足りない/同時接続数を増やせない | 【③基盤】KVキャッシュの肥大 | コンテキスト長と同時数の上限を見直し、KVキャッシュ量子化やPagedAttentionを検討する |
一つの症状に、一つの原因しかないとは限りません。入力長、画像や表、高度な推論モード、サービスの混雑も影響します。
まず同じ質問を短い資料と長い資料で比較し、入力長によって症状が変わるか確認してください。
LLM利用者が今日からできる8つの対策
多くの場合、最初に効果が出やすいのは、GPUの交換ではなく、AIへ渡す情報の設計し直しである。
長文LLMの改善は、GPU交換やKVキャッシュ最適化から始める必要はありません。まず不要な入力を減らし、重要条件を整理し、繰り返し使う部分をキャッシュする。それでも速度やメモリが問題になるなら、KVキャッシュや推論基盤の最適化を検討する――この順番が実務的です。
全資料を最初から投入しない
「念のため全部入れる」は避けます。最初に目次、文書名、更新日、要約を渡し、質問に必要な章だけを追加します。
最重要条件を冒頭へ集約する
制約、判断基準、禁止事項は、資料の中央に埋めず、冒頭へ整理します。資料の後には、具体的な質問を置きます。
指示例
最優先条件は次の3点です。
① 契約期間は3年以内
② 海外拠点へのデータ移転は禁止
③ 2026年7月版の規定を旧版より優先する
抽出・矛盾確認・結論の順に進める
複数資料を扱う場合は、各資料から条件を抽出し、出典と日付を表にし、矛盾を確認してから結論を作らせます。「全部読んで判断して」より、途中の誤りを発見しやすくなります。
根拠となる箇所を示させる
文書名、章、ページ、該当箇所を示し、根拠がない項目は推測しないよう指示します。契約、法務、財務などの重要事項は、示された引用を原文で再確認します。
長くなった会話を要約して切り替える
目的、決定事項、未解決事項、禁止事項、使用資料、出力形式だけを要約し、新しい会話へ移します。市場調査と契約審査など、目的が異なる仕事も会話を分けます。
長いコンテキストとRAGを使い分ける
一つの文書全体や文章の流れを読む場合は長いコンテキスト、大量かつ頻繁に更新される文書から必要箇所だけを探す場合はRAGが向きます。
実務では、RAGで候補を絞り、少し長めのコンテキストで情報を統合する構成が有効です。
同じ資料を繰り返すならキャッシュを確認する
同じPDFや共通指示を繰り返す場合は、Prompt CachingやContext Cachingを確認します。キャッシュは精度を自動改善するものではなく、同じ入力の再処理を減らす機能です。
自社資料で実効性能を測る
公開ベンチマークだけで決めず、日常業務の資料で精度、待ち時間、根拠、料金を比較します。モデルの変更前後で同じ課題を使うことが重要です。
LLMを選ぶとき、どの性能を見ればよいのか
最大トークン数ではなく、自分の資料と質問で得られる実効性能を比較することが重要である。
| 確認項目 | 分かること | 注意点 |
|---|---|---|
| 最大コンテキスト長 | 形式上入力できる上限 | 実効理解力とは異なる |
| 最大出力長 | 生成できる回答量 | 入力上限とは別に設定される |
| 長文検索・統合評価 | 情報を探し、結びつけられるか | 単一情報の検索だけでは不十分 |
| 日本語長文性能 | 日本語資料で性能を保てるか | 英語評価だけで判断しない |
| TTFT(最初の出力が返るまでの時間)・生成速度 | 待ち時間と表示速度 | 入力長や混雑でも変わる |
| 入力・出力料金 | 長文を繰り返す費用 | キャッシュ適用料金も確認する |
| キャッシュ・RAG対応 | 共通入力や大量資料を効率化できるか | 条件と検索精度を確認する |
自分でできる4つの実用テスト
- 位置テスト:同じ重要条件を冒頭、中央、末尾へ置き、回答の違いを見る
- 複数条件テスト:条件を複数文書へ分散し、すべてを使えるか確認する
- 矛盾テスト:旧版と新版を混ぜ、日付と優先順位を判断させる
- 入力方式テスト:全文投入、段階処理、RAG、事前要約を比較する
正解率だけでなく、待ち時間、料金、根拠の追跡しやすさも記録してください。
カタログ上のコンテキストサイズではなく、自社資料で測った結果が、そのモデルの実効コンテキスト性能です。
AIインフラの舞台裏では何が起きているのか
長文LLMの競争は、計算力だけでなく、一時記憶をどこに置き、再利用し、運ぶかの競争である。
長文LLMの推論では、GPUの演算性能だけを高めても十分ではありません。KVキャッシュをどう詰めるか、どう再利用するか、どう小さくするか、どこへ逃がすか、どう運ぶかが、同時処理数と応答速度を左右します。
KVキャッシュ最適化の技術名は多くても、発想は複雑ではありません。Arpableでは、「詰める・再利用する・小さくする・逃がす・運ぶ」の5つに整理します。これだけ押さえれば、PagedAttention、Prefix Caching、KVキャッシュ量子化、オフロード、Prefill/Decode分離の位置づけが一枚の地図になります。
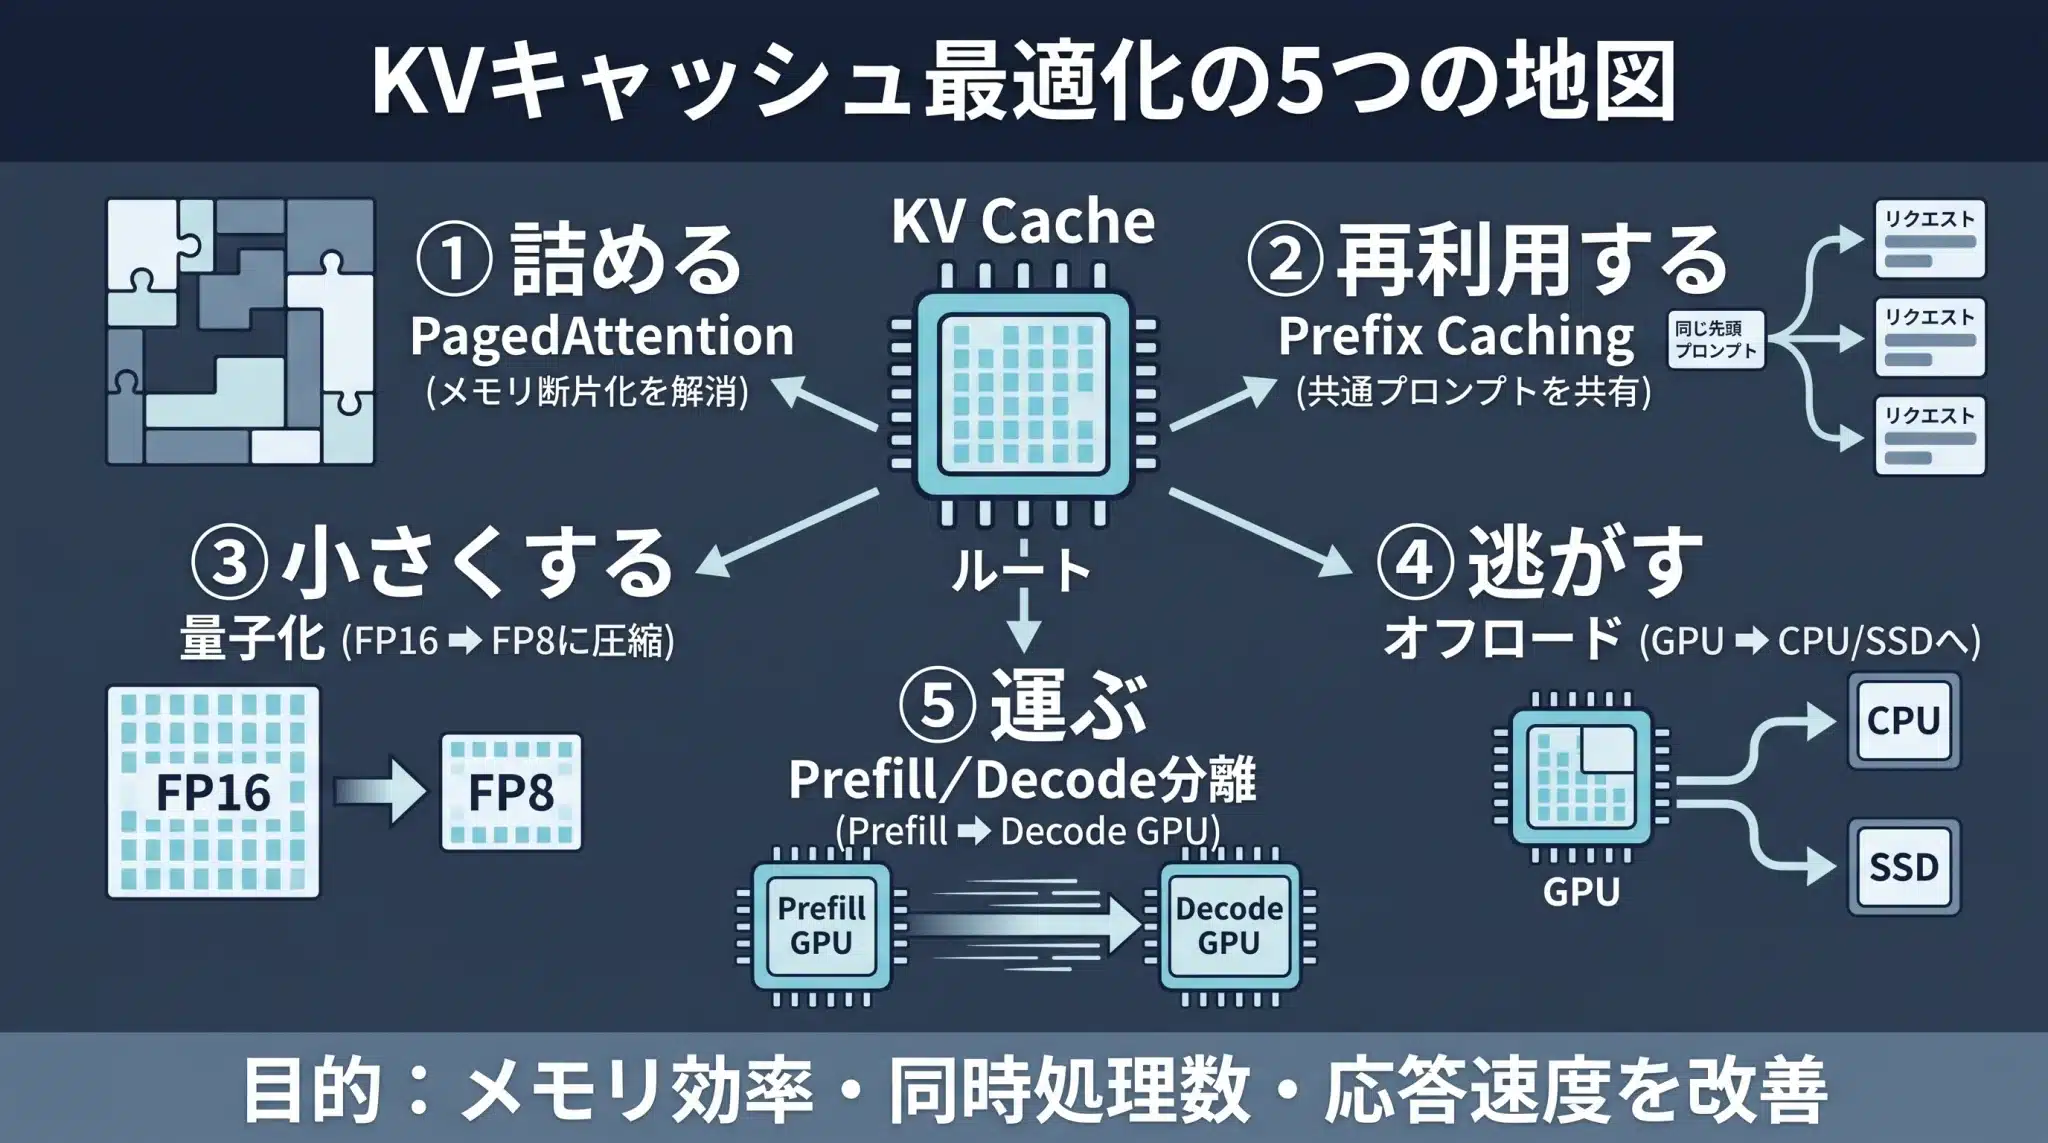
PagedAttention:詰める
KVキャッシュを小さなブロック単位で管理し、必要な分だけ割り当てます。メモリの断片化を抑え、同じGPUで処理できるリクエストを増やしやすくします。
Prefix Caching:再利用する
同じシステム指示や長文資料を繰り返す場合、共通する先頭部分のKVキャッシュを再利用します。vLLMのAutomatic Prefix Cachingは、同じ文書へ複数の質問をする処理に適しています。
KVキャッシュ量子化:小さくする
KeyとValueをFP8などの低精度形式で保持し、メモリ使用量を減らします。vLLMはFP8 KVキャッシュをサポートしていますが、品質や速度への影響は、モデル、校正方法、ハードウェアによって異なります。
なお、KVキャッシュ量子化はAI効率化の一手法ですが、モデル本体の量子化・プルーニング・知識蒸留とは対象が異なります。AI効率化全体の考え方については、効率的なAIの時代 – 学習から推論へのパラダイムシフトで整理しています。
オフロードとPrefill/Decode分離:逃がす・運ぶ
KVキャッシュをCPUメモリやストレージへ逃がせば容量を広げられますが、転送が遅ければ新たなボトルネックになります。
NVIDIA DynamoのようにPrefillとDecodeを別のワーカーへ分ける設計では、両者を個別に拡張できる一方、高速なKVキャッシュ転送経路が重要です。
Vera Rubin:高速な置き場所と通信を増やす
NVIDIA Rubin GPUは、NVIDIA公称値で最大288GBのHBM4と最大22TB/秒のメモリ帯域を備えます。
容量は、大きなモデル、長いコンテキスト、KVキャッシュ、高い同時実行数を支えます。帯域は、Decodeでモデルの重みやKV状態を読み出す速度に関わります。
長文推論では、演算性能だけでなく、記憶を置き、読み、運ぶ能力が重要です。競合との比較はNVIDIA Rubinと競合AIハードウェアの戦略比較、市場全体はAIインフラの未来展望で解説しています。
まとめ――大きな机より、必要な資料を選ぶ力
長文LLMを使いこなす競争は、コンテキストの大きさではなく、情報と記憶の設計をめぐる競争である。
経営会議を終えた後、三浦ナオは、最初にLLMへ渡した資料を開き直しました。そこには、今回の判断に不要な議事録、重複した市場データ、改訂前の契約書、検討中のメモまで含まれていました。
問題はAIの机が狭かったことではありません。必要な資料と不要な資料を区別せず、机の上へ積み上げていたことでした。
ナオは不要な議事録を外し、旧版と最新版を分け、重要条件を冒頭へ書き出しました。
整理後の資料で同じ質問をすると、回答から余計な枝葉が減り、要点と根拠が明確になりました。どの条件を拾い、何を見落としているかも確認しやすくなっています。
読了後に試してほしい最初の一歩
別のLLMへ乗り換える前に、現在のLLMへ自社資料で「位置テスト」を行ってください。同じ重要条件を冒頭・中央・末尾へ置き、回答の違いを記録します。それが、あなたの組織における実効コンテキスト性能を知る出発点です。
KVキャッシュは、LLMが長い文脈を高速に扱うために欠かせない仕組みです。しかし、コンテキストが長くなるほど、その便利な一時メモリ自体が新たなメモリ負荷になります。一方で、KVキャッシュを最適化しても、長文の理解力そのものが高くなるわけではありません。
100万トークンは強力ですが、「何でも全部入れてよい」という許可証ではありません。
パラメータはAIが身につけた能力、コンテキストは今回の机、RAGは資料を探す司書、KVキャッシュは推論中の付箋、HBMはそれらを置く高速な作業場所です。
ナオの机は、最初から十分に広かったのです。変わったのは、その上に置く資料でした。今では、判断に本当に必要な情報だけが残っています。
最大コンテキスト長だけでは、LLMの実力は分かりません。何を渡すかはコンテキスト設計、何を探すかはRAG、どこまで正しく結びつけられるかはモデル性能、どれだけ速く・少ないメモリで使えるかはKVキャッシュと推論基盤が支えます。
100万トークンの机の価値は、広さではなく、何を置き、どう読み返せるかで決まります。
専門用語まとめ
長文LLMを利用するうえで、最低限押さえておきたい用語を整理する。
- コンテキストウィンドウ
- 一回の処理でLLMが参照できる入力、指示、履歴、出力の範囲。
- KVキャッシュ
- 過去トークンのKeyとValueを保存し、生成時に再利用する一時データ。
- Prefill
- 入力トークンを処理し、後続の生成で参照するKVキャッシュを作る段階。
- Decode
- KVキャッシュを参照しながら出力トークンを生成する段階。
- RAG
- 外部文書から関連情報を検索し、LLMへ渡す仕組み。
- HBM
- GPUの近くに配置され、モデルの重みやKVキャッシュを保持する高帯域メモリ。
- Prompt Caching
- 同じ長い入力や指示を繰り返すとき、共通部分の再処理を減らすサービス側の仕組み。
- VRAM
- GPUが使う専用メモリ。モデルの重みやKVキャッシュの置き場所になる。
- TTFT
- Time to First Tokenの略。入力を送ってから最初の出力トークンが返るまでの時間。
参考文献 / 出典
長文性能・KVキャッシュ・推論インフラに関する一次情報と主要研究。
- Google AI for Developers:Long context
- Google AI for Developers:Context caching
- Lost in the Middle: How Language Models Use Long Contexts
- RULER: What’s the Real Context Size of Your Long-Context Language Models?
- LongBench v2
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Retrieval Augmented Generation or Long-Context LLMs?
- vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention
- vLLM:Automatic Prefix Caching
- Meta Llama 3.1 70B Instruct:config.json
- vLLM:Quantized KV Cache
- NVIDIA Dynamo:Disaggregated Serving
- NVIDIA:Inside NVIDIA Rubin GPU Architecture
補足Q&A
長文LLMとKVキャッシュについて、特に誤解されやすい疑問を補足する。
Q1. 100万トークン対応なら、資料を全部入れた方が精度は上がりますか?
Q2. KVキャッシュを削除すると、LLMは会話を忘れますか?
Q3. 100万トークンのモデルがあれば、RAGは不要ですか?
更新履歴
本記事の主な公開・改訂履歴。
- 2025年10月5日 初版投稿
- 2025年11月16日 情報アップデート、読者支援機能強化
- 2026年8月4日 長文LLMの実効性能、KVキャッシュ、RAG、コンテキスト設計の関係を整理し、診断表と対策を追加
- 2026年10月8日 KVキャッシュの定義・長文との関係・容量試算・Prefill/Decode・最適化5分類を強化し、100万トークンと推論基盤の役割分担を整理