GPUを1枚速くしても、もう足りない――NVIDIAのVera Rubinが示したのは、AIデータセンター全体を進化させる新しい競争の幕開けである。
長い文書を読み、何度も推論するAIは、どこで待ち時間が生まれ、何にコストがかかるのか。NVIDIAはGPUに加え、CPU、メモリ、通信、冷却まで協調設計し、AIの待ち時間とトークン当たりのコストを減らそうとしている。
Blackwellから何が変わったのか。Vera Rubinの何がすごいのか。この記事では、NVL72とGroq 3 LPXの仕組みを「AI劇場」の物語でたどり、次世代AIデータセンターの進化を解き明かす。
✅ 先に結論
- 何がすごい? Blackwellの一体設計を受け継ぎ、新世代のGPU・CPU・メモリ・通信技術とGroq 3 LPXとの役割分担によって、AIファクトリー全体の処理効率と経済性を高める点です。
- Blackwellとの違いは? Rubin GPU、Vera CPU、HBM4、NVLink 6などで学習・推論性能と電力効率を強化します。さらにPOD規模で5種類のラックを統合し、AIファクトリー全体の設計を進化させます。NVIDIAは特定条件でトークン当たりのコストを最大90%削減できるとしています。
- NVL72とは? Rubin GPU 72基とVera CPU 36基を1ラックに統合する計算基盤です。GPU間はNVLink 6、CPUとGPUはNVLink-C2Cで連携します。
- Groq 3 LPXとは? Groq 3 LPUを256基搭載する独立した低遅延推論ラックです。Vera Rubin NVL72と組み合わせ、用途に応じて推論処理を分担します。
この記事の著者・監修者 ケニー狩野(Kenny Kano)
役職:(株)アープ取締役。Society 5.0振興協会・AI社会実装推進委員長。中小企業診断士、PMP。著書『リアル・イノベーション・マインド』
Vera Rubinとは?NVIDIAが次に変えるもの
Vera Rubinとは、Blackwellの次に位置づけられるNVIDIAのAI基盤であり、GPU単体ではなくデータセンター全体を計算単位として捉えるプラットフォームである。
Vera Rubin(ヴェラ・ルービン/ベラ・ルービン)は、Rubin GPU、Vera CPU、NVLink 6、ネットワーク、DPU、ストレージ、冷却などを統合し、AIの学習と推論を大規模に実行するプラットフォームです。名前は、暗黒物質の存在を示す観測で知られる天文学者Vera Rubinに由来します。
「新しいGPUが登場した」と聞くと、私たちはまずチップの速さを比べます。しかし、AIエージェントは質問に答えるだけではありません。情報を探し、ツールを呼び、計算し、結果を検証し、必要なら考え直します。仕事が長くなるほど、GPUに届くデータ、途中の記憶、通信、電力が制約になります。
主演俳優がどれほど優秀でも、台本が届かず、舞台への通路が混雑すれば公演は止まります。Vera Rubinは主演だけでなく、舞台監督と搬入口、通路、劇場設備までをまとめて作り替える構想なのです。
Vera Rubinは何がすごい?3つの進化
Vera Rubinの進化は、新世代のCPU・GPUによる協調、メモリと通信の効率化、Groq 3 LPXによる低遅延推論の三つに整理できる。
① 新しいCPU・GPU・接続で、ラック全体の協調を進化させる
GPUをラック単位で動かす発想は、すでにBlackwell世代から実現しています。その詳しい違いは次章で見ていきましょう。
Rubinはこの設計をさらに発展させ、Rubin GPU 72基とVera CPU 36基を組み合わせます。GPU同士はNVLink 6で高速に通信し、CPUとGPUはNVLink-C2Cで緊密に連携します。
主役のGPUが空転しないよう、CPUが制御やデータ処理を支え、ラック全体を巨大な計算資源として使う。一人の主演俳優の能力だけでなく、舞台全体の連携を高める発想です。
② 「計算する速さ」だけでなく「運ぶ速さ」を上げる
長い会話や複数段階の推論では、途中で使う記録であるKVキャッシュが大きくなります。GPUが高速に計算できても、必要な情報を取り出すのが遅ければ、処理全体は速くなりません。
Vera Rubinは、HBM4に加え、高速ネットワーク、DPU、AI向けストレージを組み合わせ、情報が詰まりやすい箇所を減らします。
長い文脈を扱い、多段階の推論を進めるほど、データを運ぶ仕組みも性能を左右します。
③ Groq 3 LPXを組み合わせ、応答の待ち時間を減らす
大量処理が得意なGPUに、低遅延推論向けのGroq 3 LPXを組み合わせます。LPXには、SRAMを中心に設計されたGroq 3 LPUが256基搭載されています。
長い文脈を扱いながら利用者への応答を速める狙いですが、役割分担はモデルや推論方式によって変わります。すべての処理が自動的に高速化されるわけではありません。
Rubinの価値は、GPUの最高速度だけではなく、限られた電力と費用で有用なAI処理をどれだけ生み出せるかにあります。
Vera RubinとBlackwellの違いを比較
Blackwellが本格化させたラックスケールAIを、Rubinは新しいCPU・GPU・高速接続とPOD構成によって発展させ、推論の効率と運用性を高める。
ここで一つ、重要な誤解を解いておきましょう。72基のGPUを一つのラックに収めるNVL72は、Rubinで初めて登場した仕組みではありません。 Blackwell世代のGB200 NVL72も、72基のBlackwell GPUと36基のGrace CPUを統合しています。
では、Rubinでは何が変わったのでしょうか。
進化の焦点は、ラックという発想そのものではなく、その中身です。Rubin GPUとVera CPU、HBM4、NVLink 6、さらに低遅延推論を支えるGroq 3 LPXなどによって、計算とデータ移動の効率を高めます。
| 比較軸 | Blackwell世代 | Vera Rubin世代 |
|---|---|---|
| 代表ラック | GB200 NVL72 | Vera Rubin NVL72 |
| ラック構成 | 72 Blackwell GPU・36 Grace CPU | 72 Rubin GPU・36 Vera CPU |
| GPUメモリ | HBM3e | HBM4 |
| GPU間接続 | 第5世代NVLink | NVLink 6 |
| CPU・GPU間接続 | NVLink-C2C | NVLink-C2C |
| 低遅延推論 | GPU中心の推論基盤 | Groq 3 LPXとの協調をプラットフォームに含む |
| 推論効率(公称) | 比較基準 | 最大10倍の推論性能/ワット、トークンコスト最大90%削減 |
| 注:本表はGB200 NVL72を比較対象としています。GB300 NVL72を含むBlackwell世代の全構成を比較したものではありません。性能倍率はNVIDIAの特定ワークロード・構成に基づく公称値であり、一般的な実測保証値ではありません。出典:NVIDIA公式Vera Rubin資料。 | ||
NVIDIAはRubin NVL72について、Blackwellとの比較で最大4倍の学習性能、最大10倍の推論性能/ワット、トークンコスト約10分の1を掲げています。ただし、この三つは異なる指標です。学習性能、電力効率、実際の支払額を同じ倍率で理解してはいけません。
さらに、Vera Rubin NVL72とGroq 3 LPXを組み合わせた構成について、NVIDIAは2兆パラメータのMoEモデル、40万トークンの入力文脈、利用者当たり約400トークン/秒という想定条件で、GB200 NVL72比で電力1MW当たりの推論スループットが最大35倍になると示しています。
これはNVIDIAの条件付き性能比較であり、個々の利用者の応答が35倍速くなるという意味ではありません。また、NVIDIAは最大10倍の「収益機会」も示していますが、これは想定条件に基づく事業機会の試算です。購入しただけで売上が10倍になるという意味ではありません。
その性能差は、あなたの現場でも意味があるのか?
「トークンコストが下がる」と聞いて、どの処理の話か考えたことはあるでしょうか。
長い文章を最初に読み込むプレフィルと、回答を一語ずつ生成するデコードでは、負荷が大きく違います。例えば、100ページの契約書を読み込ませて要約する場合と、チャットで短い質問に答える場合では、処理負荷の性質が異なります。大量の計算をまとめて処理する場面と、利用者にすばやく応答する場面では、最適な構成も変わります。
第二に、最大性能と利用者の体感速度を分けて考えます。同時利用者数、モデルの規模、入力文の長さ、回答の長さによって、実際の応答速度は変わります。
実務では、最初のトークンが返るまでの時間(TTFT)と、回答全体が完了するまでの時間を分けて評価することが重要です。例えば、同時利用者数をそろえたうえで、それぞれのp95を測定します。p95とは、測定したリクエストの95%が、その時間以内に収まる目安です。
第三に、技術的な優位性と更新の採算を分けます。Blackwellの設備をすでに持つ事業者は、現在の稼働率、電力単価、残存耐用年数、移行費用まで含めて判断する必要があります。新型の計算効率が高くても、導入工事や設備改修を含めた投資回収期間は別問題です。
新型の技術的優位性と、今すぐ設備を更新すべきかという経営判断は分けて考える必要があります。
Vera Rubin NVL72とは?ラック全体が1台のコンピュータになる
Vera Rubin NVL72は72基のRubin GPUと36基のVera CPUを統合するラックスケール構成であり、Superchipからクラスタへと階層的に拡張できる。
NVL72を理解する近道は、AI劇場がどのように大きくなるかを見ることです。
最初は主演俳優と舞台監督の小チーム。次に舞台を構成する計算モジュール、72基のGPUを束ねる劇場、そして複数の劇場を結ぶ大規模施設へと広がります。
Superchip:主演と舞台監督の小チーム
Vera Rubin Superchipは、Vera CPU 1基とRubin GPU 2基を組み合わせた計算単位です。 CPUが制御やデータ処理を支え、GPUが計算に集中できるようにします。
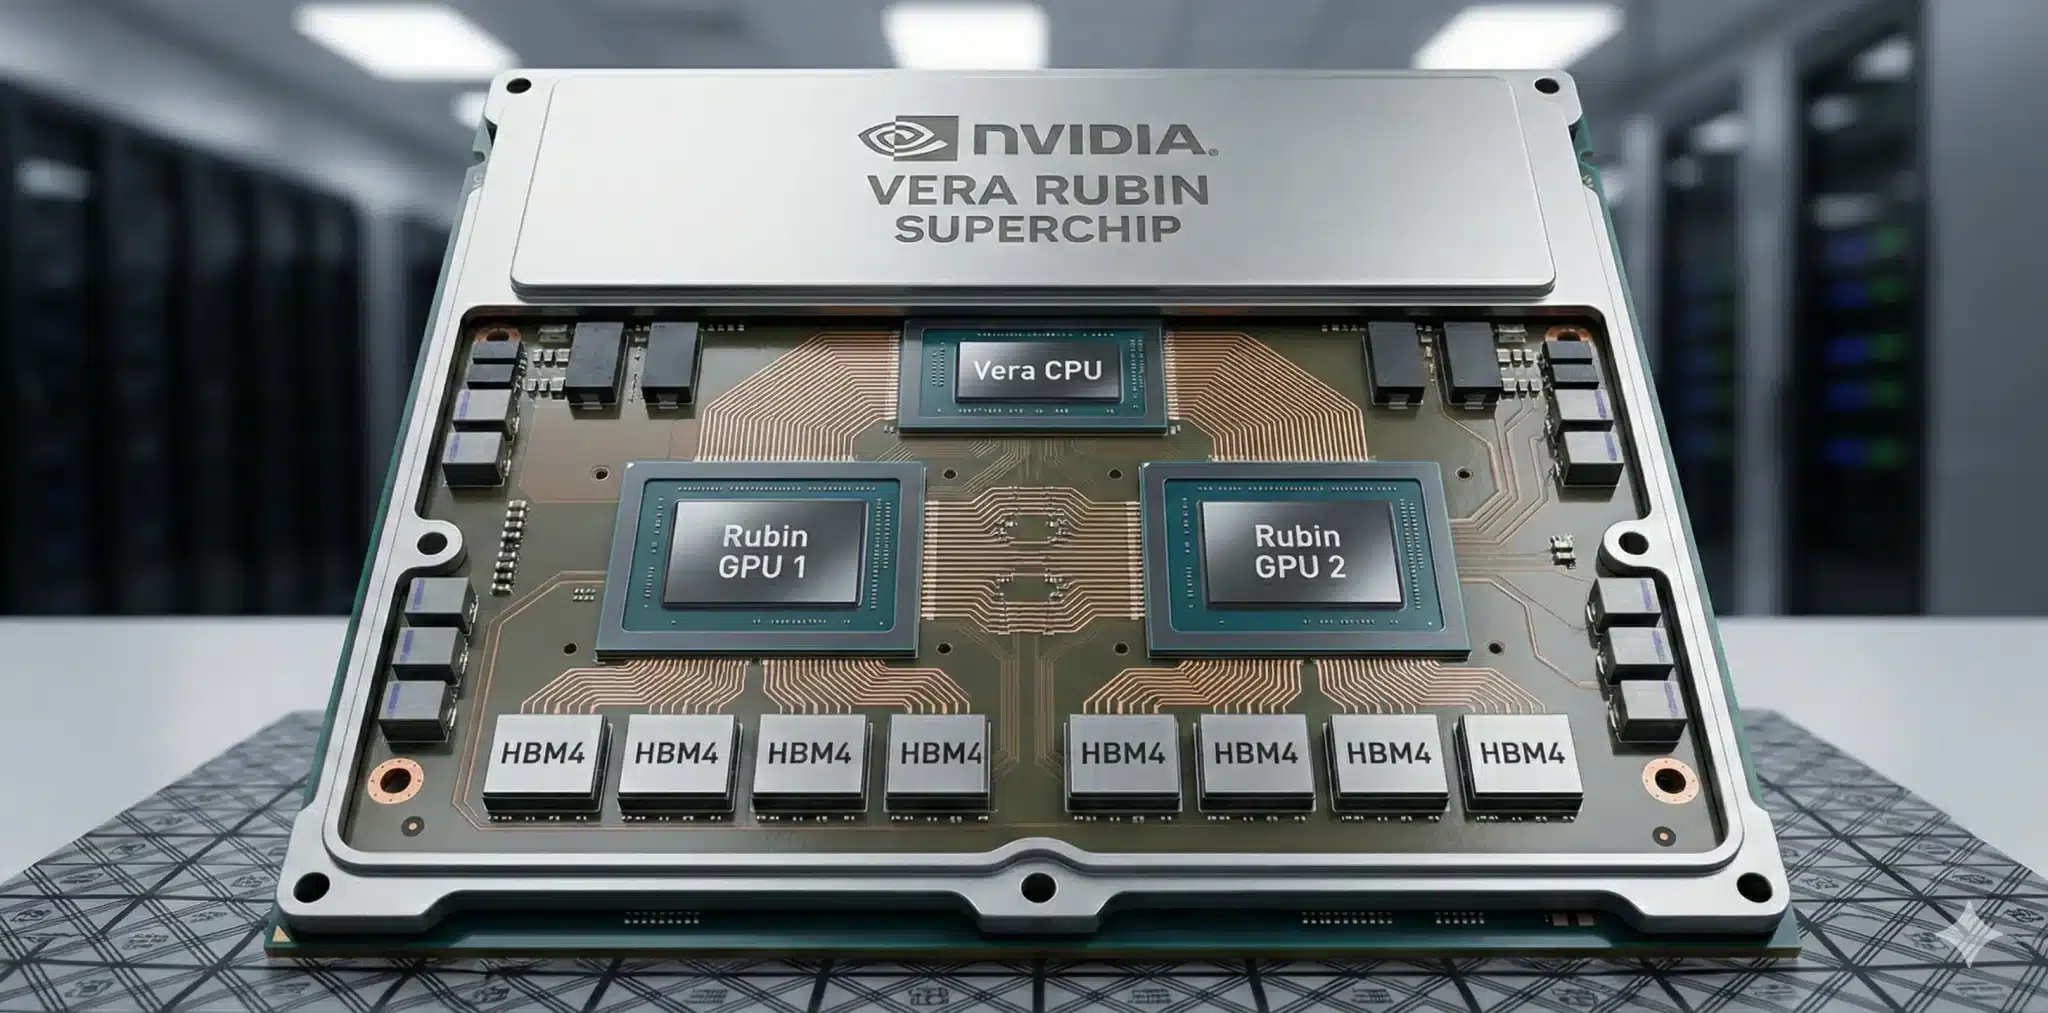
コンピュートトレイ:舞台を構成する計算モジュール
コンピュートトレイはSuperchipを2組搭載する計算モジュールです。合計でRubin GPU 4基とVera CPU 2基を収めます。
NVL72は18基のコンピュートトレイによって、Rubin GPU 72基・Vera CPU 36基を構成します。小チームが集まり、一つの大きな劇場を動かす仕組みです。
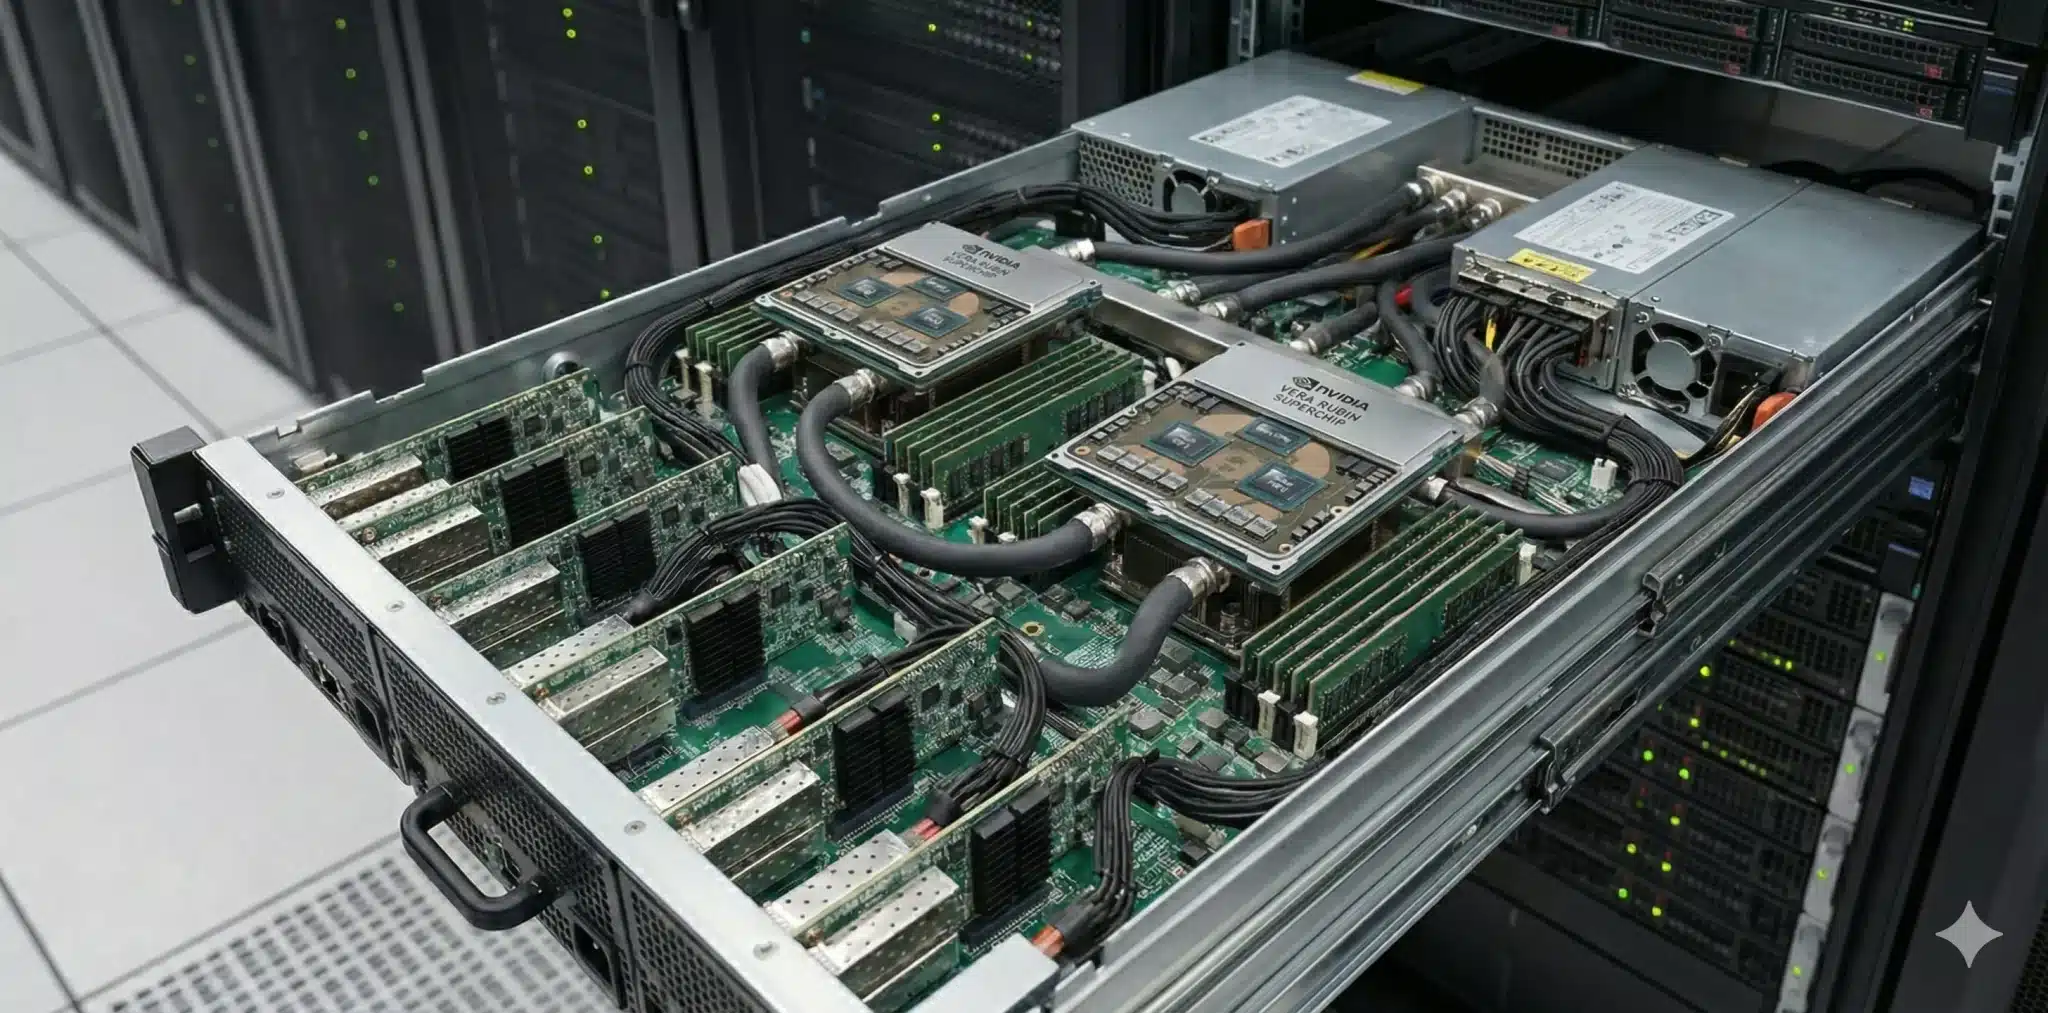
NVL72ラック:72基のGPUが共演する巨大劇場
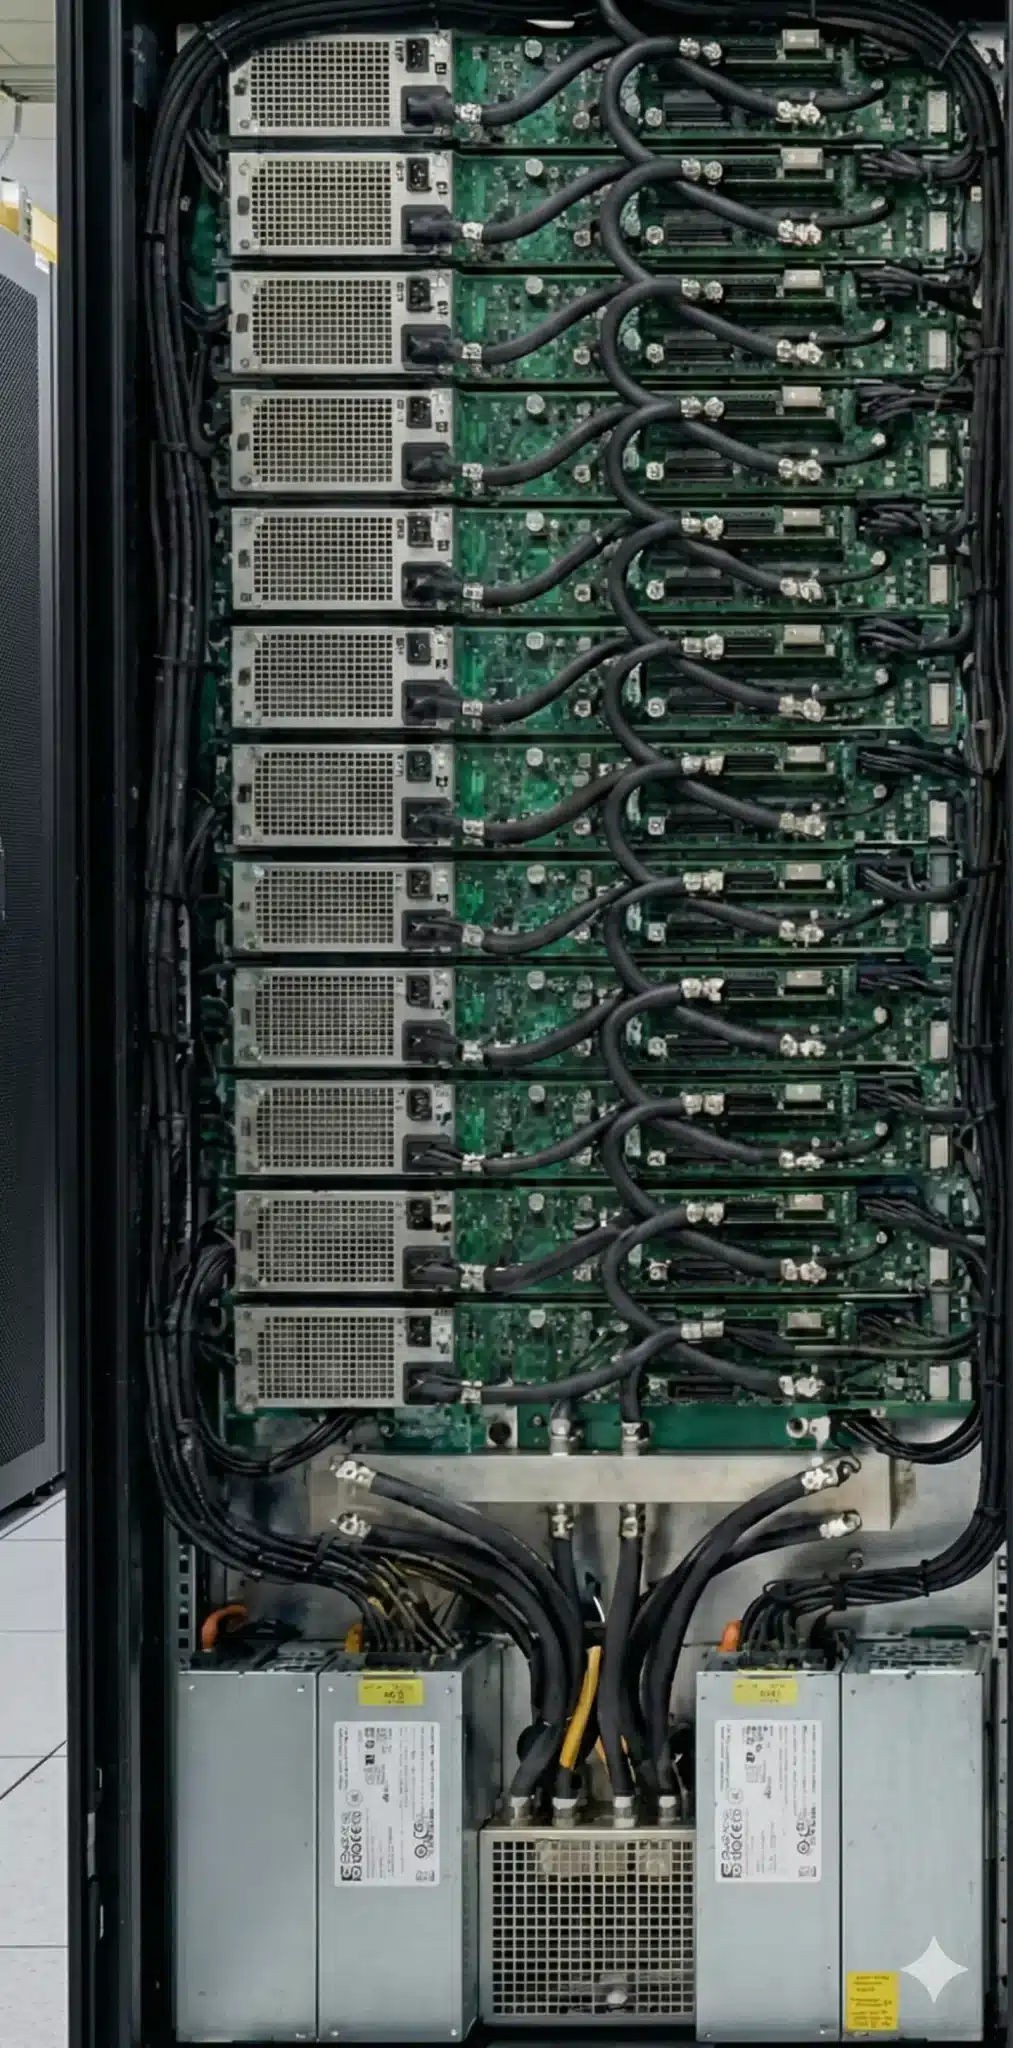
NVL72は、72基のRubin GPUと36基のVera CPUを1ラックに収めます。GPU間はNVLink 6で高速接続し、Vera CPUはNVLink-C2Cを介してGPUと連携します。
GPUを多数並べるだけでなく、大量のデータをすばやく交換し、連携して計算できることが重要です。
クラスタとPOD:複数の劇場を結ぶ施設
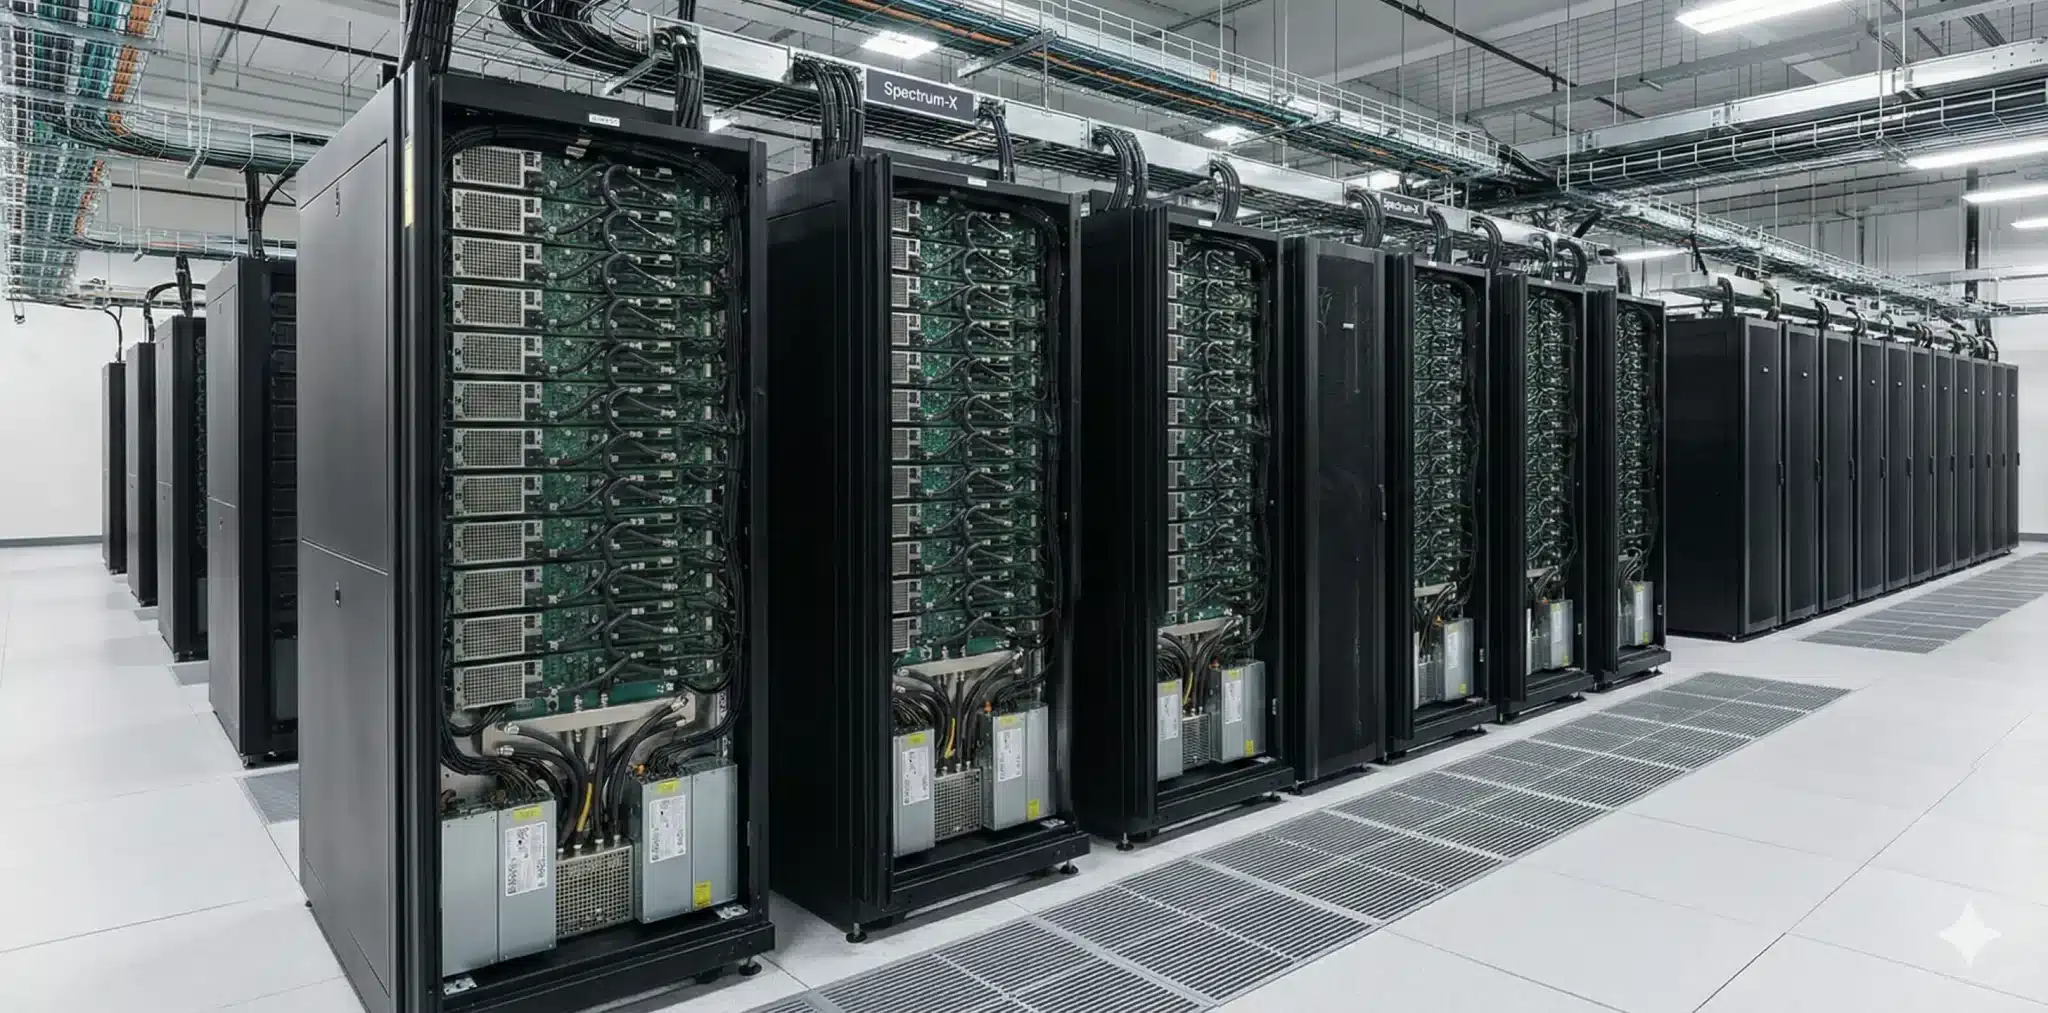
NVL72を複数並べると、劇場は巨大な施設になります。この規模では、ネットワーク、電力、冷却、保守が重要になります。
NVIDIAのVera Rubin PODは、計算、低遅延推論、CPU処理、ストレージ、通信という異なる役割を担う5種類のラックスケールシステムを組み合わせます。
| システム | 主な役割 |
|---|---|
| Vera Rubin NVL72 | GPUによる学習・推論計算 |
| Groq 3 LPX | 低遅延の推論処理 |
| Vera CPUラック | ツール実行・エージェント制御などのCPU処理 |
| BlueField-4 STX | AI向けストレージ・文脈データの取り扱い |
| Spectrum-6 SPX | ラックをまたぐ高速ネットワーク |
NVIDIAは代表的なPOD構成を40ラック、Rubin GPU 1,152基、60エクサフロップス、スケールアップ総帯域10PB/sと説明しています。
60エクサフロップスはNVIDIAの公称値です。AIの演算性能はFP8などの演算精度によって数値が大きく変わるため、他社製品や他世代と比較するときは精度条件をそろえる必要があります。
これらはNVL72単一ラックの数値ではなく、POD全体の値です。一つのラックを巨大な計算機として扱う次には、POD全体を一つのAIスーパーコンピュータとして設計する段階があるのです。
7つのチップを「AI劇場」で理解する
Vera Rubinの7つの中核チップは、主演、舞台監督、物流、伝令、通路、交通管制、高速応答チームとして、異なるボトルネックを解消するために役割分担する。
製品名をすべて覚える必要はありません。主演だけでは公演が成立しない、という構造を理解することが重要です。
次の既存図は2026年1月の6チップ構成を示しています。その後、Groq 3 LPUが第7の中核チップとして加わりました。

例えば、AIエージェントがWeb検索を行い、結果を検証して長い回答を生成する場面を考えてみましょう。
検索ツールの制御や前処理にはCPUが働き、モデルの推論はGPUが担います。別サーバーとの通信にはネットワークが必要です。過去の文脈を大量に扱うなら、DPUやストレージの設計も重要になります。
部品は増えますが、それぞれの得意分野に仕事を分ける狙いがあります。優れた主演を生かすには、台本を届け、出番を整える仕組みが欠かせません。
Rubin GPU:演技を担う主演俳優
Rubin GPUは、HBM4を備え、AIの学習・推論を実際に計算する主役です。
膨大な行列演算を担当しますが、台本に相当するデータが届かなければ演技を続けられません。GPU性能だけを見ても、AI全体の速さは分からないのです。
Vera CPU:段取りを整える舞台監督
Vera CPUはNVIDIAが設計したArm系CPUで、GPUの計算を支える制御・データ処理役です。
エージェントがツールを実行する処理や、学習・推論の前後の仕事にもCPUの能力が必要になります。舞台監督が出番を整理すれば、主演が待たずに済みます。
技術メモ:Vera CPU
NVIDIA独自のOlympus CPUコア、LPDDR5X系メモリ、NVLink-C2Cなどを組み合わせ、GPUとの緊密な協調を狙います。CPUとGPUが必ず同じ仕事をするという意味ではありません。
NVLink 6:劇場内を結ぶ高速通路
NVLink 6はGPU間の高速通信を支え、ラック全体を一つの大きな計算資源のように動かす技術です。
同じ劇場内で俳優が情報を頻繁に交換するとき、通路が狭いと全員が待たされます。計算の前後に生じる同期やデータ移動を支えるのが、この高速通路です。
ConnectX-9 SuperNIC:劇場を結ぶ伝令
ConnectX-9はノード間やラック間をつなぐ高速ネットワークインターフェースです。
分散学習・推論では、別の計算機へ結果を渡す通信が頻発します。NVLink 6が劇場内の通路なら、ConnectX-9は劇場間を結ぶ伝令に当たります。
BlueField-4 DPU:データの搬入責任者
BlueField-4はネットワーク、ストレージI/O、セキュリティ処理などを担うDPUです。
舞台裏で資材を搬入するスタッフのように、BlueField-4はデータの出入りを支えます。GPUに裏方の仕事まで任せない、という役割分担が狙いです。
Spectrum-6:劇場施設の交通管制
Spectrum-6はAIクラスタ向けEthernetのスイッチ基盤で、ラック間の大規模な通信を支えます。
施設が広がると、単に道幅を広げるだけでなく、混雑を制御する必要があります。ネットワークの設計は、システム全体の処理効率を左右します。
構成によってはInfiniBand系も用いられ、すべてがSpectrum-6だけで接続されるわけではありません。
Groq 3 LPU/LPX:観客を待たせない高速応答チーム
Groq 3 LPUが7番目のチップであり、Groq 3 LPXはそのLPUを256基収めた独立ラックです。
NVL72ラックの中に256基のLPUが入っているわけではありません。Rubin GPUの大容量HBMと、Groq 3 LPUの高速SRAMを組み合わせ、モデルや推論方式に応じて負荷を分担します。
背景には2025年12月のNVIDIAとGroqの非独占技術ライセンス取引があります。
NVIDIAのSEC提出書類(Form 10-K)によると、契約に関連する対価は合計約170億ドルです。一部報道では約200億ドル規模とも伝えられましたが、ここではNVIDIAの開示額を採用します。NVIDIAはGroqの技術にアクセスし、一部の人材を迎え入れましたが、Groq社そのものを買収したわけではありません。
2026年8月24日には、NVIDIAがGroq 3 LPXの本格量産を公表し、最初のAIクラウド採用企業としてNebiusを挙げました。実際のサービス提供・稼働時期は、各事業者の発表で確認する必要があります。
また、NVIDIAの2026年8月24日発表によると、Artificial Analysisのベンチマークでは、Gemma 4 31Bを10万トークンの文脈で実行した条件で、毎秒約3,400出力トークンを記録しました。
これは特定条件の測定例であり、モデルや文脈長、提供条件が変われば、同じ速度になるとは限りません。
GPUとLPUは、どのように仕事を分担するのか
ここで重要なのは、単純に「GPUが入力を読み、LPUが回答を書く」という役割分担だけではないことです。
NVIDIAは複数の協調構成を紹介しています。例えば、GPUがプレフィルやデコード時のAttentionを担い、LPUがFFNやMoEのエキスパート計算を担う方式があります。
また、LPUが候補トークンを先行生成し、GPUがその結果を検証する投機的デコードも紹介されています。
プレフィルは入力を読み込む処理、Attentionは文脈のどこに注目するかを計算する仕組み、FFNはモデル内部の情報変換を担う計算、MoEは複数の専門家ネットワークから必要なものを選んで使う構造です。
初心者向けに言えば、台本を読み込む仕事だけでなく、次の一語を作る途中の仕事も、得意な装置に分ける設計です。
膨大な情報を扱う計算と、観客へ素早く返答する仕事を協調させることが、Groq 3 LPXを組み合わせる意味なのです。
HBM4とKVキャッシュ――AIの作業机と倉庫
長文脈AIでは、演算の速さだけでなく、過去のトークンに対応する情報を保持するKVキャッシュをどこに置き、どれだけ速く出し入れできるかが性能を左右する。
メモリを「作業机」に例えましょう。
GPUのすぐそばにあるHBM4は、データを素早く出し入れできる作業机のようなものですが、広さには限りがあります。一方、外部メモリやストレージは大きな倉庫です。たくさん置ける代わりに、机ほど簡単には取り出せません。
LLMが長い入力を処理し、回答を生成して文脈が伸びると、過去のトークンに対応するKey・Valueを保持するKVキャッシュも、一般に大きくなります。検索結果や検証内容を入力に追加する場合も、その分だけ文脈が長くなります。
ただし、検索や検証を実行すること自体が、必ず同じKVキャッシュを増大させるわけではありません。どの情報をモデルへ渡すか、文脈をどのように管理するかによって変わります。
作業机がいっぱいになれば、倉庫との往復が増えます。劇場では、主演俳優が次の台本を待つ状態です。
だからRubinはHBM4だけを強化するのではなく、DPUやネットワーク、BlueField-4 STXのような文脈データを扱う仕組みも重視します。
速いGPUを買うことと、速いAIシステムを作ることは同じではありません。
企業はVera Rubinをどう評価すべきか
企業がVera Rubinを評価する軸はGPUの最高速度ではなく、トークンコスト、通信・記憶の設計、電力・冷却、運用品質を合わせた実際の生産性である。
データセンターを作る企業が問うべきなのは、「最新GPUを何枚買うか」だけではありません。
どの顧客に、何のAI処理を、どれほどの応答速度とコストで提供するかです。GPU単体の性能が上がっても、ネットワークの混雑や冷却設備の限界によって成果が頭打ちになる場合があります。
| 評価軸 | 見るべきポイント | 実務上の意味 |
|---|---|---|
| 推論コスト | 円/100万トークン、トークン/Wh、稼働率 | 実際の利用料金・運営採算を左右する |
| 通信・記憶 | NVLink、ConnectX-9、Spectrum-6、KVキャッシュ | 処理の待ち時間と長文脈対応に影響する |
| 裏方処理 | BlueField-4、I/O、セキュリティ | GPUの空転を防ぎ、運用負荷を抑える |
| 運用制約 | 電力、液冷、保守性、障害時の復旧 | 公称性能を継続して使えるかを決める |
費用を比較するときは、入力トークンと出力トークンの単価を分け、同じモデル・品質条件・応答時間目標で比べる必要があります。
また、電力効率を比較する場合は、トークン/秒/MWのような単位電力当たりの処理スループットや、トークン/Whのようなエネルギー当たりの処理量を使います。
異なる指標を混同すると、実際の経済性を見誤ります。
Vera Rubinは、いつから使えるのか
NVIDIAは2026年3月のVera Rubin POD解説で、Vera Rubin NVL72について2026年後半の出荷予定を示しました。Groq 3 LPXについては、2026年8月に本格量産入りを発表し、Nebiusを最初のAIクラウド採用企業として挙げています。
ただし、プラットフォームの発表、量産開始、各クラウド事業者への納入、利用者向けサービス開始は同じ意味ではありません。
日本でもVera Rubinの導入計画が動き始めています。NVIDIAは2026年7月16日、Noetra Corp.との協力によるAIファクトリー構築計画を発表しました。Rubin GPU 27,500基、Vera CPU 13,750基を使い、140MW規模のデータセンター容量を計画しています。
この計画は、Vera Rubinが海外の技術発表にとどまらず、日本国内のAIインフラ整備にも関係していることを示しています。ただし、導入計画と稼働済みの設備は区別しなければなりません。
自社の導入計画では、実際に利用するクラウド事業者やシステムベンダーの提供時期、利用可能な地域、商用サービスの条件を確認することが重要です。
実務で確認したい利用シナリオ
例えば、社内チャットボットが短い回答を返すだけなら、極端に大きなラックを自社で保有する必要はありません。既存のクラウドサービスで十分な場合があります。
一方、数十万人が同時に使うAIサービスや、大きな文書を読み続けるエージェント基盤を提供する事業者では、トークン当たりの電力費やネットワークの混雑が利益に直結します。
AIデータセンターの計画を立てるときは、最初に業務の負荷を棚卸しします。
「回答が遅い」のか、「大量の利用者をさばけない」のか、「長い文脈でメモリが足りない」のか、「電力と冷却が限界なのか」。問題の正体を確認しないまま最新ハードウェアへ投資すると、違う場所にあるボトルネックは残ります。
そのうえで、モデルごとの入力・出力長、処理数、同時実行数、サービスレベル、電力単価を条件として置き、現行世代と新世代の費用を比べます。
サーバー導入コストだけでなく、ネットワーク、設備工事、保守、監視、障害対応まで含めて判断します。
ハードウェアの仕様表を、業務の処理単価と運用品質へ翻訳することが、企業にとって最も重要な作業です。
まとめ――AI劇場の経済そのものが変わる
Vera Rubinとは、Blackwellが進めたラックスケールAIを、低遅延推論・通信・記憶・冷却まで拡張し、AIファクトリー全体の生産性を追求する構想である。
Vera Rubinを一言で言うなら、主演を止めないために、劇場全体を作り替える設計図です。
GPUが主演なら、CPUは舞台監督、NVLinkは高速通路、DPUは物流、Groq 3 LPXは高速応答チーム。それぞれの役割が連携して初めて、公演は速く、安定して続きます。
BlackwellからRubinへの進化は、単にGPUの世代が変わる話ではありません。ラックからPODへ、さらにデータセンター全体へと、最適化する範囲が広がっていく変化です。
限られた電力と費用で、どれだけ有用なAI処理を生み出せるか。
NVIDIAがRubinで変えようとしているのは、GPUの性能だけではありません。AIという劇場の経済そのものです。
これからの主役は、最も速い俳優だけではない。すべての役者が一瞬も無駄なく動く、その劇場全体なのです。
専門用語まとめ
本文で登場した技術用語を、比較と仕組みの理解に役立つ最小限の定義で振り返る。
- Vera Rubin
- NVIDIAのGPU・CPU・通信・ストレージなどを統合するAIデータセンター基盤。
- NVL72
- 72基のGPUを高速接続して一体運用するラックスケール構成。
- Groq 3 LPU/LPX
- LPUは低遅延推論に用いるチップ、LPXは256基を搭載するラック。
- HBM4
- GPUに近接して大量のデータを高速に扱うメモリ技術。
- KVキャッシュ
- LLM推論で過去トークンの処理結果を再利用するための記憶領域。
- AIファクトリー
- 計算資源を使ってAIの学習・推論を継続的に提供する生産設備という考え方。
参考文献 / 出典
一次情報
- NVIDIA Newsroom — NVIDIA Vera Rubin Opens Agentic AI Frontier
- NVIDIA Technical Blog — NVIDIA Vera Rubin POD: Seven Chips, Five Rack-Scale Systems, One AI Supercomputer
- NVIDIA Technical Blog — Inside NVIDIA Groq 3 LPX: The Low-Latency Inference Accelerator for the NVIDIA Vera Rubin Platform
- NVIDIA Technical Blog — How NVIDIA Groq 3 LPX Unlocks Ultrafast Interactivity at Long Context on NVIDIA Vera Rubin
- NVIDIA Newsroom — NVIDIA Groq 3 LPX Now in Full Production With World-Class Speed for Agentic AI
- NVIDIA Form 10-K — Note 2: Groq(2026年2月25日提出)
- Groq Newsroom — Groq and NVIDIA Enter Non-Exclusive Inference Technology Licensing Agreement(2025年12月24日)
- NVIDIA — Vera Rubin NVL72
- NVIDIA — Groq 3 LPX
二次情報
合わせて読みたい
よくある質問(FAQ)
Vera Rubinの強み、Blackwellとの違い、Groq 3 LPXの位置づけという検索時に迷いやすい三点に答える。
Q1. Vera Rubinは何がすごいのですか?
Blackwellのラックスケール設計を受け継ぎ、新世代のCPU・GPU・メモリ・通信技術とGroq 3 LPXとの協調によって、AIデータセンター全体の処理効率を高める点です。 特に長文脈や多段階推論で生じるデータ移動・通信・応答遅延などの課題に対応します。
Q2. BlackwellとVera Rubinは何が違いますか?
Rubinは新世代GPU、Vera CPU、HBM4、NVLink 6などへ進化します。 Blackwellと同じ72 GPU・36 CPUのラックスケール構成を継承しながら、NVIDIAは特定条件で推論性能/ワットやトークンコストの改善を示しています。
Q3. Groq 3 LPXはNVL72の中に入っていますか?
いいえ。Groq 3 LPXは256基のGroq 3 LPUを搭載する独立したラックです。 Vera Rubin NVL72と組み合わせ、用途に応じて低遅延推論を支えます。
更新履歴
- :初版公開。初心者向けに、Vera Rubinを「AI劇場」の比喩で解説。
- :2026年版として全面改稿。Vera Rubin NVL72、Groq 3 LPX、Rubin GPU、Vera CPU、Spectrum-6、Vera Rubin POD、読み方、AIファクトリー視点、関連記事クラスターを反映。
- :Vera Rubinの7中核チップと5ラック構成を明確化。Groq 3 LPXの複数推論構成、Groqとの非独占ライセンス取引、NVIDIA公称値の注記を追加。
- :Blackwell比較、NVL72構成、Groq 3 LPXの性能条件、KVキャッシュの説明を精緻化。日本国内のNoetra計画と実務判断を追加。