※本記事は継続的に最新情報へアップデートしています。
「探していた情報は確かにデータベースにある。それなのに、AIは見当違いの資料を読んで答えてしまう」。RAGを開発していると、こんな壁に突き当たります。
根拠を選ぶ段階では、まず三つの問題を切り分けます。必要な資料が候補にないのか、候補にはあるのに上位に来ないのか、上位の資料が旧版など不適切なものなのか。二番目に対処するのがリランキング(Reranking/再順位付け)です。三番目は、版や権限の管理と組み合わせて対処します。
✅ 先に結論
リランキングとは、一次検索で集めた候補を、質問との関連性に基づいて再評価し、適切な順番へ並べ直す技術です。 BM25やベクトル検索で候補を広く集め、Cross-Encoderなどで精査する二段階構成が代表例です。RAGではLLMへ渡す根拠を選びやすくなりますが、一次検索で取り逃した情報を復活させることはできません。
リランキングとは?検索結果をもう一度吟味する技術

リランキングは、最初の検索で得た候補をより丁寧に調べ、質問に対して有用な順序に並び替える工程である。速く探す処理と、深く選ぶ処理を分けることに意味がある。
書店で「猫の飼い方」を探す場面を想像してください。店員が数万冊の本から、猫について書かれた本を50冊集めてくれました。ここまでは成功です。しかし一番上に並んだのが猫の写真集で、しつけの手引きが40番目だったら、あなたは困るでしょう。候補を見つけることと、その候補を正しい順序で見せることは別の仕事なのです。
検索システムでは、最初にBM25などのキーワード検索やBi-Encoderによるベクトル検索で候補を集めます。これを一次検索、あるいはRetrieval(検索・取得)と呼びます。次に、候補を質問と照らして再評価するのがリランキングです。上位数件を表示したり、RAGでLLMに渡したりします。
ここから登場する技術は同じ分類ではありません。BM25・BM25Fは主に候補取得、Cross-Encoderは質問と文書を評価するモデル構造、LTRは順位の学習方法、パーソナライズは利用者に合わせる目的を表します。複数を組み合わせることもできます。
ECサイトの商品検索、論文検索、動画推薦にも使われますが、この記事では特にRAGの検索品質を中心に見ていきます。RAG全体の仕組みはRAG完全ガイドに譲り、ここでは「見つけた後に、どう選ぶか」に集中します。まず、自社のRAGは「候補に入っていない」のか、「候補にはあるが上位に来ない」のかを区別してください。ここが改善の出発点です。
BM25アルゴリズムとは?高速に候補を集める技術
BM25は、検索語の出現頻度、珍しさ、文書の長さを考慮して関連度を計算する代表的な手法である。二段階検索では主に一次検索を担うが、既存候補の再スコアリングにも利用できる。
寿司屋を探すとき、「寿司」という言葉が何度も現れるレビューには目が留まります。けれど「寿司、寿司、寿司」と100回書いてあれば最高評価、というわけではありません。BM25はこの直感に近い仕組みを持っています。単語が現れる回数を評価しながら、増え続けた分の効果は次第に小さくします。
BM25を支える四つの考え方
- TF(単語頻度)と飽和:検索語が登場する回数は重要ですが、回数に比例して無制限に評価が上がるわけではありません。
- IDF(逆文書頻度):どの文書にもある一般的な語より、限られた文書に現れる特徴的な語を重視します。
- 文書長の正規化:長い文書ほど単語が登場しやすいという偏りを調整します。
- 調整パラメータ:
k1は単語頻度の飽和、bは文書長の補正の強さに関係します。
代表的な式は次のとおりです。検索クエリをq、候補文書をdとします。
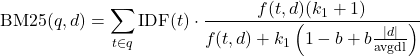
f(t,d)は文書中の語の頻度、|d|は文書長、avgdlは平均文書長です。式を暗記する必要はありません。「検索語が多い」「その語が珍しい」「文書が長いだけではない」の三点で候補を評価すると理解すれば十分です。なお、IDFの具体的な定義には実装差があります。
TF-IDFとの違いと、キーワード検索の限界
TF-IDFは語の頻度と希少性を組み合わせる重み付けの考え方で、対数TFやベクトル正規化など実装に幅があります。BM25は語頻度の飽和と平均文書長に基づく補正を、パラメータで調整します。ただし「寿司」で検索したとき、「大トロ」「握り」を意味が近いだけで自動的に加点するわけではありません。
一方、キーワードが一致しなくても意味が近い文書を見つけたい場合、BM25だけでは不十分なことがあります。たとえば「車の維持費」と「自動車のランニングコスト」のように、言い換えが多い質問です。そこで、意味の近さを捉えるベクトル検索と組み合わせるハイブリッド検索が有効です。
BM25Fアルゴリズムとは?文書構造を活かす検索技術
BM25FはBM25をフィールド付き文書に拡張し、タイトル・本文・タグなどの情報に異なる重みを与える手法である。文書のどこに検索語があるかを評価に反映できる。
図書館員に「猫のしつけ方を知りたい」と頼んだとしましょう。「猫のしつけ方講座」というタイトルの本と、本文の一か所に猫が登場する「動物行動学入門」。この二冊では、タイトルに書かれた言葉を強く評価したくなるはずです。BM25Fは、そのような文書構造の違いを数値に変えます。
例えばタイトルの重みを3、本文を1、タグを2と設定する設計があります。これは説明のための仮の値であり、あらゆる検索システムで正しい設定という意味ではありません。重要なのは、文書を単なる一続きの文章として扱わず、項目ごとの意味を反映できることです。
実装では、フィールドごとに長さ補正をかけたうえで語頻度や重みを統合し、スコアを計算します。「タイトルの重みを掛けて足すだけ」と考えると仕組みを単純化しすぎるので注意してください。ECなら商品名・カテゴリ・説明文、社内検索なら文書タイトル・部署・本文などに応用できます。
BM25Fは主に一次検索の精度を支える技術です。ここで取りこぼしを減らしておくことが、後段のリランキングを活かす前提になります。
Cross-Encoder(クロスエンコーダー)とは?質問と文書を照らし合わせるモデル
Cross-Encoderは、質問と候補文書を一組としてモデルに入力し、関連度を直接推定する方式である。意味を精密に評価できる一方、候補ごとに計算が必要なため速度と費用に注意が要る。
冒頭の書店に戻りましょう。店員が集めた50冊を、今度は目利きの店員がそれぞれの本の中身を確かめ、「猫のしつけ方を知りたい」という質問と本の中身を照らし合わせます。表紙の単語だけでなく、質問と本文を一緒に吟味する。これがCross-Encoderの発想です。
Bi-Encoderとの違い

| 比較 | Bi-Encoder | Cross-Encoder |
|---|---|---|
| 入力 | 質問と文書を別々にベクトル化 | 質問と文書を一組として入力 |
| 主な役割 | 多数の文書から高速に候補取得 | 取得した候補の精密な再評価 |
| 計算上の特徴 | 文書側を事前計算しやすい | 質問と候補の組ごとに推論が必要 |
| 得意分野 | 大量文書の意味検索 | 文脈を踏まえた関連性評価 |
典型的なBERT系Cross-Encoderでは、[CLS] 質問 [SEP] 文書 [SEP]という形式で二つのテキストをまとめて入力します。その相互作用を使って関連性スコアを求めます。ただし、実際の入力形式やスコア計算はモデルごとに異なります。
例えば、Bi-Encoderが数千件から50件を拾い、その50件をCross-Encoderが評価して上位5件を返す構成が考えられます。これらの件数は説明用の例で、必ず50件や5件にすべきという標準値ではありません。候補数を増やせば取りこぼしが減る可能性がある一方、推論回数や遅延が増えます。
Cross-Encoderのスコアは、必ずしも確率や絶対的な正しさを意味しません。同じ質問の候補を比較するための相対的な尺度として扱い、モデルごとの出力仕様を確認します。詳細はSentence Transformersの公式ドキュメントが参考になります。
学習ランキング(LTR)とは?経験から並べ方を学ぶ
学習ランキング(Learning to Rank、LTR)は、検索結果の順位を機械学習で最適化する考え方である。Pointwise・Pairwise・Listwiseは何を単位に学習するかの違いであり、モデル構造の種類を表すものではない。
経験豊かな店員は、ノートパソコンを探す客に対して、価格だけでなく重さ、バッテリー、レビュー、在庫も見て提案します。LTRは、このような複数の判断材料から、どの候補を上位にするかを学ぶ技術です。クリック履歴を使う場合もありますが、クリックだけが正解とは限りません。位置による偏りや、人気商品がますますクリックされる循環にも気をつけます。
- Pointwise:文書ごとに関連度を予測します。「この候補は5段階中いくつか」と採点する発想です。
- Pairwise:二つの候補を比べ、どちらを上に置くかを学びます。
- Listwise:候補のリスト全体の並びを評価し、順位品質を高めるように学習します。
代表的な実用手法にはLambdaMARTがあります。BM25スコア、文書の新しさ、クリック傾向、カテゴリ一致などを特徴量として活用できます。Cross-Encoderが計算したスコアをLTRの特徴量に組み込むことも可能です。つまり、Cross-EncoderとLTRは二者択一ではありません。「どのモデルで評価するか」と「どのように順位を学習するか」は別の問いです。
社内RAGで十分な教師データがない場合は、最初から複雑なLTRを学習するより、公開済みのリランカーを使って基準を作る方が現実的な場合もあります。評価用の質問と正解文書を用意できるかが、手法選択の分かれ目です。
パーソナライズドランキングとは?人によって変わる順位
パーソナライズドランキングは、利用者の履歴や状況に応じて候補の順位を調整する仕組みである。検索の関連性だけでなく個人への適合度を扱うため、透明性と公平性が重要になる。
同じ「動きやすい服」を検索しても、ランニング好きの人と仕事用の服を探す人では、欲しいものが違います。ファッションコーディネーターが好みや用途を聞いて提案を変えるように、検索システムも購入履歴、閲覧履歴、明示された好みなどを参考に順位を変えられます。
ただし、過去の好みに偏って順位を決めると、似た情報ばかりが提示され、新しい情報に触れる機会が狭まるおそれがあります。また、個人データの利用にはプライバシー保護が必要です。多様性を確保する手法の一例としてMMR(Maximal Marginal Relevance)がありますが、MMRとパーソナライズは同じ概念ではありません。
業務用RAGでは、関連性だけでなくアクセス権限を先に守る必要があります。権限のない文書をリランカーへ送ってから除く設計では、データ漏えいの危険が生じます。個人向け推薦の順位調整と、企業内文書のアクセス制御は分けて考えるべきです。
RAGで使うリランキングの処理フロー

RAGでは、一次検索で根拠候補を集め、リランキングで質問への適合度を評価し、上位文書をLLMへ渡す。重要なのは再順位付けだけでなく、候補取得から回答評価まで一体で設計することである。
ここで、もう一つ厄介な問題があります。社内規程の旧版の方が、質問によく合う説明を含んでいる場合です。それでも、現在のルールを答える根拠にすべきなのは現行版です。関連性スコアだけで、適切な根拠を選べるでしょうか。
今度は「社内の海外出張旅費規程における宿泊費の上限は?」という質問を考えましょう。社内文書には、旅費規程の旧版、新版、経理FAQ、ホテル予約手順が混在しています。検索では「宿泊」という単語を含む資料が多く引っかかりますが、回答に必要なのは有効な規程の該当条文です。
- 質問を受け取る:「海外出張」「宿泊費」「上限」などを含む問い合わせを受けます。
- 一次検索:BM25とベクトル検索を組み合わせ、権限のある文書から候補を集めます。
- 候補の整理:重複を整理し、アクセス権限を再確認します。現行規程の質問では有効な版に絞り、過去時点の質問では当時有効だった版を対象にして出典IDを保持します。
- リランキング:質問と各候補の関連性を評価し、根拠として有用な順に並べ直します。
- 回答生成:上位の適切な文書をLLMに渡し、出典を付けて回答させます。
- 評価:期待する根拠が含まれたか、回答がその根拠に忠実かを確かめます。
このとき注意すべきことが二つあります。第一に、リランキングは候補の並びを変えるだけで、存在しない根拠を作れません。正しい新版の規程が一次検索に含まれていなければ、後段でどれほど精密に並べ替えても正解には届きません。
第二に、関連性の高い文書が常に業務上の正解とは限りません。古い規程の説明が質問とよく一致しても、最新版かどうかは別問題です。有効日やアクセス権限を条件として扱い、リランキングのスコアだけに判断を任せない設計が必要です。
検索候補の数、採用するモデル、LLMへ渡す上位件数を変えて比較してみると、性能とコストの釣り合いが見えてきます。再検索や複数ステップの判断まで自律化したい場合は、Agentic RAGの実務判断ガイドが次の検討対象になります。
リランキングの導入判断|精度・遅延・コストをどう測るか
リランキングを採用するかは、モデルの評判だけで決めない。検索の取りこぼし、上位候補の品質、最終回答、処理時間、費用を同じ質問セットで比較する必要がある。
現場でよくある失敗は、リランカーを追加しただけで「精度が上がったはず」と判断することです。まず典型的な質問を集め、それぞれについて参照すべき正解文書を指定します。その上で、導入前と導入後を同じ条件で比較します。
| 指標 | 何を見ているか | 判断のポイント |
|---|---|---|
| Recall@k | 正解とする文書のうち上位k件に入った割合 | 一次検索の取りこぼしを確認 |
| nDCG@k | 関連度の高い文書が上位に来たか | 順位品質の改善を確認 |
| 回答品質・根拠忠実性 | LLMの答えが正しく、根拠を逸脱しないか | 検索改善が最終回答につながるか |
| p95レイテンシ | 応答時間の95パーセンタイル | 実運用の待ち時間に耐えられるか |
| 推論費用 | 再評価する候補数やモデル利用料 | 品質改善に見合う支出か |
Recall@kは、正解とした文書のうち上位k件に取得できた割合です。正解文書が一つなら質問ごとの値は0か1で、複数の質問を平均すれば取得成功率に相当します。正解文書が複数なら、そのうち何割を取得できたかを表します。また、リランキング後のRecall@5だけを見ても、一次検索段階で必要な根拠が拾えていたかは分かりません。候補取得時のRecall@50などと、最終段階の指標を分けて測ると原因を追いやすくなります。件数は例示であり推奨固定値ではありません。
p95レイテンシは、計測した応答時間の95パーセンタイルで、おおむね95%のリクエストがその時間以内に完了する目安です。リランキング工程だけでなく、検索から回答までの全体時間も同じ条件で測ります。
そもそも文書が少なく、キーワードだけで十分な答えが取れているなら、追加モデルは処理を重くするだけかもしれません。リアルタイム性が厳しいサービスでも、品質向上と待ち時間を比べる必要があります。逆に、候補は取れているのにノイズが上位を占める場合、リランキングの効果を検証する価値があります。
判断の目安は三つです。候補にあるのに上位へ来ないならリランキングを試す。候補にないなら一次検索やチャンク分割を見直す。遅延が厳しければ再評価する候補数を絞る。問題に合った手段を選ぶことが近道です。
最初は既存検索を基準に、リランカーを一つ追加して比べましょう。優劣が確認できてから、モデル変更、候補数調整、ハイブリッド検索との組み合わせへ進みます。「必ず精度が上がる技術」ではなく、「自社データで精度・速度・費用の最適点を探す技術」として扱うことが実務では重要です。
まとめ|速く探し、正しく選ぶ
検索品質を左右するのは、候補を集める速さと、候補を吟味する精度の両立である。リランキングはその後半を担い、RAGが読む根拠を改善する重要な手段となる。
最初の書店の場面に戻りましょう。候補を50冊集めるだけでは足りません。どの本に答えが書かれているのか、もう一度確かめてこそ、検索は役に立ちます。
BM25とBM25Fは候補探しを支え、Cross-Encoderは意味を吟味します。LTRは順位の付け方を学び、パーソナライズは利用者の文脈を反映します。ただし、どの仕組みも万能ではありません。取りこぼし、遅延、費用、権限、鮮度を一緒に設計する必要があります。
AIが何を答えたかを確かめる前に、何を読んで答えたのかを確かめる。その視点が、RAGを仕事で使える仕組みに近づけます。
専門用語まとめ
- Reranker(リランカー)
- 一次検索候補を再評価して順番を付けるモデルや処理。
- Bi-Encoder
- 質問と文書を別々にベクトル化し、類似度で検索するモデル構造。
- Cross-Encoder
- 質問と文書を一組として入力し、関連性を評価するモデル構造。
- nDCG
- 関連度の高い候補が上位に置かれているかを評価する順位品質の指標。
参考文献 / 出典
- Sentence Transformers, Cross-Encoder Applications(公式技術資料、確認日:2026年10月26日)
- Sentence Transformers, Retrieve & Re-Rank(公式技術資料、確認日:2026年10月26日)
- Robertson et al., Simple BM25 Extension to Multiple Weighted Fields(BM25Fの原著研究)
- Burges, From RankNet to LambdaRank to LambdaMART(学習ランキングの研究解説)
※記事内の数値設定・候補数は仕組みの理解のための例であり、実測結果や業界標準を示すものではありません。
次に読むならこの3本
よくある質問(FAQ)
Q1. 一次検索が良くなければリランキングで救えますか?
正解文書が候補にない場合は、リランキングだけでは救えません。一方、候補にはあるものの順位が低い場合は、改善する可能性があります。まず、必要な文書が一次検索の候補に含まれているかを確認しましょう。
Q2. BM25とCross-Encoderはどちらを使えばよいですか?
二者択一ではありません。BM25で高速に候補を集め、その一部をCross-Encoderで再評価する構成が考えられます。
Q3. 小規模なRAGでもリランカーは必要ですか?
必須ではありません。まず検索と回答の品質を測り、追加の遅延や費用に見合う改善が得られる場合に導入します。
更新履歴
- 2026年10月26日:BM25とリランキングの役割を整理し、RAG処理フローと導入評価指標を追加。旧版・現行版の扱いとp95レイテンシの説明も補足。
- 2025年8月21日:情報アップデート、読者支援機能強化。
- 2025年1月9日:初版公開。