※本記事は継続的に最新情報へアップデートしています。
Googleは、AlphaEvolveが見つけたスケジューリング改善によって、世界規模の計算資源の平均0.7%を継続的に回収していると報告している。
重要なのは0.7%という数字だけではない。その改善案がAIの一発回答ではなく、候補を作り、試し、採点し、良い案だけを残す「改善ループ」から生まれたことである。
Google DeepMindのAlphaEvolveとSakana AIのShinkaEvolveは、コードを書くAIから、試行錯誤そのものを自動化するAIへの転換を示している。
✅ 先に結論
AlphaEvolveとShinkaEvolveは、LLMにコードの改善案を作らせ、自動評価し、良い候補を残しながら改善を繰り返す「進化型コード最適化」の技術です。
- AlphaEvolve:Googleの重要インフラでの活用実績を持ち、2026年7月にGoogle Cloudで一般提供(GA)された商用・大規模運用寄りの基盤です。
- ShinkaEvolve:Apache 2.0のOSSとして公開され、複数のLLMプロバイダーを組み合わせながら自社環境で試しやすい基盤です。
- RSIとの違い:AlphaEvolveが主に改善するのは外部コード。RSIはAI自身やAI改善プロセスまで改善対象に広げる概念です。
Arpable編集部の調査概要
本稿は2026年10月6日時点の公式発表・論文・公開コード・提供状況を比較し、企業での使いどころまで整理した調査記事である。
今回の調査対象は、Google DeepMindのAlphaEvolve、Sakana AIのShinkaEvolve、進化的モデルマージ、DGM/RSI関連研究です。単なる技術紹介ではなく、「実際に企業で使えるのか」「何を改善対象にできるのか」「研究成果と商用サービスをどう区別するか」を重視しました。
調査の結果、両者の違いは単純な性能の優劣ではなく、公開性・運用形態・再現性をどこまで企業側がコントロールできるかにあることが見えてきました。
AlphaEvolveとは?――AIがコードを「書く」から「進化させる」へ
AlphaEvolveは、LLMを一度きりのコード生成器ではなく、改善案を繰り返し生み出す進化のエンジンとして使う仕組みである。
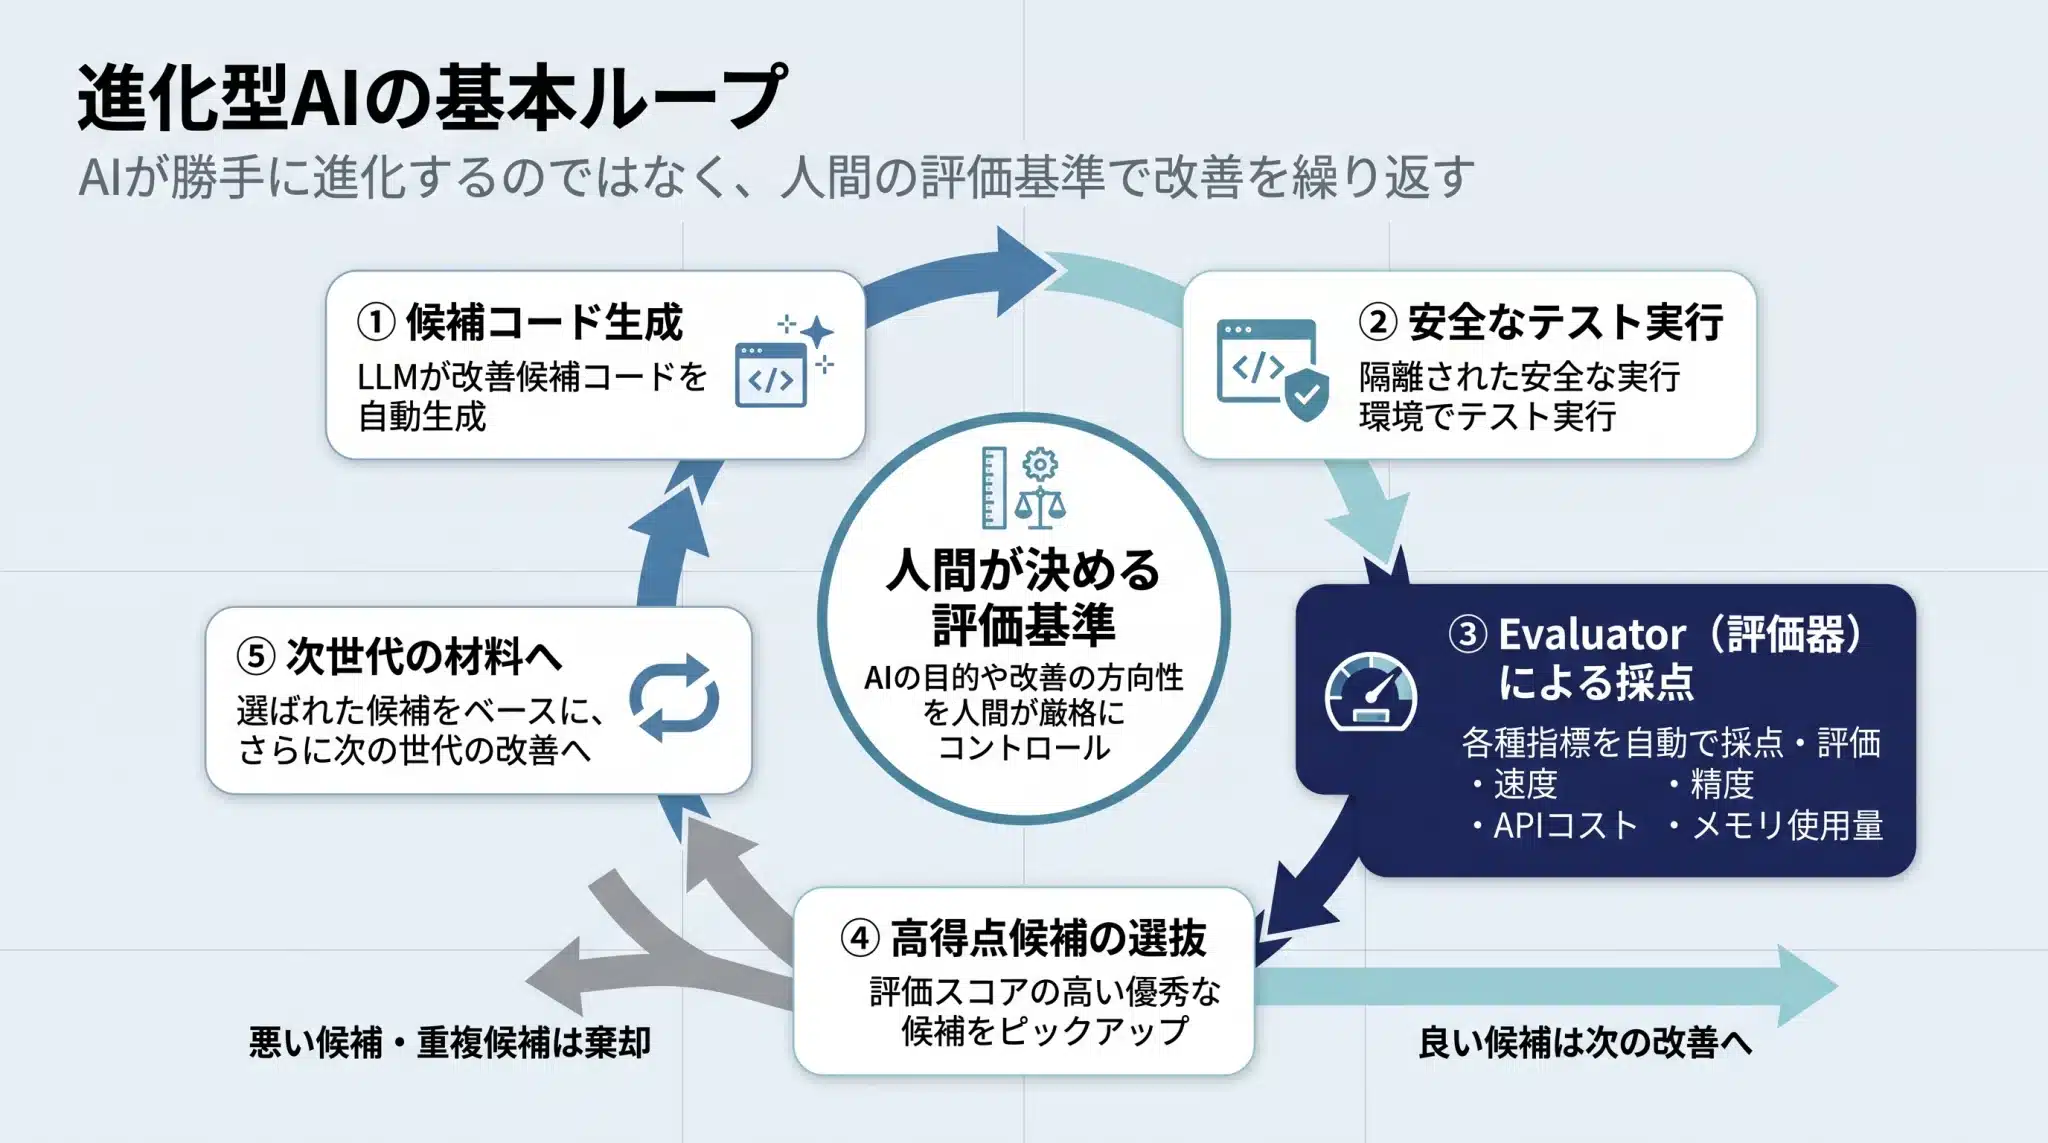
通常の生成AIに「このコードを高速化して」と頼めば、改善案を返してくれます。AlphaEvolveが違うのは、そこで終わらず、改善案を作る→実行する→採点する→良い案を残す→さらに改善するというループを繰り返すことです。
Google DeepMindはAlphaEvolveをGeminiを用いたコーディングエージェントとして開発し、数学問題だけでなく、Google自身の計算基盤やソフトウェア最適化にも適用してきました。つまり、これは単なる「AIコーディング」の延長ではなく、改善プロセスそのものの自動化と考える方が本質に近い技術です。
基盤LLMは今後も変わります。最新モデル名、API価格、提供状況は変動が速いため、最新情報は最新LLMモデル比較【2026年10月】に集約し、本記事では、モデル名や料金が変わっても通用する進化型AIの仕組みと判断軸に絞って解説します。
なぜ「進化」するのか?――重要なのは生成より評価
進化型AIの核心は候補を大量に作ることではなく、何が良いかを機械的に測り、改善方向を選び続けられる点にある。
たとえば、月間100万円分のLLM APIを使う業務ワークフローがあるとします。AIが複数の改善案を出し、同じ品質を保ちながらAPI費用、処理時間、失敗率を測れれば、最も費用対効果の高い案だけを残せます。次の世代は、その案を出発点にさらに改善できます。
逆に、良し悪しを測れなければ、AIはどの方向へ進めばよいか分かりません。だからAlphaEvolveやShinkaEvolveでは、速度、正確性、API料金、消費電力、メモリ使用量などを測るEvaluator(評価器)が重要になります。
何を「優秀」とするかは人間が決めます。 AIが自由に目的を決めるのではなく、人間が作った物差しの中で「生成→実行→評価→選抜→改善」を回す。ここが進化型AIの出発点です。
料理にたとえるなら、LLMは何百皿も試作できるシェフで、Evaluatorは味見役です。どれだけ優秀なシェフでも、「何がおいしいか」という採点基準がずれていれば、改善するほど本来の目的から離れてしまいます。
AlphaEvolveは何を成し遂げたのか
AlphaEvolveの重要性は数学上の記録だけではなく、Google自身の高価値な本番処理へ改善ループが入り始めた点にある。
AlphaEvolveは行列乗算などの数学的問題で注目されましたが、企業にとってより重要なのは実運用です。Google DeepMindは、AlphaEvolveが発見したスケジューリング・ヒューリスティックをBorgクラスタ管理システムへ導入し、Googleの世界規模の計算資源の平均0.7%を継続的に回収したと報告しています。また、Gemini向け行列演算カーネルを23%高速化し、学習時間を1%短縮したことも報告されています。
その後、AlphaEvolveは次世代TPU設計の最適化に定常的に使われるようになり、Google Spannerではwrite amplificationを20%削減しました。さらに、新しいコンパイラ最適化戦略ではソフトウェアの保存容量を約9%削減する知見にもつながったとGoogle DeepMindは説明しています。
そして2026年7月にはGoogle Cloudで一般提供(GA)が始まり、外部企業が自社側で候補コードを評価しながらAlphaEvolveを利用できる段階へ進みました。「面白い研究」から「企業が使える最適化基盤」へ立場が変わったと見るべきでしょう。
ただし、Googleや顧客企業が公表する改善率はタスクや条件が異なります。数字を横並びにして「何倍優秀」と判断するのではなく、何を、どの評価条件で改善した数字なのかを見る必要があります。
AlphaEvolveはRSIなのか?
AlphaEvolveは外部コードを改善する技術であり、AI自身やAI開発ループを再帰的に改善するRSIとは同義ではない。
「AIがコードを自分で書き換えるなら、これはRSIではないのか」と感じるのは自然です。しかしAlphaEvolveが主に変更するのは、スケジューリングコード、GPUカーネル、アルゴリズム、数学的構成などの外部プログラムです。
一方、RSI(Recursive Self-Improvement/再帰的自己改善)が問題にするのは、AI自身のコード、推論方法、メモリ、学習方法、さらに「AIを改善する仕組み」そのものまで改善対象に入る世界です。2026年時点の自己改善AIを4段階で整理した自己進化型AIとは?AIの自己改善は“Critical”に近づいたのか【2026年版】でも、この境界を詳しく解説しています。
一言で分けるなら、AlphaEvolveは「AIがコードを改善する」、RSIは「AIがAI自身を改善する」です。将来この境界が近づく可能性はありますが、現時点で同じものとして扱うべきではありません。
ShinkaEvolveとは?――「無駄打ち」を減らすSakana AIの発想
ShinkaEvolveは、改善案を闇雲に試すのではなく、試す価値の高い方向へ計算予算を集中させるOSSの進化基盤である。
ShinkaEvolveを理解するのに、Parent SamplingやBanditといった研究用語は不要です。出発点は単純です。AIに何百回も改善案を作らせると、似た案や失敗済みの案を何度も試す「無駄打ち」が増えます。 ShinkaEvolveは、この無駄を減らすための仕組みです。
そこでShinkaEvolveは、まだ十分に試していない有望な方向を残し、過去の案とほとんど同じ候補は実行前に落とし、改善案をよく生むLLMへ多くの予算を振り向けます。研究上はParent Sampling、Novelty Rejection、Bandit-based Model Selectionと呼ばれます。ですが、経営者が押さえるべきことは一つです。「試行錯誤そのものを効率化する」ことです。
Sakana AIはShinkaEvolveをApache 2.0のオープンソースとして公開しており、複数のLLMプロバイダーを組み合わせながら自社環境で検証しやすい方向を選んでいます。Sakana AI全体の研究思想やM2N2、Namazu、Fuguとの関係はSakana AIとは?何をしている会社かをM2N2・Namazu・Fuguから読み解く【2026年版】で整理しています。
「150回で解いた」は何がすごいのか
ShinkaEvolveが注目された成果の一つが、26個の円を正方形へ詰める円充填問題です。Sakana AIは、150候補の評価でAlphaEvolveが報告した円充填解をわずかに上回る解を発見したと報告しています。差そのものは小さい一方、少ない試行で同水準以上へ到達した点が、ShinkaEvolveのサンプル効率を示す例として注目されました。
ただし、AlphaEvolve側は同じ円充填実験について正確な候補数を開示しておらず、利用LLM、評価予算、検証許容誤差も完全にはそろっていません。したがって「ShinkaEvolveはAlphaEvolveより何倍効率的」と定量的に断定することはできません。
見るべきなのは勝敗ではなく、研究の焦点が「大量に試す」から「少ない試行で良い探索をする」へ移っていることです。
AlphaEvolveとShinkaEvolveは何が違う?
両者は改善ループを共有する一方、AlphaEvolveは商用・大規模運用、ShinkaEvolveは公開性・自由度・試しやすさに重心がある。
| 観点 | AlphaEvolve | ShinkaEvolve |
|---|---|---|
| 主な対象 | コード・アルゴリズムの探索と最適化 | コード・アルゴリズムの探索と最適化 |
| 提供形態 | Google CloudのGemini Enterprise上で一般提供(GA) | Apache 2.0のOSS |
| 導入条件 | Gemini Enterpriseの利用環境と、自社側で候補コードを評価できる実行環境 | Python環境、利用するLLMのAPI設定、候補コードを安全に実行できる評価環境 |
| 基盤LLM | Gemini系 | 複数のLLMプロバイダーを組み合わせて利用できる設計 |
| 強み | Googleの重要インフラでの活用実績と、Google Cloudでの一般提供 | 自由度、公開性、再現・検証のしやすさ |
| 中身の確認 | 探索システム本体は非公開部分が多い | 実装を確認・改造できる |
| 向く場面 | 商用基盤として大規模最適化を回したい | まず自社課題で試し、仕組みを検証したい |
| ※2026年10月6日時点。提供条件・対応モデル・料金は変動するため、導入時は公式情報を再確認してください。 | ||
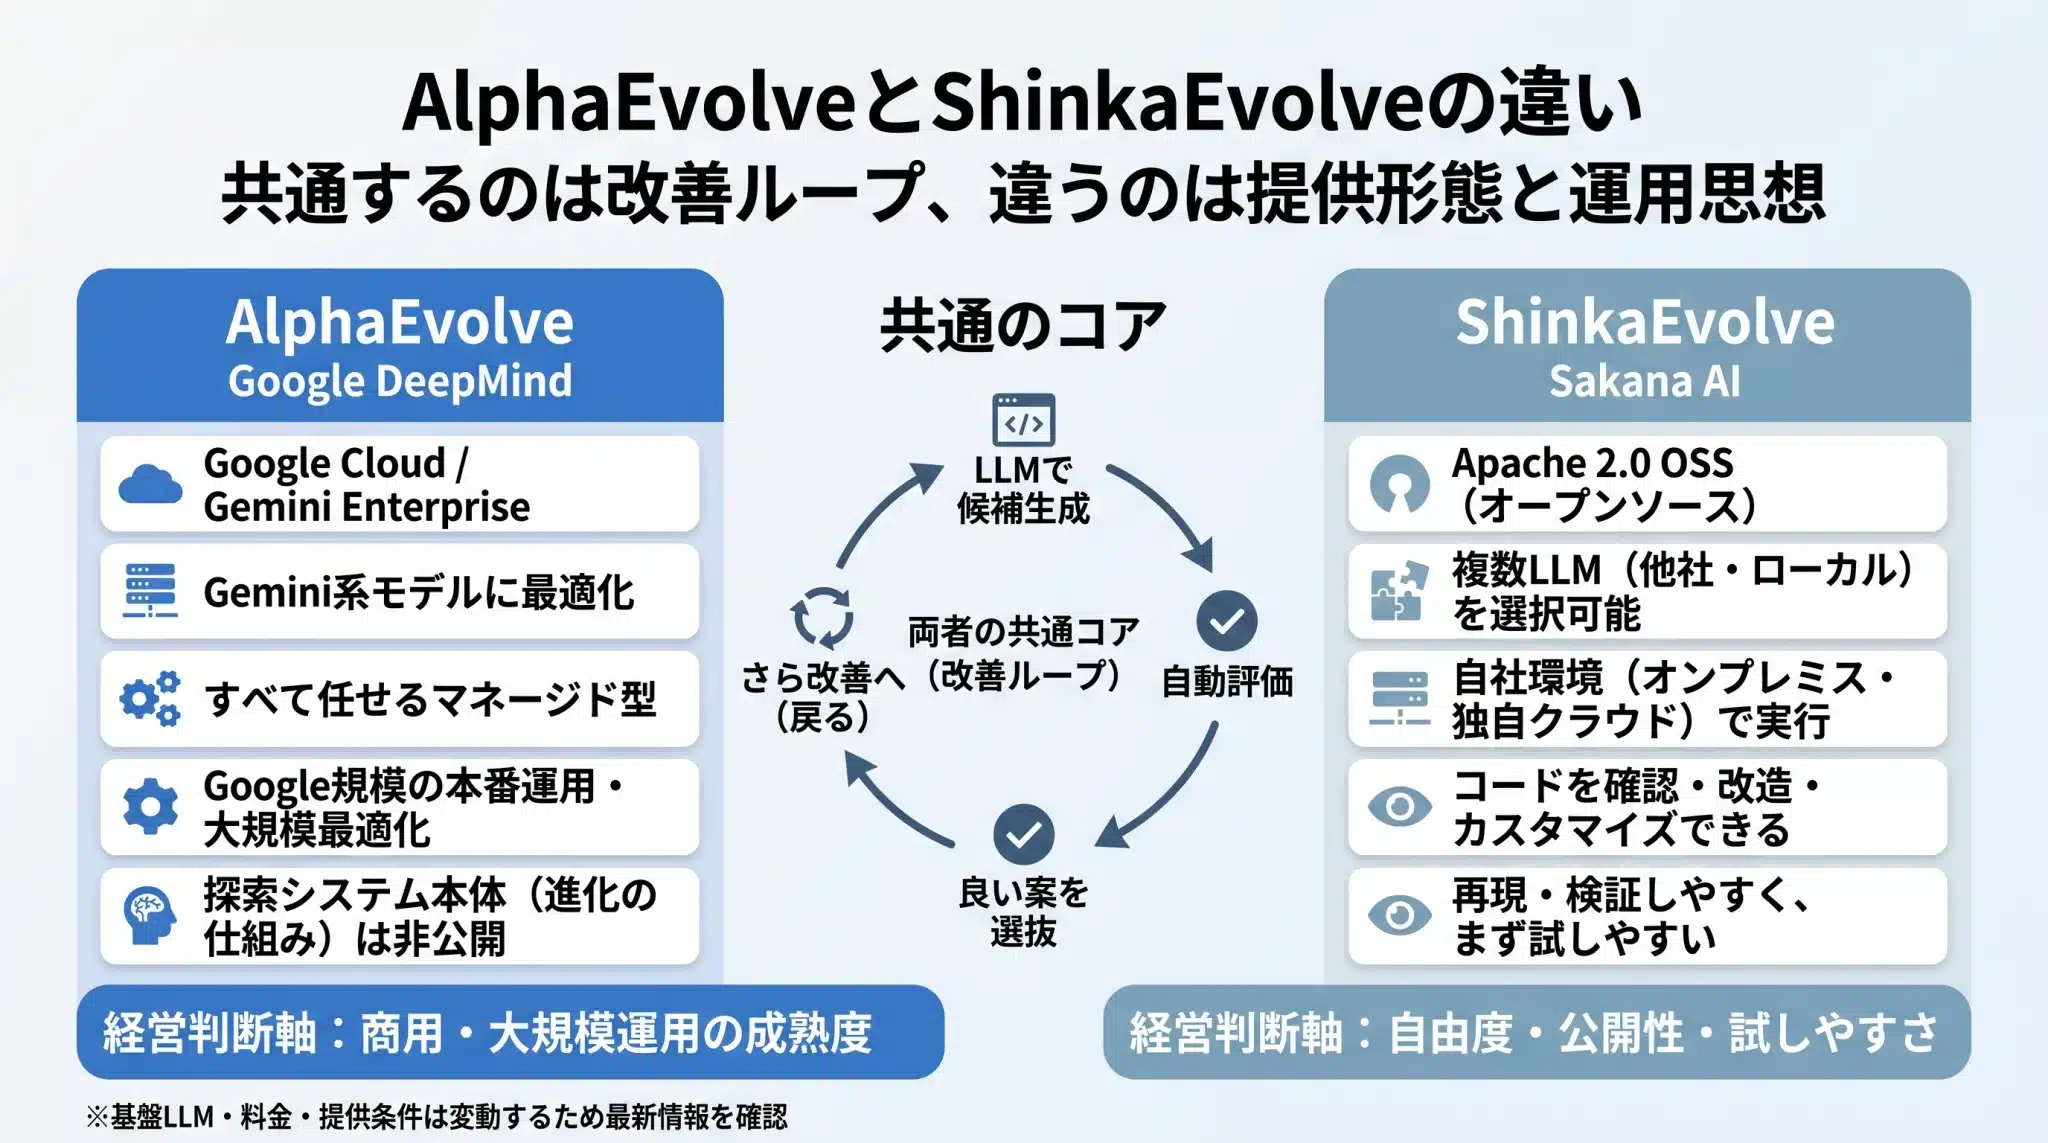
企業が選ぶべきなのは、どちらが上かというランキングではありません。まず自社で中身を見ながら試したいならShinkaEvolve、大規模な最適化をマネージド環境で回したいならAlphaEvolveという違いで考える方が実用的です。
たとえば、毎月数百件を処理するバッチ、複数LLMを使う調査ワークフロー、配送や人員配置の計算、画像・動画処理などです。正答率、処理時間、API費用、失敗率を数字で測れる処理なら、進化型AIの候補になり得ます。
さらに、進化型AIの結果は基盤LLMにも影響されます。最強モデルを一つ固定するのではなく、仕事に応じてモデルを配置する考え方はLLMモデルポートフォリオ設計2026ともつながります。
自分たちでも試せるのか?
ShinkaEvolveを試す条件は研究者であることではなく、改善対象を数字で採点でき、安全な環境で候補コードを実行できることである。
非研究者のエンジニアでも、まず3つの質問にYESと答えられるなら試す余地があります。「良し悪しを数字で測れるか」「すでに動くコードやワークフローがあるか」「失敗しても安全に試せるか」です。
良し悪しを数字で測れるか
処理速度、正答率、API費、レイテンシー、メモリ使用量など、候補を機械的に採点できる指標が必要です。主観だけで決める「文章の魅力」や「ブランドらしさ」は、最初の題材には向きません。
すでに動くものがあるか
ShinkaEvolveは、何もないところから素晴らしい企画を作る技術ではありません。既存のAPIルーティング、バッチ処理、アルゴリズム、LLMエージェント構成を「もっと速く、安く、正確にできないか」と改善する用途に向いています。
失敗しても安全に試せるか
進化型AIは大量の候補コードを生成するため、本番環境へ直接入れるべきではありません。sandboxやテスト環境で実行し、静的解析や単体テストを通し、最終的には人間が採用を判断する設計が必要です。
Arpable編集部の調査では、最初の用途としてLLMワークフロー、アルゴリズム、バッチ処理、APIルーティングを有望と評価しています。最初に考えるべきなのは「ShinkaEvolveの使い方を覚えるか」ではなく、「自社に、数字で採点できる改善作業があるか」です。
🚀 試すなら、まず1つだけ選ぶ
- 数字で採点できる処理を1つ選ぶ:API費、処理時間、正答率などを測れる既存業務を対象にします。
- 現在の処理を基準値として固定する:改善前の品質・時間・費用を測ります。
- 評価器を先に作る:良い案と悪い案を自動で判定できるようにします。
- sandboxで小さく試す:改善コードは直接本番へ入れず、人間がレビューして採用します。
最初に学ぶべきなのはShinkaEvolveの操作方法ではなく、「何を良いとするか」を数値化する方法です。
AlphaEvolve・Transformer²・モデルマージ・RSIは何が違う?
「進化」「適応」「自己改善」は同義ではなく、何を変更対象にする技術かを見るとAlphaEvolveとRSIの境界が明確になる。
| 技術 | 主に何を変えるか | 直感的な理解 |
|---|---|---|
| AlphaEvolve | 外部コード・アルゴリズム | コードを進化させる |
| ShinkaEvolve | 外部コード・アルゴリズム | 無駄を減らしながらコードを進化させる |
| Transformer² | 推論時の重みの使い方 | 仕事に合わせて頭の使い方を変える |
| Evolutionary Model Merge | モデルの重み・組み合わせ | 複数モデルを進化的に融合する |
| DGM / RSI | AI自身・AI改善プロセス | AIがAI自身の改善へ踏み込む |
| ※左から右への時間軸や成熟度を示す表ではなく、「変更対象」の違いを整理したものです。 | ||
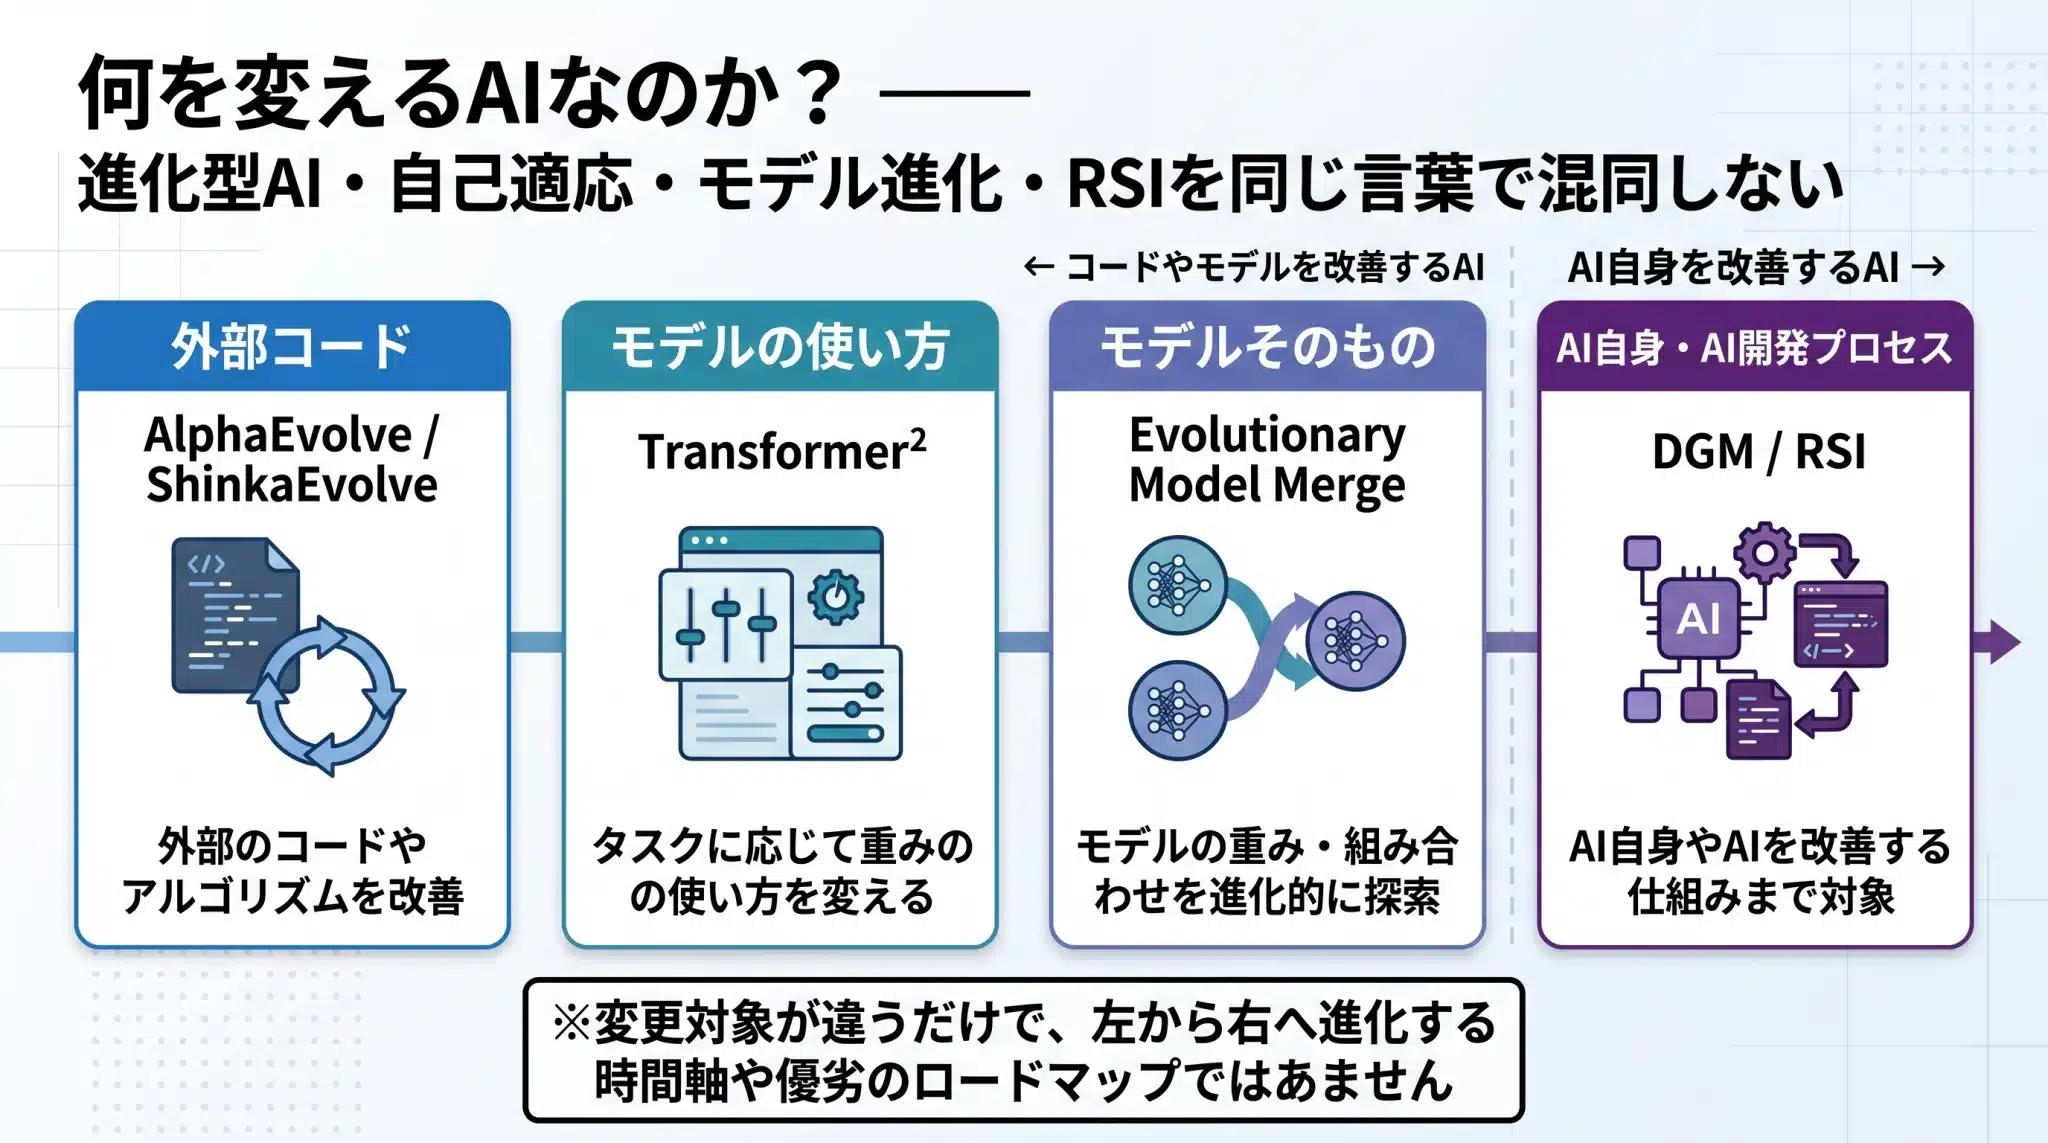
Sakana AIのTransformer²とは?Sakana AIの自己適応LLMをわかりやすく解説【2026年版】は、推論時にタスクへ合わせてモデル内部の重みの使い方を変える研究です。AlphaEvolve/ShinkaEvolveのように外部コードを進化させる技術とは、変更対象が違います。
「何を変えているのか」「誰が評価しているのか」「改善結果がどこへ戻るのか」の3点を見ると、進化型AIと自己改善AIを混同しにくくなります。
GoogleとSakana AIは共同開発しているのか
GoogleとSakana AIは、2026年1月に戦略的パートナーシップ締結とGoogleによる出資を発表しています。Sakana AIはGeminiやGemmaを研究・製品開発へ活用する方針です。
ただし、この提携は、AlphaEvolveとShinkaEvolveの共同開発を意味しません。 両者が共同開発されたことを示す一次情報は、2026年10月6日時点で確認できません。
一次情報からどこまで言えるか
進化型AIは実際に成果を出しているが、「AIが勝手に自己進化を始めた」とまで言える一次情報は存在しない。
AlphaEvolveから確認できるのは、客観的に採点できるコードやアルゴリズムについて、LLM生成と自動評価を反復することで、人間が作った既存解を上回る候補を発見できることです。ShinkaEvolveから確認できるのは、同じタイプの探索を、公開された仕組みでより効率的に回す方向を追求できることです。
一方、AIが自分で目的を自由に変更すること、あらゆる業務で人間の判断なしに改善を続けること、より強い後継AIを自律的に作り続けることまで実証されたわけではありません。「コードを改善するAI」と「AI自身を再帰的に改善するAI」の間には、まだ大きな境界があります。
円充填の比較でも、探索予算、使用モデル、評価条件はそろっていません。前述のとおり、異なる条件の数字を倍率に変換して優劣を語ることは避けるべきです。
まとめ――競争軸は「最高の答え」から「改善ループ」へ
AlphaEvolveとShinkaEvolveが示した変化は、AI競争の軸が単発の生成性能から、改善を継続できる仕組みへ広がったことである。
生成AIの競争は長い間、「どのモデルが一番賢いか」で語られてきました。しかしAlphaEvolveとShinkaEvolveを見ると、その次の競争軸が見えてきます。
候補を作る。測る。失敗を捨てる。良いものを残す。そこからさらに改善する。人間が昔から行ってきた試行錯誤を、AIが数十回、数百回と高速に回せるようになり始めています。
だからこそ、進化型AIの時代に重要になるのはLLMそのものだけではありません。何を「良い」と判定するのかを設計する力です。評価器が間違っていれば、AIは間違った目標へ猛烈な速度で最適化します。
AlphaEvolveとShinkaEvolveが示しているのは、AIが人間の代わりに目的を決める未来ではありません。人間が「何を良くしたいか」を決め、AIがその問いに何百回も挑む未来です。
次のAI競争で差になるのは、最強のモデルを一つ持つことだけではありません。測れる目標を定め、失敗から学び、改善を続けられるループを持つこと。 その設計力が、企業のAI実装力になります。
あなたの会社で、誰かが毎週「直しては測る」を繰り返している仕事は何でしょうか。 その答えが、進化型AIを試す最初の候補です。
専門用語まとめ
本文で使った進化型AIの主要用語を、非研究者でも記事へ戻らず確認できるよう短く整理する。
- Evaluator(評価器)
- 生成された候補コードを、速度・精度・コストなどの指標で機械的に採点する仕組みです。
- サンプル効率
- 何回の試行・評価で良い解へ到達できるかを表す考え方です。少ない試行で同等以上の結果を出せれば、サンプル効率が高いと考えます。
- OSS
- Open Source Softwareの略。ソースコードが公開され、ライセンス条件の範囲で利用・改変できるソフトウェアです。
- Sandbox
- 生成コードが失敗しても本番環境へ影響を与えないよう、隔離して安全に実行する環境です。
- RSI
- Recursive Self-Improvement(再帰的自己改善)。AIがより高性能なAIや改善手法を作り、その成果を次の改善へ再利用する概念です。
参考文献 / 出典
数値・提供状況・技術構成は、Google DeepMind、Google Cloud、Sakana AI、論文、公式リポジトリを優先して確認した。
- Google DeepMind:AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms
- Google DeepMind:AlphaEvolve: How our Gemini-powered coding agent is scaling impact across fields
- AlphaEvolve technical paper / arXiv
- Google Cloud:Gemini Enterprise Release Notes
- Google Cloud:AlphaEvolve is available for everyone
- Sakana AI:ShinkaEvolve
- ShinkaEvolve paper / arXiv
- SakanaAI / ShinkaEvolve GitHub Repository
- Sakana AI:RSI Lab
- Sakana AI:Googleとの戦略的パートナーシップ
次に読むならこの3本
進化型AIをさらに理解するなら、Sakana AI全体像、RSIの現在地、基盤LLMの変動情報を分けて読むと理解しやすい。
更新履歴
本記事は進化型AIの提供状況とSakana AIの研究進展に応じ、意味のある差分が生じた場合に更新する。
- 2026年10月6日:AlphaEvolveとShinkaEvolve比較を軸に全面改訂。RSIとの違い、企業で試す判断基準、Google CloudでのGA、最新提供状況を反映。