※本記事は継続的に最新情報へアップデートしています。
VLM(Vision-Language Model/視覚言語モデル)とは、画像・図表・文書・画面・動画などの視覚情報と言語を結びつけて理解するAIモデルです。LLMが主に言葉を手がかりに考えるのに対し、VLMは「見なければ判断できない仕事」まで受け持てます。
しかし、「画像が読めるAI」という理解だけでは、2026年のVLMは説明しきれません。画像理解そのものは、すでに主要な生成AIへ広く組み込まれているからです。差が出るのは、動画・文書・図表・画面をどこまで理解し、その視覚情報を業務判断へつなげられるか。本記事では、LLM・OCR・VLAとの違いから、自社にVLMが本当に必要かを判断する方法までを整理します。
- LLMとの違い:文章だけで判断できるならLLM、画像・図表・画面を根拠にするなら視覚理解が必要です。
- OCRとの違い:決定性・監査性が必要な文字抽出はOCR/Document AI、文脈や図表の理解はVLMが向きます。実務では併用が基本です。
- VLAとの違い:VLMは「見て理解し答える」、VLAは「見て判断し動く」モデルです。
- 2026年の競争軸:画像対応の有無ではなく、動画・文書・GUI・現場データをどこまで扱えるかへ移っています。
- 企業導入:非定型文書、マルチモーダルRAG、GUI操作、製造検査の判断支援が有力です。ただし、VLMを使わない方がよい仕事もあります。
VLMとは?画像・文書・画面を「見て理解する」AI
VLMは視覚情報と言語を同じ文脈で扱い、画像の説明から文書読解・画面理解まで担うAIモデルである。
VLM(Vision-Language Model:視覚言語モデル)とは、画像・図表・文書ページ・画面・動画フレームなどの視覚情報と、テキストによる言語情報を結びつけて理解・推論するAIモデルです。
従来、コンピュータビジョンと自然言語処理は別々に発展してきました。画像認識モデルは「猫がいる」「部品に傷がある」と判定し、LLMは文章を読み、要約し、質問に答えてきました。しかし現実の仕事では、画像と文章は切り離せません。
契約書には表があり、製造マニュアルには図があり、Web画面にはボタンやフォームがあります。VLMは、こうした視覚と言語が混ざった情報を同じ文脈で扱うための技術です。
たとえば、請求書の金額を決まった欄から転記するだけならOCRでよいでしょう。けれども、図表入りの提案書を読み「なぜ売上が落ちたのか」を説明したり、画面を見ながら業務システムへの入力候補を判断したりするには、文字列だけでは足りません。そこで必要になるのが、視覚情報を意味として扱うVLMです。
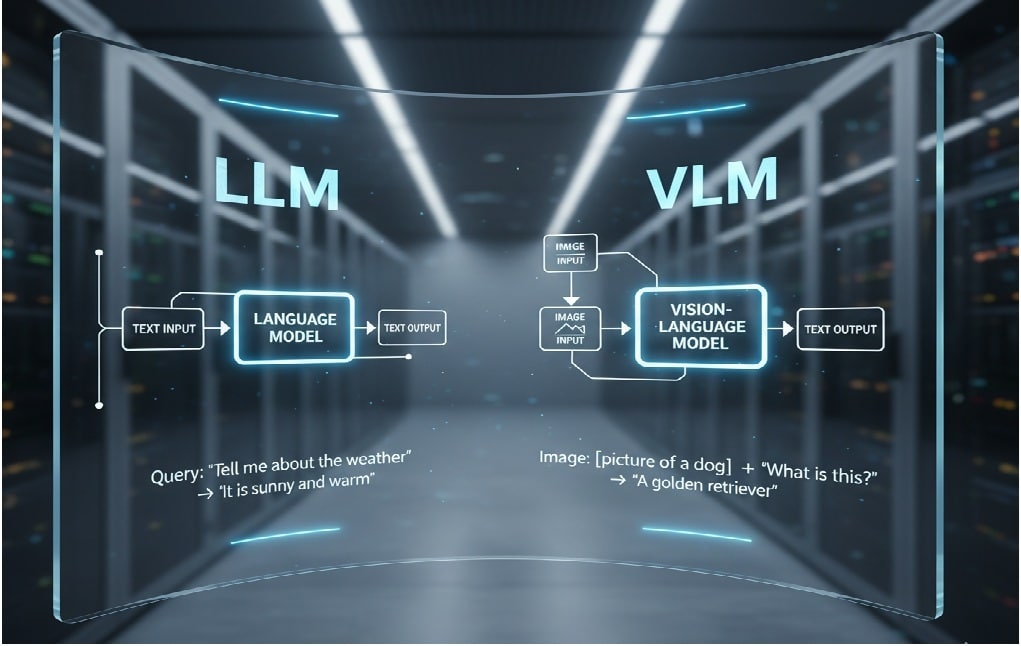
図1 LLMは主に言葉を手がかりに考え、VLMは視覚情報も判断材料に加える。
VLMを直感的に理解する:AIが目隠しを外したという比喩
VLMを直感的に理解するなら、「目隠しをして会話していたAIが、目隠しを外した」状態です。テキスト中心だった初期のLLMは、非常に賢い会話相手でありながら、写真や図表、画面そのものを根拠に判断することはできませんでした。
VLMはそこへ視覚情報を加え、画像と文字を結びつけて扱えるようにしました。2026年現在は、この「見る力」が主要な生成AIへ統合されています。そのためVLMを独立した製品名というより、AIが持つ視覚理解能力として捉える方が実態に近くなっています。

図2 VLMは、文字だけで会話していたAIに、画像や画面を理解する能力を加えた技術である。
VLMとマルチモーダルAIはどう違うのか
VLMは視覚と言語を扱うマルチモーダルAIの一種です。マルチモーダルAIは、さらに音声やセンサー情報なども含めて複数種類の情報を扱う、より広い概念です。2026年の主要製品では「マルチモーダルモデル」という呼び方が増えていますが、本記事ではその中でも「見て理解する力」に焦点を当ててVLMと呼びます。
VLMはどのように「見て・理解する」のか
VLMの仕組みは、非エンジニアでも3つの役割で考えると理解しやすくなります。
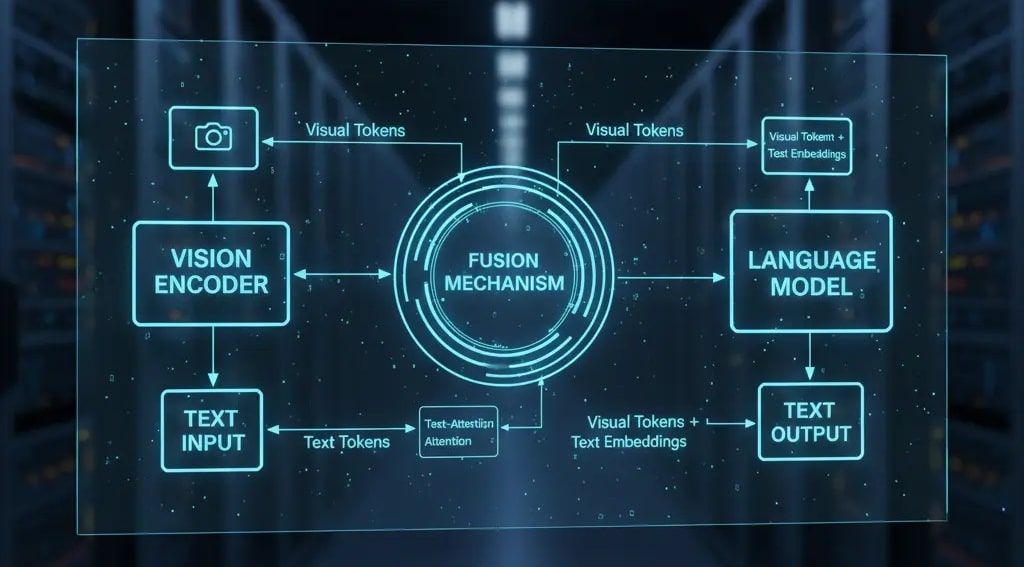
図3 VLMは、視覚情報と言語情報を統合し、画像や文書を同じ文脈で扱う。
- 視覚エンコーダ:画像をAIが計算できる特徴へ変える「翻訳者」。
- 融合機構:画像と質問を同じ文脈に並べる「編集者」。
- 言語モデル:整理された情報をもとに答える「専門家」。
初期のVLMには、画像認識モデルで取り出した特徴を後からLLMへ接続する構成が多くありました。現在は、学習の早い段階から画像とテキストを統合するネイティブ・マルチモーダルな設計も広がっています。
技術構成で重要なのは、画像を文章へ変換すること自体ではありません。図表、文書、画面、現場画像に含まれる情報を、次の判断や業務フローへ接続できる点にVLMの価値があります。
この「翻訳者・編集者・専門家」の3役が連携することで、VLMは画像を見るだけでなく、その情報を次の業務判断へ渡せるようになります。
VLMとLLM・OCR・VLAの違い
VLMの境界は製品名ではなく、文章・抽出・視覚推論・行動のどこまでをAIに担わせるかで決まる。
2026年現在、LLMとVLMは製品として完全に分かれているとは限りません。主要な生成AIには視覚理解が統合されているため、実務ではモデル名よりも「文章だけで判断できるか」「視覚情報が判断を左右するか」「正確な文字抽出が必要か」「物理的な行動まで必要か」で使い分ける方が実用的です。
| 種類 | 主な判断材料 | 主な出力 | 向いている仕事 |
|---|---|---|---|
| LLM | 文章、数値、ルール | 文章、回答、推論結果 | 要約、翻訳、文章生成、質問応答 |
| OCR/Document AI | 文字、位置、項目 | テキスト、項目値、信頼度 | 定型帳票、大量処理、監査が必要な転記 |
| VLM | 画像、図表、文書、画面、動画 | 説明、回答、判断 | 非定型文書、図表解釈、画面理解、検査支援 |
| VLA | カメラ映像、言語指示、ロボット状態 | 動作指令 | ロボット操作、作業実行 |
| ※境界は製品によって重なります。特にLLMとVLM、OCRとVLMは、実務では組み合わせて使うケースが増えています。 | |||
請求書の金額を決まった欄から抜き出すだけならOCR/Document AI、図表入りの提案書から売上低下の理由を読み解くならVLM、画面を見てシステムへ入力するならVLM+computer use、ロボットを動かすならVLAが候補になります。
OCRとVLMの判断軸:決定性か、文脈理解か
「文字を読むだけならOCR、意味まで理解するならVLM」という説明だけでは、2026年の実務には不十分です。より重要なのは、決定性・監査性を優先するならOCR/Document AI、文脈や図表の推論が必要ならVLM、実務では両者を組み合わせるという考え方です。
Microsoft、Google、AWSも、文字・位置・項目を安定して抽出する仕組みと、生成AIによる意味理解を分けて提供しています。記号や桁数を一文字も間違えられない処理はOCR側に任せ、VLMには例外判断や意味づけを担わせる方が安全です。
自社の仕事にVLMは必要か:4つの問い
- 文章だけで判断できるか。できるなら、LLMで足ります。
- 一文字の誤りも許されない、または監査が必要か。そうなら、OCR/Document AIを軸にします。
- 図表・画面・現場画像の意味が、判断を左右するか。そうなら、VLMの出番です。必要に応じてOCRと組み合わせます。
- 物理的な動作まで任せたいか。そうなら、VLAの領域に入ります。
2026年のVLMは何が変わったのか
画像理解は標準機能になり、競争軸は文書・動画・GUI・行動へ移ったことが2026年の最大の変化である。
2026年のVLMで重要なのは、「画像を読めるようになった」ことではありません。画像理解そのものは主要な生成AIへ広く組み込まれ、競争軸はその先へ移っています。画像から文書へ、静止画から動画へ、画面理解からcomputer useへ、そして理解からVLAによる行動へ。この変化を見ると、VLMが企業業務へ入り始めた理由が分かります。
2026年版で押さえる4つの変化
- 画像説明から文書理解へ:PDF、帳票、図表、技術資料を文字とレイアウトを含めて扱う。
- 静止画から動画・時間理解へ:「何が写っているか」だけでなく、「いつ何が起きたか」を扱う。
- 画面理解からcomputer useへ:VLMの視覚理解をAIエージェントが利用し、クリックや入力へつなげる。
- 理解からVLAによる行動へ:視覚・言語理解を、ロボットの計画と動作へ接続する。
画像理解:もはや「できるか」では差がつきにくい
OpenAI、Google、Anthropic、Meta、Qwen、InternVLなどの主要系列は画像理解に対応しています。写真の説明、スクリーンショットの読み取り、図表への質問は標準的なユースケースになりました。したがって、選定軸はどの種類の視覚情報を、どの精度で扱えるかへ移っています。
動画理解:対応差が大きい
動画は、2026年時点でもモデル間の差が大きい領域です。Googleの公式ドキュメントでは、Gemini 3系は音声付きで約45分、音声なしで約1時間までの動画を直接入力でき、1回のプロンプトで最大10本まで扱えます。
一方、OpenAIのGPT-6 SolとGPT-5.5は、2026年10月7日時点の公式モデルページで動画入力が「Not supported」とされています。Anthropicについては、同日時点の公式資料で、動画の直接入力に関する記載を確認できていません。
「VLMなら動画も扱える」と一括りにしてはいけません。動画が業務の中心なら、動画を直接入力できるか、音声も扱えるか、時間情報を指定して質問できるかを公式資料で確認します。最新モデルの提供状況は最新LLMモデル比較で更新しています。
PDF・文書・図表:「読める」と「正確に読める」は別
PDFを直接渡して要約・質問応答できるモデルは増えています。ただし、小さな文字、手書き、密な表、図中の注釈などは、画像の解像度やページ分割で結果が変わります。図表の意味を説明する能力と、一文字を正確に転記する能力は別物です。
文書業務では、OCR/Document AIで文字や位置を安定して抽出し、VLMで図表や文脈を解釈する構成が現実的です。
GUI:VLMはAIエージェントの「目」になる
2026年の大きな変化は、画面理解が実際の操作へつながり始めたことです。実際の操作はAIエージェントやcomputer use機能が担い、VLMの視覚理解はその「目」として働きます。
これにより、APIを持たない業務システムでも、人間と同じ画面を使った自動化が可能になりました。ただし、送信・更新・削除などの不可逆操作には人間承認と安全停止を組み込む必要があります。
| ベンダー/系列 | 画像 | 動画 | PDF・文書 | 画面理解・操作 |
|---|---|---|---|---|
| OpenAI(GPT系) | ○ | 一部の現行モデルは非対応。モデル仕様を個別確認 | ○(モデル・入力方式ごとに確認) | ○(computer use) |
| Google(Gemini系) | ○ | ○ | ○ | ○ |
| Anthropic(Claude系) | ○ | 公式記載を確認できず | ○(PDF直接入力) | ○(computer use) |
| Meta(Muse Spark系) | ○ | ○ | 画像・文書理解を案内 | 公式のcomputer use明記を確認できず |
| Alibaba(Qwen系) | ○ | ○ | ○ | ○(対応モデルあり) |
| InternVL | ○ | モデルに依存 | ○ | モデルに依存 |
| ※「○」は、2026年10月7日時点で各社の公式資料に対応記載があることを示します。対応可否はモデル、API、地域、契約プラン、入力形式によって異なり、精度や本番利用の適性を示すものではありません。最新モデル名、価格、コンテキスト長は最新LLMモデル比較で確認してください。 | ||||
VLMの企業活用:使うべき仕事、使わない方がよい仕事
VLMは視覚情報が意味を持つ非定型業務に強い一方、定型抽出や超低遅延処理では専用技術が適する場合がある。
企業でVLMが力を発揮するのは、テキストだけでは意味を取り切れない業務です。図表入りPDF、画面、検査画像のように、レイアウトや位置関係そのものが意味を持つ情報が対象になります。
ただし、何でもVLMへ置き換えればよいわけではありません。定型帳票の大量処理や一文字の誤りも許されない転記ではOCR、厳しいタクトタイムの全数検査では従来型画像処理や専用AIの方が適する場合があります。
| 業務 | 向いている技術 | 理由 |
|---|---|---|
| 様式がばらばらな文書 | VLM+OCR/Document AI | 文字だけでなく、表・配置・文脈の理解が必要 |
| 図表入りPDFの検索 | マルチモーダルRAG+VLM | 図・表・ページ構成も検索根拠にできる |
| APIのない業務システム | VLM+computer use | 人間と同じ画面を認識して操作できる |
| 製造検査の判断支援 | 既存検査AI+VLM+業務データ | 既存の検出結果を起点に、画像、過去記録、基準書を照合して異常候補や対応案を説明できる |
| 定型帳票の大量処理 | OCR/Document AIを優先 | 決定性・監査性・処理コストを管理しやすい |
| 超低遅延の全数検査 | 従来型画像処理・専用AIを優先 | 高速性と再現性が最重要になる |
文書処理:非定型書類を「読む」から「理解する」へ
AWSが2026年8月に紹介した事例では、スイスの保険会社SimpegoがAmazon Bedrock上のClaudeを使ったパイプラインで、言語や形式の異なる保険請求書類から明細や付加価値税の情報を抽出しています。月数千件を処理し、1文書あたり平均約30秒です。
帳票ごとに座標やルールを固定するのではなく、文書全体を見て判断できることが、VLMを含む生成AI型文書処理の強みです。
マルチモーダルRAG:図表も検索の根拠にする
社内のPDFやスライドには、文章より図や表に重要な情報が入っていることがあります。マルチモーダルRAGでは、図表を文章として説明させたり、ページ自体を視覚情報として検索対象へ加えたりします。AWSやGoogleも、PDF内の図・グラフ・表をRAG向けに扱う仕組みを提供しています。
RAG全体の基本はRAG完全ガイドで整理しています。
GUI操作:APIがない業務システムを画面から動かす
米国の転勤支援会社Graebelは、Microsoft Copilot Studioのcomputer useを使い、APIを持たない社内システムへの入力を画面操作で処理するエージェントを構築しています。メールで届いた依頼内容を読み取り、業務ルールで確認し、人間と同じ画面へ入力する仕組みです。
製造検査:検出そのものより、原因説明と判断支援へ
製造現場では、専用画像処理や異常検知AIが高速な検出を担い、VLMはその結果を過去記録や基準書と照合して、原因候補や対応案を説明する役割に向きます。
オムロンは2026年7月、VT-X基板検査システムとNVIDIA Omniverse、Metropolisを統合し、電子基板検査の高度化を目指す取り組みを発表しました。NVIDIA側も、オムロンをMetropolisによる自動検査の活用企業として紹介しています。ただし、これらの発表にVLMの明示的な記載や導入効果の数字はなく、VLM単体の導入実績を示すものではありません。
日本企業では、自社の帳票・画像・現場データで測る
日本企業にとってVLMの価値は、巨大モデルそのものを開発することだけではありません。日本語帳票、図面、検査画像、現場写真のような、地域性・業界性の強い視覚情報をどう理解させるかにあります。
NECも2025年1月から、複雑な図表の意味や形式を考慮してデータ化し、RAGへ活用するサービスを提供しています。日本企業が見るべきなのは、汎用ベンチマークの順位より、自社の帳票・画像・現場データでどこまで正確に使えるかです。
図4 VLMには、画像そのものだけでなく、地域・言語・業務に根ざした解釈も求められる。
VLAとは?VLMの先にある「行動するAI」
VLAは、VLMの視覚と言語の理解を、ロボットの行動出力へ接続する発展形である。
VLA(Vision-Language-Action)は、VLMの視覚と言語の理解を、ロボットの行動へつなげるモデルです。VLMが「見て理解する」AIだとすれば、VLAは「見て判断し、動く」AIです。
Google DeepMindは2026年7月、Gemini Robotics ER 2を「ロボットの高次の頭脳」として公開しました。多段階の作業計画や進捗の把握を担い、実際の動作は下位のVLAモデルに任せる設計です。NVIDIAも、ヒューマノイドの汎用スキルを対象とするオープンなVLA「Isaac GR00T N1.7」を公開しています。
ただしVLAは本記事の主役ではありません。 VLMが「見る力」を担い、その先でVLAが「動く力」へ接続する。この関係を押さえれば十分です。Physical AI全体の流れはPhysical AIとは?で詳しく解説しています。
図5 VLAは、VLMの「見る・理解する」能力を、ロボットの行動へ接続する。
VLM導入で失敗しやすいポイント
VLMは「見えているように見える」ほど過信しやすく、誤読・誤操作・責任分界を事前に設計する必要がある。
VLMは人間の視覚認知とは異なる仕組みで動き、見落とし・読み違い・もっともらしい誤説明を起こします。自然な説明ほど、利用者は「AIが正しく見た」と思い込みやすくなります。
特に数字、単位、凡例、注釈、日付、記号の誤読は、品質事故や金銭損失につながります。GUIでは画面状態を誤認して危険な操作を選ぶ可能性もあります。また画像や画面には、顔、氏名、住所、顧客情報、機密資料が含まれやすいため、データの取り扱いも重要です。
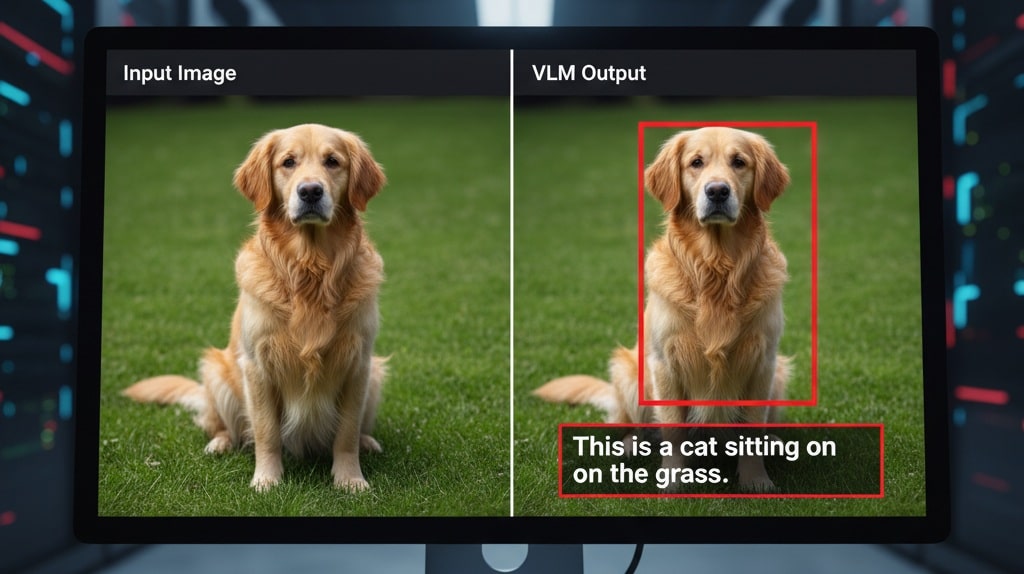
図6 VLMは強力だが、視覚的ハルシネーションや読み違いを起こすことがある。
VLM導入で注意すべき代表的リスク
- 視覚的ハルシネーション:存在しない物体や意味を、もっともらしく説明する。
- OCR・表・グラフの誤読:数字、単位、凡例、注釈、日付、記号を読み違える。
- 動画の時系列理解:前後関係や状態変化を取り違える。動画非対応モデルもある。
- GUI操作の誤判断:ボタンや画面状態を誤認し、誤操作につながる。
- 個人情報・機密情報:画像や画面に含まれる情報の送信先・保持条件を確認する。
- 著作権・データ利用:入力画像、学習利用、出力物の権利処理を確認する。
企業利用では、VLMの出力をそのまま最終判断に使うのではなく、原画像、出典、確認者、修正履歴を残します。高リスク業務では、「VLMが提案し、人間が承認する」というフローを設計し、誰が停止できるかまで決めておく必要があります。
企業でVLMを導入するロードマップ
VLM導入ではモデル名より先に、対象業務・データ境界・評価セット・人間レビューを設計することが成功条件である。
VLM導入では、モデル名より先に「何を見せるか」「何を判断させるか」「誤判定時の影響は何か」を定義します。
VLM導入の6ステップ
- 対象業務を選ぶ:文書処理、製造検査、GUI操作、社内ナレッジ検索などから、効果とリスクが見える業務を選ぶ。
- データ境界を決める:画像、動画、PDF、画面キャプチャに、個人情報・機密情報・著作物が含まれるかを分類する。
- OCRとの役割を分ける:決定性が必要な抽出はOCR/Document AI、意味づけや例外判断はVLMと役割を決める。
- 自社評価セットを作る:実際の画像、帳票、画面、図表から正解データを作り、精度・誤警報・レビュー工数・誤判定時の影響を測る。
- 人間レビューを設計する:低リスクは自動処理、高リスクは承認、異常時は停止できるようにする。
- 本番運用で監視する:モデル更新、精度低下、誤認識、コスト、レイテンシ、監査ログを継続的に見る。
公開ベンチマークの順位だけでVLMを選ぶのは避けましょう。独自帳票、工場の照明、社内UIなど、自社特有の条件では公開評価の順位が逆転することがあります。最終判断は、自社データで作った評価セットで行います。
本番運用では画像・動画・PDF・画面という非テキスト入力まで監視対象になります。生成AIの本番運用や観測性についてはLLMOps / LLM Observabilityで詳しく解説しています。
まとめ:VLMはAIが現実世界を見るための入口
VLMの価値は画像入力そのものではなく、視覚情報を業務判断へ変え、人間の責任設計と接続できる点にある。
VLMとは、画像・図表・文書・画面・動画などの視覚情報と言語を結びつけて理解するAIモデルです。2026年10月時点では画像理解は広く普及し、差が出るのは動画、文書・図表、GUI、そして行動への接続です。
ただしVLMは万能ではありません。文字や数値を正確に抜き出すならOCR/Document AI、物理的な行動まで必要ならVLAなど、周辺技術との役割分担が必要です。
VLMの本質は、AIが文章だけでは捉えられなかった図表・画面・文書・現場の状態を、判断材料にできるようになることです。
企業に問われるのは、最も高性能なVLMを選ぶことではありません。AIに何を見せ、どこまで判断を委ね、最後に誰が責任を引き受けるのか。その設計こそが、VLMを「便利なデモ」で終わらせず、現場で働く技術へ変えます。
目隠しを外したAIに、あなたの会社は何を見せますか。
専門用語まとめ
- VLM(視覚言語モデル)
- Vision-Language Modelの略。画像・図表・文書・画面・動画などの視覚情報と言語を結びつけて扱うAIモデル。
- OCR(光学文字認識)
- 画像やスキャン文書から文字を読み取り、テキスト化する技術。決定性や信頼度が重要な処理で使われる。
- Document AI
- OCR、レイアウト解析、項目抽出、生成AIによる意味理解などを組み合わせ、文書を構造化する技術・サービス群。
- VLA(視覚言語行動モデル)
- Vision-Language-Action Modelの略。視覚と言語の理解をロボットなどの行動出力へつなげるモデル。
- マルチモーダルRAG
- テキストだけでなく、画像、図表、PDF、スライドなども検索対象へ含めて根拠付き回答を生成するRAG。
- computer use
- AIが画面状態を理解し、クリックや入力などの操作を実行する仕組み。視覚理解とエージェント機能を組み合わせて使う。
参考文献 / 出典
- OpenAI|Images and vision
- OpenAI|GPT-6 Sol(モデル仕様)
- OpenAI|GPT-5.5(モデル仕様)
- OpenAI|Computer use
- Google Cloud|Video understanding
- Google|Gemini API Document processing
- Google Cloud|Document AI Layout parser
- Anthropic|PDF support
- Meta AI|Introducing Muse Spark
- Qwen|Qwen3.5
- InternVL|公式GitHub
- Microsoft Learn|Choosing the right AI tool
- AWS|Amazon Bedrock Data Automation
- Google DeepMind|Gemini Robotics ER 2
- NVIDIA|Physical AI models and Isaac GR00T
- OMRON|ニュースリリース(2026年7月16日)
- NVIDIA|Japan’s robotics and manufacturing leaders build on NVIDIA Cosmos
- AWS|Simpegoの保険請求処理事例
- Microsoft|Computer-using agents in Copilot Studio
- NEC|図表データ化・RAG関連プレスリリース
※対応状況は2026年10月7日時点の各社公式資料に基づきます。モデル名、料金、提供地域、API仕様は更新されるため、導入前には公式情報と自社評価セットで確認してください。
補足Q&A
VLMとLLM・OCR・VLAの違いについて、検索で迷いやすいポイントへ簡潔に答える。
Q1.
VLMとLLMの違いは何ですか?
A1.LLMは主に文章を手がかりに処理し、VLMは画像・図表・文書・画面などの視覚情報も判断材料にできます。
ただし2026年現在、主要な生成AIには視覚能力が統合されており、製品名より「その仕事に見る力が必要か」で考える方が実務的です。
Q2.
VLMとOCRの違いは何ですか?
A2.OCR/Document AIは文字や項目を安定して抽出したい業務、VLMは図表や文書全体の意味まで判断したい業務に向きます。
実務では、OCRで正確に読み取り、VLMで意味を判断する併用が有効です。
Q3.
VLMとVLAの違いは何ですか?
A3.VLMは「見て理解し、答える」モデル、VLAはその理解をロボットなどの行動出力へつなげるモデルです。
簡単に言えば、VLMが「目と判断」、VLAが「手足の動き」まで担う違いです。
更新履歴
- 2026年10月7日:LLM・OCR・VLAとの違い、VLMの能力比較、企業活用を2026年10月時点の一次情報へ更新。
- 2026年7月12日:2026年版として全面改版。VLM正典ハブとして構成を再整理。
- 2025年10月23日:VLM最新動向、主要モデル、VLA、日本動向を反映。
- 2024年11月8日:初版公開。