※本記事は継続的に最新情報へアップデートしています。
1台のGPUは速い。だが、数千、数万台を並べると、性能を左右するのはGPU単体の計算能力だけではない。GPU間の「通信待ち」が、もう一つの大きなボトルネックになる。
ラック内のGPU間通信、ラックをまたぐ同期、拠点間のデータ転送。規模が広がるほど、GPUが演算以外の理由で待機する場面は増えていく。
AIネットワーク三層とは、その通信を「ラック内」「ラック間」「拠点間」に整理し、重い通信ほど近くに置くための設計図である。2026年、その三層を支えるNVLink・InfiniBand・Ethernet・光技術の役割が大きく更新された。
✅ 先に結論
AIネットワーク設計の本質は、高価なGPUをいかに待たせずに使い切るかにある。まず通信のボトルネックがどの層にあるのかを特定する。
- ラック内(Scale-Up):NVLinkで最も重いGPU間通信を近距離に閉じ込める
- ラック間(Scale-Out):InfiniBandまたはSpectrum-X/Ethernetで多数のラックを高速に連携させる
- 拠点間(Scale-Across):光接続とワークロード配置を組み合わせ、複数のAIファクトリーを結ぶ
2026年はNVLink 6、NVLink Fusion、UALink、Spectrum-6、CPOが前進し、三層それぞれの選択肢と設計条件が変わった。
CxOが最初に見るべきなのは、ネットワークの最高速度ではなく、どの層で通信待ちが発生しているかです。
ラック内ならScale-Up、ラック間ならScale-Out、拠点間ならScale-Across。ボトルネックの場所を先に切り分ければ、NVLink、InfiniBand、Ethernet、光接続のどこへ投資すべきかが見えやすくなります。
AIネットワークを三層で見ると、複雑な技術が一気に整理できる
AIネットワークを「ラック内」「ラック間」「拠点間」の三層で捉えると、性能上の課題と技術選択の関係が見えやすくなる。
AIデータセンターにはNVLink、InfiniBand、Spectrum-X、Ethernet、光DCIなど多くの技術が登場します。製品名や帯域の数字から入ると複雑に見えますが、最初に確認すべきなのは「通信がどの距離で発生しているか」です。
| 通信する範囲 | 層 | 代表技術 | 設計の目的 |
|---|---|---|---|
| 同じラック内 | Scale-Up | NVLink 6 / NVLink Switch、UALinkなど | GPU・XPU群を密結合し、重い通信を近距離に閉じ込める |
| ラック間・クラスタ内 | Scale-Out | Quantum-X800 InfiniBand、Spectrum-X Ethernetなど | 多数のラックを低遅延・高帯域で連携させる |
| データセンター間 | Scale-Across | Spectrum-XGS、広域Ethernet、光DCIなど | 離れた計算資源を結び、複数拠点を活用する |
| ※三層は通信距離と役割による整理。NVLink、InfiniBand、Ethernetが上から順番に直列接続されるという意味ではない。 | |||
NVLink、InfiniBand、Ethernetが「上から順番に並ぶ三層」ではありません。ラック内ではNVLinkが中心となり、ラック間ではInfiniBandやSpectrum-X Ethernet、拠点間では広域Ethernetや光接続を使います。三層は「製品の階層」ではなく、通信距離と役割を整理する地図です。
この整理を先に置くと、新しい製品や標準が登場しても位置づけを見失いません。まず「どの距離の通信を改善する技術なのか」を確認し、そのうえで帯域、遅延、運用、人材、電力、ベンダー選択肢を比較します。
📌 AIデータセンターネットワークの全体像を確認する:
➡ NVLink vs Broadcom論争の真相|AIネットワークの力学を読み解く
ラックの中を「ひとつの脳」にする──NVLinkが担うScale-Up
Scale-Upが詰まると、GPU単体は速くても同期通信が律速になり、ラック全体の計算性能を十分に引き出せなくなる。
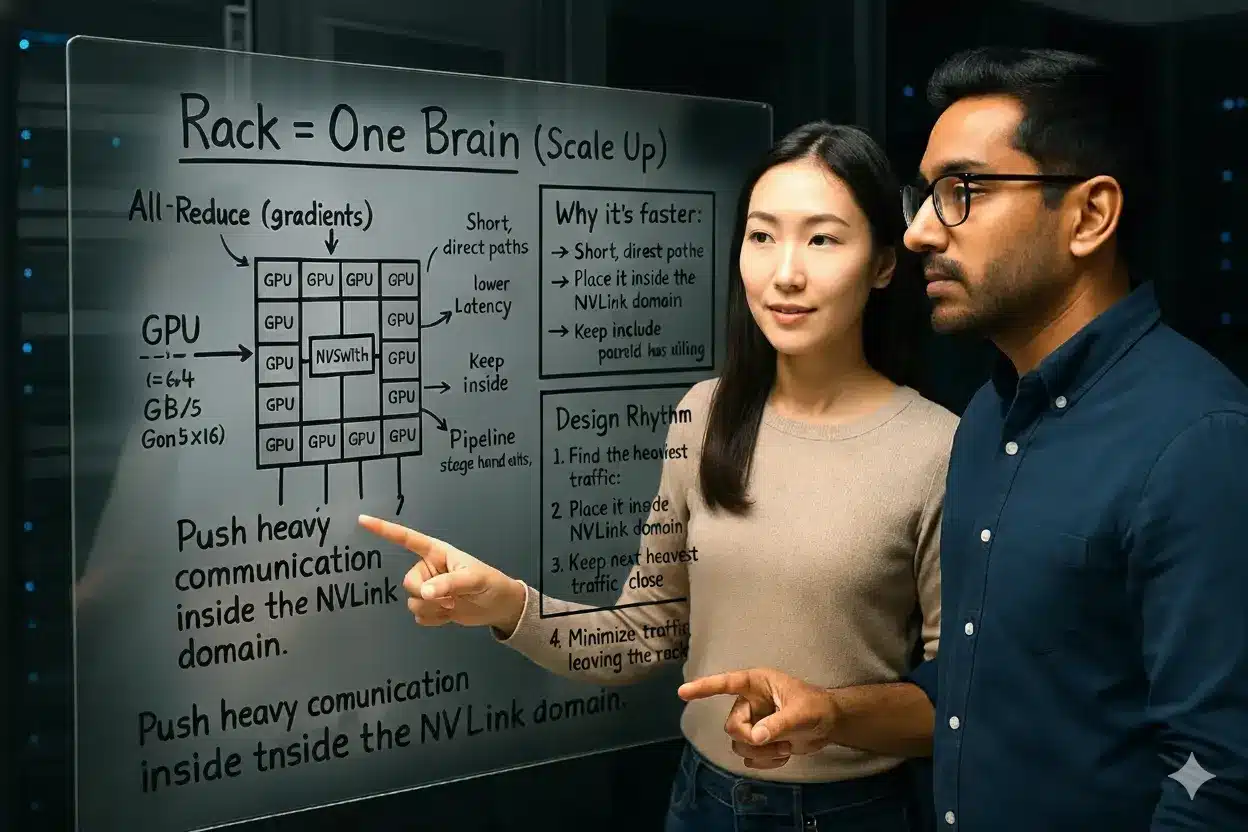
カフェでの会話から始まったエバとレオは、今度は教室のガラスボードにAIデータセンターの地図を描いていた。 エバは中央にNVLinkとNVLink Switchの太い線を引く。「最も重い通信を見つけて、できるだけラックの外へ出さない。まずここからよ」
レオは線をなぞりながら答える。「テンソル並列のデータ交換も、All-Reduceも、通信が終わらなければ次の計算に進めない。だから最初に“近い場所”を速くするんだね」
なぜGPU同士を高速でつなぐ必要があるのか
大規模AIでは、複数のGPUが計算結果や中間データを頻繁に交換します。テンソル並列、パイプライン並列、All-Reduceなどでは、一部のGPUだけ計算が終わっても、必要な通信や同期が完了するまで次の処理へ進めない場面があります。
GPU単体を高速化するだけでは、クラスタ全体の性能は比例して伸びません。 演算速度が上がるほど、その計算資源へ必要なデータを適切なタイミングで渡せるかが重要になります。だからこそ、「最も重い通信をラック内へ閉じ込める」という原則は、2026年でも変わりません。
📌 学習・推論とNVLinkの関係を基礎から確認する:
➡ 初学者用LLM技術:NVLinkを理解するために
PCIeは生活道路、NVLinkは都市の太い動脈
PCIeはCPU、GPU、ストレージなどを幅広く接続する汎用インフラです。一方のNVLinkは、GPU間で大量のデータを繰り返し交換する処理に向けた専用の高速経路です。優劣ではなく、担う交通の種類が違います。NVLink Switchは、それらの高速経路を多対多でつなぐ巨大なジャンクションに相当します。
2026年のScale-Upの基準点は、Vera Rubin世代の第6世代NVLink(NVLink 6)です。NVIDIAの2026年技術ブログでは、NVLink 6についてGPU当たり3.6TB/sの双方向帯域が示されており、Vera Rubin NVL72では72基のGPUをAll-to-Allで接続し、ラック全体で260TB/sの帯域を実現するとしています。資料によって表記条件が異なるため、調達時は対象構成と公表条件を確認する必要があります。
重要なのは単なる帯域の増加ではありません。MoEのExpert Parallel、分散KVキャッシュ、Prefill/Decode分離など、推論でもGPUやXPU間のデータ移動が増えています。NVLinkは学習だけでなく、推論時のデータ移動を支えるScale-Up基盤として重要度を増しています。
📌 Rubin世代とAIチップ競争を俯瞰する:
➡ NVIDIAロードマップ2026|Rubinと競合AIチップ戦略
NVLink Fusion──Scale-Upを他社XPUへ広げる
NVLink Fusionは2025年に発表され、2026年にパートナーシップと実装計画が一段具体化しました。 従来のNVLinkはNVIDIA GPU中心のScale-Up技術という色が強かったのに対し、NVLink Fusionは第三者のCPUやカスタムXPUをNVLinkベースのラックへ接続する道を開きました。
競争の焦点が「どのGPUを選ぶか」から、「異なる計算チップをどのラック基盤で束ねるか」へ広がり始めたと見ると、この動きの意味が分かります。2026年8月にはMediaTekがNVLink Fusionの採用を発表し、9月にはd-MatrixもRaptor XPUへのNVLink Fusion統合を発表しました。ただし、発表や統合計画と大規模量産実績は分けて評価する必要があります。
📌 NVLink Fusionの戦略的な意味を詳しく読む:
➡ NVLink Fusionとは?NVIDIAが他社AIチップをつなぐ新戦略【2026年版】
UALinkとESUN──Scale-Upにもオープン化の波
一方、Scale-Upをオープン規格へ広げる動きも進んでいます。UALinkでは2026年に2.0系仕様が公開され、OCPではEthernet for Scale-Up Networking(ESUN)1.0が2026年3月に公開されました。Scale-Upでもオープン規格をめぐる競争が本格化しています。
企業側の判断軸は、ラック内まで統合スタックで固めるのか、それとも将来のXPU選択肢を残すのかです。 2026年時点では製品化・導入実績でNVLinkが先行していますが、Scale-Upそのものが標準化競争の対象になったことは大きな変化です。
Scale-Upの持ち帰りポイント
- 最も重い通信をラック内へ閉じ込めるという設計原則は変わらない
- Scale-Upの基準点は、第6世代のNVLink 6とVera Rubin世代へ移った
- NVLink FusionとUALink/ESUNにより、Scale-Upは接続規格の競争へ広がっている
ラックを越えると渋滞が始まる──InfiniBand/Ethernet/Spectrum-X
Scale-Outが詰まると、各ラックでは性能が出ていても、同期通信の遅延でクラスタ全体のGPU稼働率が落ちる。
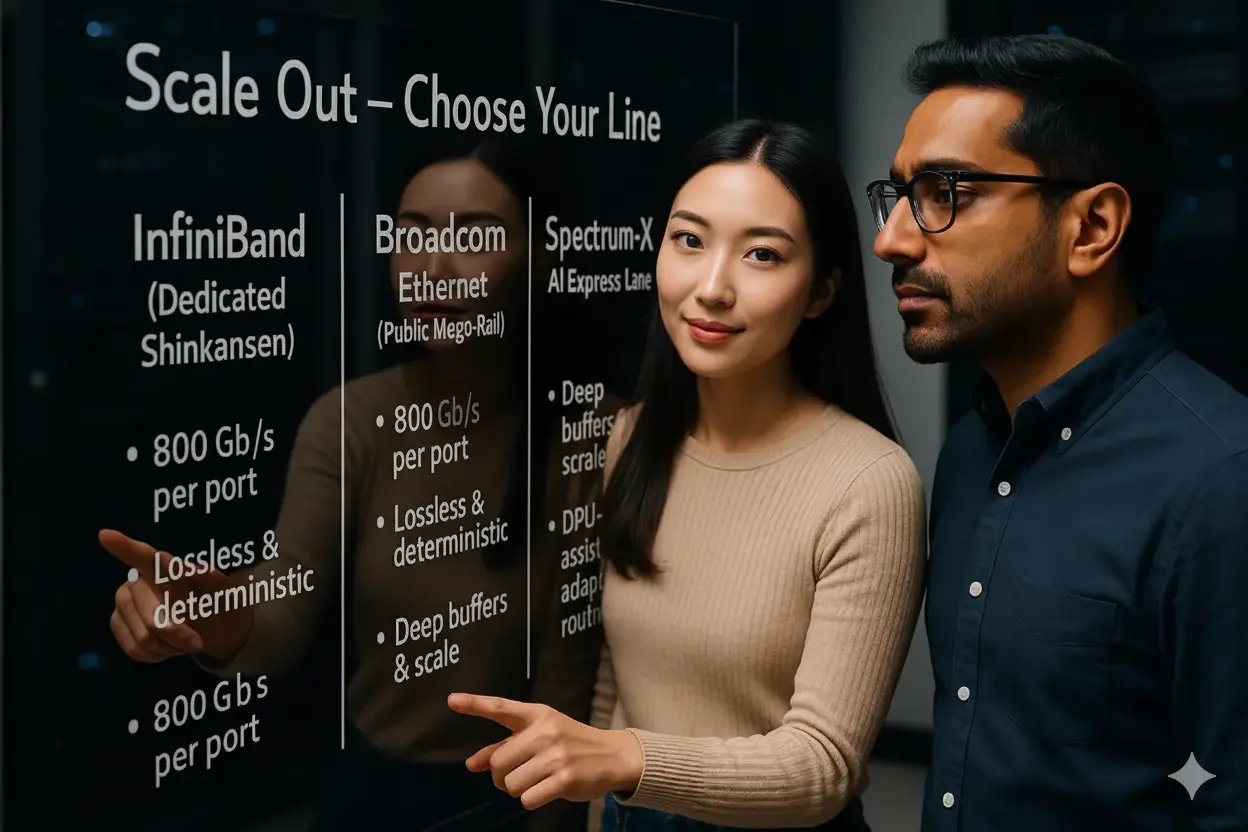
エバ:「ラックの中を一つの脳にできても、ラックが100台になれば次の渋滞が始まる。ここからがScale-Outよ」
レオ:「でもEthernetがAIバックエンドの主流になったなら、もうInfiniBandはいらないんじゃない?」
エバ:「そこが2026年の面白いところ。市場シェアではEthernetが大きい。でもInfiniBandの売上も伸びている。単純な勝ち負けではないのよ」
路線は三つ。ただし、選び方は変わった
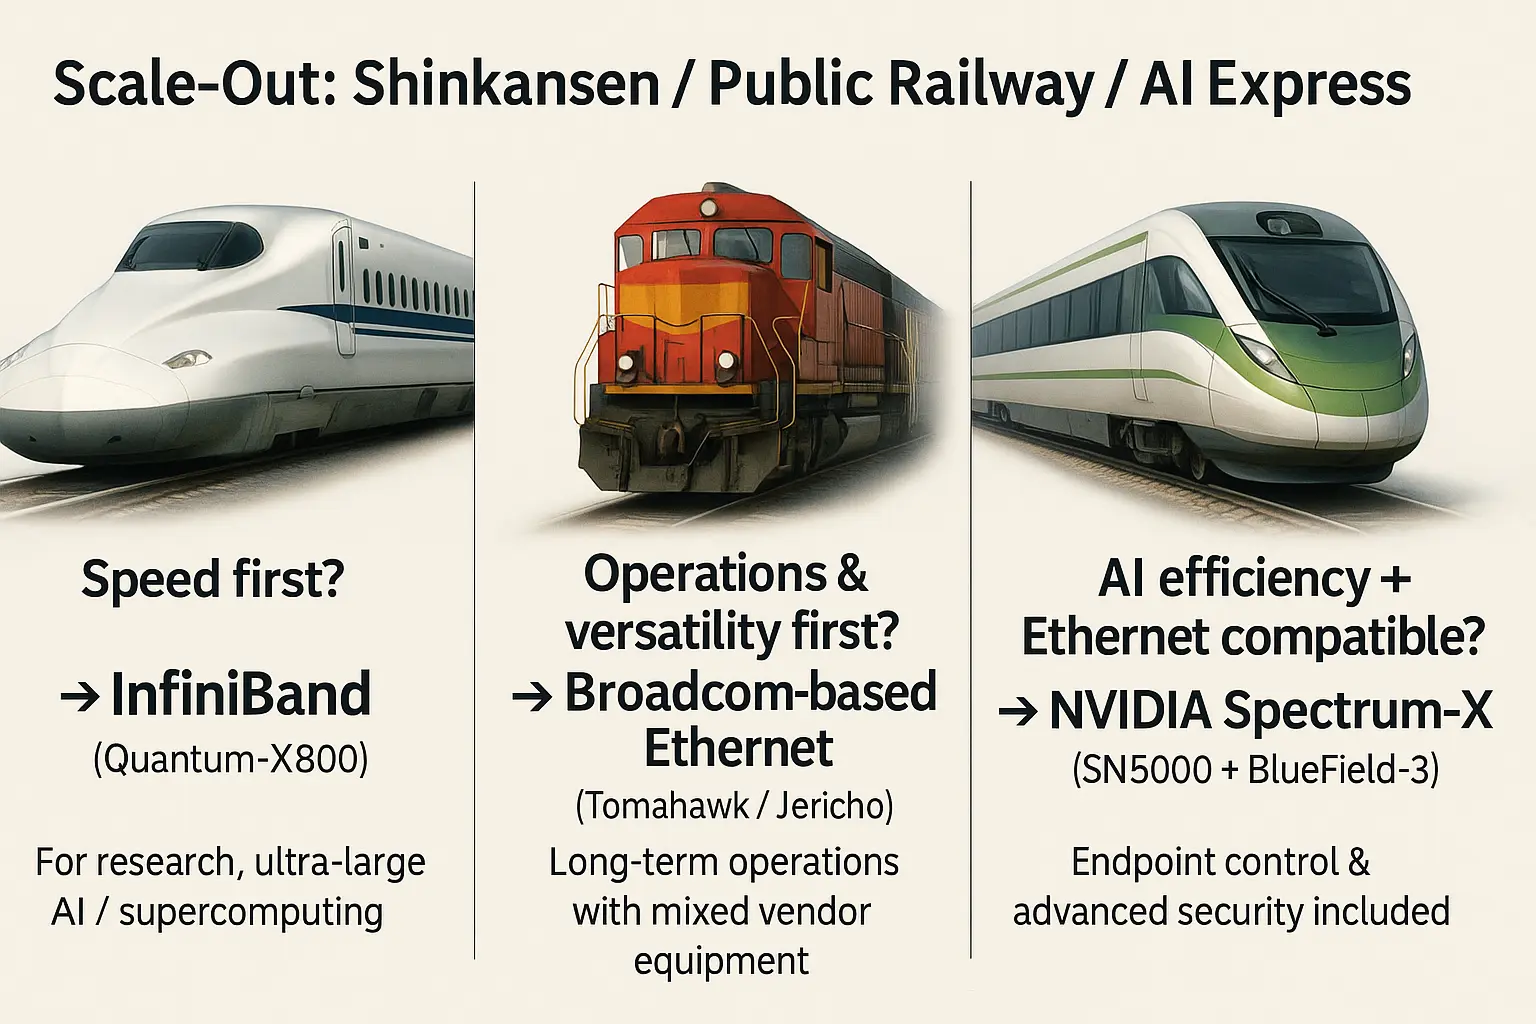
「専用新幹線=InfiniBand、公共巨大鉄道=Ethernet、AI特急レーン=Spectrum-X」と考えると、三つの路線の違いが見えやすくなります。ここでいう公共巨大鉄道は「遅い」という意味ではなく、広い相互運用性と運用基盤を持つネットワークという意味です。ただし2026年は、「最短時間ならInfiniBand、規模ならEthernet、両立ならSpectrum-X」という単純な三択では選べなくなりました。
InfiniBand──専用新幹線は800G世代へ
Quantum-X800は800Gb/s XDR InfiniBandを中核とし、Quantum-3スイッチ、ConnectX SuperNIC、ケーブル/トランシーバーなどで構成されます。144×800Gb/sで最大115.2Tb/sという規模に加え、Adaptive RoutingやSHARPなど、AI/HPC向けに成熟した機能を持ちます。
HPC、科学計算、MPI、Collective通信の比重が高く、低遅延・低ジッタを重視する環境では、InfiniBandは依然として有力です。2026年第1四半期にはInfiniBand売上も前年同期比3倍超へ伸びており、「Ethernetが伸びたからInfiniBandが消える」という構図ではありません。
Ethernet──公共巨大鉄道がAIバックエンドの主流へ
Dell’Oro Groupによると、2026年第1四半期のAIバックエンド向けデータセンタースイッチ売上ではEthernetが約3分の2を占めました。Ethernet売上は前年同期比2倍超に伸び、800Gb/s世代が市場の中心へ移っています。
Ethernetの強みは、既存の運用人材、ネットワークOS、監視、調達先を活用しやすいことです。ただしAIクラスタでは一般的な企業LANよりはるかに大量の同時通信が発生するため、「Ethernetなら何を使っても同じ」ではありません。
Spectrum-X──AI特急レーンはSpectrum-6へ
Spectrum-Xは、EthernetにAI向けの交通管制を加える考え方です。スイッチ、SuperNIC、Adaptive Routing、輻輳制御、テレメトリを協調させ、特定経路への通信集中を避けます。
2026年にはSpectrum-6が102.4Tb/s級へ進み、ConnectX-9など次世代エンドポイントとの組み合わせも前面に出てきました。Broadcomは2025年にTomahawk 6の出荷を開始し、2026年3月には102.4Tbps級Tomahawk 6の量産出荷を発表しています。Ethernet側でもNVIDIA以外の選択肢が広がっています。
またAI向けEthernetでは、MRC(Multipath Reliable Connection)やUltra Ethernetなど、複数経路を前提にした実装・標準化が進んでいます。MRCはReliable Connectionトランスポートを拡張し、複数経路の活用、障害時の再送制御、経路切り替えを扱う仕様です。InfiniBandかEthernetかという競争は続く一方、Ethernetの中でも「どうAI向けに最適化するか」の競争が大きくなったのが2026年です。
| 評価軸 | Quantum-X800 InfiniBand | Spectrum-X Ethernet | オープンEthernet |
|---|---|---|---|
| 路線の性格 | 専用新幹線 | AI特急レーン | 公共巨大鉄道 |
| 強み | 低遅延・低ジッタ、HPC実績、SHARP | EthernetとAI向け統合最適化の両立 | 既存人材、調達先、NOSの選択肢 |
| 注意点 | 専門運用とベンダー依存 | 最大性能はNIC・スイッチ・ソフトの協調に依存 | AI向け輻輳制御と設計力が必要 |
| CxOの判断軸 | 予測可能性とCollective性能 | AI性能とEthernet運用の両立 | 長期TCO、既存資産、ベンダー選択肢 |
| ※実効性能はトポロジー、NIC、ソフトウェア、ワークロード、輻輳条件で変わるため、ピーク帯域だけでは判断できない。 | |||
Scale-Outの持ち帰りポイント
- InfiniBandは高性能領域で伸び続け、EthernetもAIバックエンド市場の主流へ拡大
- 2026年は「IBかEthernetか」だけでなく、Ethernet内部の実装差も重要
- 調達では速度だけでなく、既存運用、人材、障害時の性能、ベンダー選択肢まで見る
都市と都市をつなぐ──Scale-Acrossと「光の橋」
Scale-Acrossが詰まると、拠点間の遅延と輻輳がGPU待ちへ波及するため、重い通信を遠距離へ出さない配置設計が重要になる。
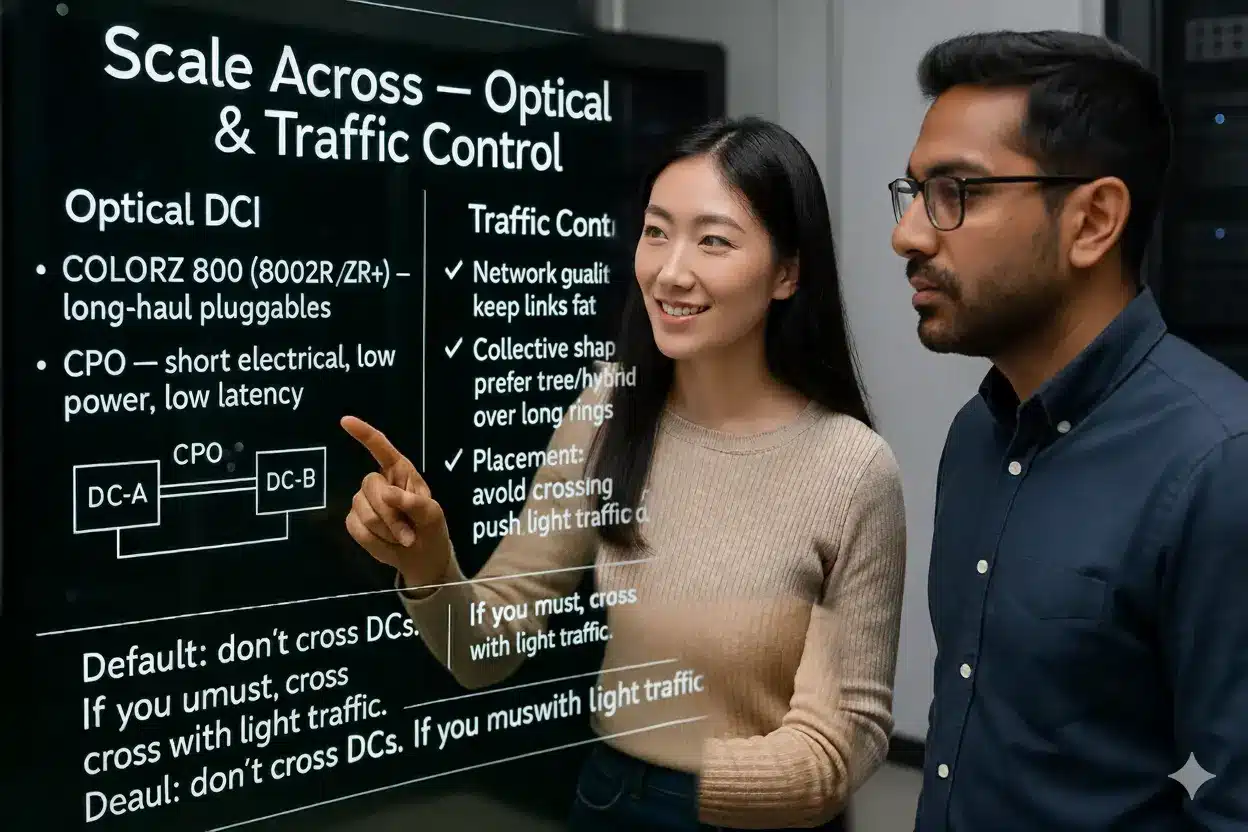
エバ:「GPUが増え続ければ、一つのデータセンターだけでは収容しきれなくなる。そこで“工場同士をつなぐ”発想が必要になるの」
レオ:「でも数百km離れた拠点を、同じラックの延長のようには扱えない。ネットワークが速くなっても、距離そのものは消えないからね」
長距離は「光の橋」でつなぐ
光DCIやCPOを「光の橋」として捉える見方は、2026年も有効です。 AIファクトリーの大規模化によって、光技術は将来の選択肢ではなく、データセンター内外の電力・帯域設計を左右する現実的な要素になっています。
NVIDIAはSpectrum-XGSを、複数サイトにまたがるAIファクトリーを結ぶScale-Acrossの選択肢として打ち出しています。ただし、拠点間では物理距離や回線品質の影響が大きいため、製品名だけでなく実際の遅延、帯域、障害復旧条件まで確認する必要があります。
Scale-Acrossは「距離を消す技術」ではなく、距離がある前提でワークロードを配置する設計です。
基本は「またがない」。またぐなら軽い通信を外側へ
頻繁な同期を必要とするテンソル並列などは、可能な限り同一DC、同一クラスタへ閉じ込めます。拠点間には、通信頻度の低いデータ並列、データ複製、チェックポイント、非同期処理などを配置する方が扱いやすくなります。
PFC、ECN、CNPなどの仕組みは個別に異なりますが、実務で見るべき目的は「輻輳をどう抑え、通信の詰まりをどう防ぐか」です。高速な回線を用意するだけでなく、混雑時にどの経路へ流し、どのように減速・再送するかまで含めて設計します。
CPO──光変換をスイッチの近くへ
CPO(Co-Packaged Optics)は、光変換機能をスイッチASICの近くへ配置し、長い電気配線による消費電力や信号損失を抑える技術です。NVIDIAは2026年、Spectrum-X Ethernet Photonicsを生産段階へ進め、Quantum-X系のシリコンフォトニクスも次世代接続技術として展開しています。
重要なのは「光を使うようになった」ことではなく、800Gから1.6Tへ向かうネットワークで、光変換をどこまでチップへ近づけるかが設備設計の論点になったことです。一方、保守性、交換性、光エンジンの歩留まりなどの課題もあり、プラガブル光をただちに全面置換する段階ではありません。
Scale-Acrossの持ち帰りポイント
- 遠距離を高速化しても、重い通信を遠くへ出さない原則は変わらない
- 広域では帯域だけでなく、輻輳制御、配置、再送、障害時の挙動まで見る
- CPOは光化そのものではなく、光変換をチップへ近づける技術として理解する
業界構造──XPU時代に誰がAIファクトリーの基盤を握るのか
2026年の競争はGPU対XPUという単純な構図ではなく、計算チップ・接続・ラック・ネットワークをどこまで統合するかという競争である。
三層を支える技術が揃っても、それを誰のルールで組み上げるかで、性能、コスト、運用の自由度は変わります。 ここからは、ネットワーク技術を経営判断として見ていきます。
XPUはGPUを置き換えるのか
「XPUはGPUを食うのか?」という問いだけでは、2026年のAIインフラ競争は説明できません。 GPUとASICの役割分担に加えて、接続、ラック、ネットワークまで含めて誰が基盤を握るのかを見る必要があります。
GPUは汎用性とソフトウェアエコシステムに強く、カスタムXPUは特定ワークロードで電力効率やコスト効率を狙いやすい。一方、実際のAIファクトリーには、それらを束ねるScale-Up、Scale-Out、ストレージ、管理、電力、冷却が必要です。
NVLink Fusionが示すのは、NVIDIAが「自社GPUだけを売る」モデルから、他社XPUも接続できるラック基盤へ競争領域を広げていることです。 逆にUALink、ESUN、Ultra Ethernetなどは、接続部分の標準化と複数ベンダー化を進めようとしています。
垂直統合か、オープンな組み合わせか
一社の統合スタックで性能と運用を共同最適化するのか、標準規格を使って層ごとの選択肢を残すのか。この違いは、性能だけでなく調達、運用、人材、将来の更新自由度にも影響します。
| 判断軸 | 統合スタック | オープン構成 |
|---|---|---|
| 強み | 性能・運用を共同最適化しやすい | ベンダー選択肢を残しやすい |
| 注意点 | 特定ベンダーへの依存度が高まりやすい | 複数製品を横断する統合設計力が必要 |
| CxOの問い | 性能と運用統合をどこまで優先するか | 将来の変更余地をどこまで残すか |
| ※実際には完全な二者択一ではなく、層ごとに両者を組み合わせる構成もある。 | ||
📌 AIインフラ市場全体の競争構造を確認する:
➡ AIインフラ市場2026|NVIDIA独占に挑む各社戦略
実務ではどう判断するか──製品名より先にボトルネックを見る
導入判断では、どの層で通信待ちが起きているかを測り、性能・運用・人材・電力・将来の選択肢を同じ土俵で比較する。
判断の順番は「層→原因→製品」
最初にNVLink、InfiniBand、Spectrum-Xのカタログを並べるのではなく、現行システムでどの層がGPUの有効稼働率を落としているかを測ります。ラック内ならScale-Up、ラック間ならScale-Out、拠点間ならScale-Acrossです。
次に原因を切り分けます。帯域不足なのか、輻輳なのか、ジッタなのか、再送なのか、障害復旧に時間がかかっているのか。その後で初めて製品や方式を比較します。
PoCは最高速度より「崩れ方」を見る
AIファクトリーはベンチマークの数分だけ動く設備ではありません。長時間運用ではリンク障害、スイッチ保守、複数ジョブの競合、ケーブル不良、偏ったトラフィックが起こります。
PoCで見るべきなのはピーク帯域だけではなく、混雑や障害が起きてもGPUの有効稼働率をどこまで維持できるかです。そのとき重要になるのが、再送や制御オーバーヘッドを除き、実際にアプリケーションが利用できた有効スループットであるGoodput(グッドプット)です。
対象モデルのTensor Parallel、Expert Parallel、Data Parallel、All-to-Allなどを再現し、正常時と障害時の両方を測ります。ベンダー公称値ではなく、自社ワークロードでどこまで性能を維持できるかを確認することが重要です。
CxOが確認すべき4つの問い
- この投資でGPUのアイドル時間をどの程度減らせるのか
- 正常時だけでなく、混雑・障害時にも性能を維持できるのか
- 既存の人材、監視、ネットワーク運用資産をどこまで再利用できるのか
- 1.6T、CPO、XPU混在を見据え、将来の更新余地とベンダー選択肢を確保できるのか
GPUを追加するより、既存GPUを待たせている通信ボトルネックを解消する方が投資効果の高いケースもあります。 ここまで整理して初めて、ネットワークは「配線の話」から経営判断の対象へ変わります。ただし、その判断に使う数字には読み方があります。
一次情報からどこまで言えるか
2026年のAIネットワークには量産製品と将来計画が混在するため、仕様公開・製品化・量産・導入実績を分けて読む必要がある。
2026年9月時点で確認できる大きな変化は、NVLink 6、Spectrum-6、Spectrum-X Ethernet Photonics、UALink 2.0系仕様、OCP ESUN 1.0などです。一方で、仕様が公開されたことと、その技術を使う製品が大規模量産されていることは同じではありません。
「仕様がある」「製品が発表された」「量産している」「大規模導入実績がある」は別の段階です。 また、ベンダー公称の性能値はワークロード、トポロジー、ラック規模、障害条件が異なるため、数字だけを横並びにせず、比較条件まで確認する必要があります。
まとめ:高価なGPUを待たせない。そのために三層で考える
AIネットワーク設計の判断原則は、通信を距離で分け、通信量の大きい処理をできるだけ近距離へ閉じ込めることである。
AIネットワーク設計の本質は、高価なGPUをいかに待たせずに使い切るかにあります。 ラック内ならScale-Up、ラック間ならScale-Out、拠点間ならScale-Across。この三層で捉えると、NVLink、InfiniBand、Spectrum-X、光DCIの役割が一枚の地図として見えてきます。
2026年は、NVLink 6とNVLink Fusion、UALinkとESUN、Spectrum-6、CPOによって、選べる道が確かに増えました。しかし、設計の基本原則まで変わったわけではありません。
近い通信ほど速くする。重い通信ほど近くに置く。遠くへ出す通信ほど少なくする。 GPUを追加する前に、まずどの層で通信が詰まっているのかを確かめる。10万GPU時代のAIネットワーク設計は、そこから始まります。
ガラスボードの前で、レオがマーカーを置いた。「結局、三本の線のどこが詰まっているのか。それを測るところからなんだね」
エバは小さくうなずいた。「GPUを買い足す前に、ね」
AIインフラの競争は、GPUを何枚持つかでは終わらない。そのGPU群を、どれだけ待たせずに働かせられるかで決まる。
専門用語まとめ
本文で登場した主要用語を、三層構造のどこで使われる技術なのかが分かるように整理する。
- Scale-Up
- 同一ラックや近接領域でGPU・XPUを高速接続し、一つの大きな計算システムとして扱う考え方。
- Scale-Out
- 複数のサーバーやラックをネットワークで接続し、クラスタ全体の計算能力を拡張する考え方。
- Scale-Across
- 複数のデータセンターや地域に分散した計算資源をネットワークで連携させる考え方。
- NVLink / NVLink Switch
- NVIDIAの高速相互接続技術と、それを多対多で接続するスイッチ技術。主にScale-Upで使われる。
- XPU
- CPU、GPU、NPU、TPUなど、異なる種類のプロセッサを総称的に表す際に使われる表記。範囲はベンダーや文脈によって異なる。
- InfiniBand
- HPCやAIクラスタで利用される低遅延・高帯域のネットワーク技術。主にScale-Outで使われる。
- Spectrum-X
- NVIDIAのAI向けEthernetプラットフォーム。スイッチ、SuperNIC、輻輳制御などを組み合わせる。
- MRC(Multipath Reliable Connection)
- Reliable Connectionトランスポートを拡張し、複数経路の活用、障害時の再送制御、経路切り替えを扱うための仕様。AI向けネットワークのマルチパス化で注目されている。
- CPO
- スイッチASICの近くに光変換機能を配置し、電力や信号損失を抑えるCo-Packaged Optics。
- Goodput(グッドプット)
- プロトコル処理や再送などを除き、アプリケーションが実際に利用できた有効スループット。障害や輻輳を含む実運用性能を見る際の重要な指標。
参考文献 / 出典
製品仕様や標準規格は一次情報を優先し、市場動向については調査会社の公開情報を参照している。
一次情報
- NVIDIA Technical Blog – NVIDIA NVLink: The Scale-Up Network for AI Factories
- NVIDIA – Quantum-X800 InfiniBand Platform
- NVIDIA Blog – NVIDIA Spectrum-6 Arrives in Gigascale AI Factories
- NVIDIA Newsroom – Vera Rubin Ramps Into Full Production
- NVIDIA Newsroom – NVIDIA NVLink Fusion Expands AI Infrastructure Partner Ecosystem
- NVIDIA Newsroom – NVIDIA and MediaTek Deepen Partnership
- d-Matrix – d-Matrix Adopts NVIDIA NVLink Fusion
- Marvell – NVIDIA AI Ecosystem Expands as Marvell Joins Forces Through NVLink Fusion
- UALink Consortium – Specifications
- Open Compute Project – OCP ESUN 1.0 Specification
- Open Compute Project – Multipath Reliable Connection Specification 1.0
- Broadcom – Tomahawk 6 102.4 Tbps Production Shipment
二次情報
次に読むならこの3本
AIネットワークから、AIファクトリーの経済性、競合AIチップ、NVIDIAの2026年戦略へ理解を広げる3本を紹介する。
補足Q&A
検索時に生じやすい疑問を、三層構造と2026年の市場変化に沿って簡潔に整理する。
Q1.
NVLinkとInfiniBandは競合する技術ですか?
A1. 基本的には役割が異なり、同じAIクラスタで組み合わせて使われることがあります。 NVLinkは主にラック内のScale-Up、InfiniBandは主にラック間のScale-Outを担います。ただし、実際の境界は製品世代やラック設計によって変わるため、「どの距離の通信を速くしたいか」で捉えるのが実務的です。
Q2.
Ethernetが約3分の2なら、InfiniBandはもう不要ですか?
A2. 不要になったわけではありません。 2026年第1四半期はEthernetがAIバックエンド向けスイッチ売上の約3分の2を占める一方、InfiniBandも前年同期比3倍超に伸びています。
Q3.
AIネットワークを選ぶとき、最初に確認すべきことは何ですか?
A3. 最初に確認すべきなのは、どの層で通信のボトルネックが発生しているかです。 ラック内、ラック間、拠点間に切り分け、その後に性能、運用人材、TCO、ベンダー選択肢、電力条件を評価します。
更新履歴
2026年版では三層モデルと既存の比喩を維持しながら、NVLink 6、標準化、Ethernet市場、CPOなど約1年分の変化を反映した。
- 2026年9月30日:NVLink 6、NVLink Fusion、UALink、ESUN、Spectrum-6、CPO、2026年市場動向を反映し、三層モデルを更新。
- 2025年10月9日:初版公開。