※本記事は継続的に最新情報へアップデートしています。
CoreWeave(コアウィーブ)とは、AI学習・推論に特化した米国のネオクラウドである。2025年は「GPUを大量に持つ新興クラウド」と見られていたが、2026年の評価軸は、GPUをどれだけ集めたかではなく、何日も止めず、成果に変えられるかへ移った。
高価なGPUを並べても、通信待ち、故障、熱、データ転送で止まれば、それは満席なのに走れない新幹線だ。では、なぜ暗号資産マイニング出身の会社が、AWS・Microsoft Azure・Google Cloudの間へ割って入れたのか。答えは「枚数」ではなく、「走り切る設計」にあった。
その答えは、MFUとgoodputを高めるAI特化設計、長期契約を設備に変える資本戦略、そして両者を回すCoreWeaveの成長フライホイールにある。ただし、同じ装置が巨額投資・利払い・顧客集中というリスクも生む。この表裏を知らなければ、CoreWeaveを導入先としても投資対象としても正しく評価できない。
✅ 先に結論
CoreWeave(コアウィーブ)は、AI学習・推論に特化した「ネオクラウド」です。同社の強さはGPUの保有台数だけではなく、ネットワーク、ストレージ、冷却、スケジューリング、監視を一体で運用し、GPU時間をモデルの進歩に変える点にあります。
- 何の会社か:GPUを貸すだけでなく、大規模AIを止めずに動かすためのクラウド基盤と運用ソフトを提供する企業
- 何がすごいか:Hopper GPUでMFU 50%超、最大96%のgoodputを自社分析として公表。数値は条件付きだが、全スタック最適化の思想を示す
- 2026年の現在地:第2四半期売上25.75億ドル、受注残に相当するRevenue Backlog約1,040億ドル、稼働電力1.5GWへ拡大
- 最大の注意点:急成長には巨額設備投資と利払いが伴う。受注残は売上保証ではなく、設備供給とサービス提供の条件を満たして初めて収益化される
CoreWeave(コアウィーブ)とは何の会社か
CoreWeaveとは、汎用クラウドの機能を広く売るのではなく、AI・HPC向けGPU計算へ深く特化した米国のAIクラウド企業である。
AWS、Microsoft Azure、Google Cloudは、Webサーバー、データベース、業務システムからAIまでを扱う巨大な総合百貨店です。対するCoreWeaveは、AI学習・推論、VFXレンダリング、高性能計算など、GPUを大量に使う仕事へ品揃えを絞った専門店です。このようなAI特化型の新興クラウドは、一般にネオクラウド(Neo-cloud)と呼ばれます。
ただし「GPUレンタル会社」と理解すると、本質を半分しか捉えられません。大規模学習では、GPU自体が速くても、1台の故障、ネットワークの混雑、チェックポイント保存、温度上昇が全体を待たせます。CoreWeaveが売ろうとしているのはGPUの時間だけではなく、何千台ものGPUが同じ仕事を続けられる運用品質です。
| 比較項目 | CoreWeave | 汎用ハイパースケーラー |
|---|---|---|
| 主な設計目的 | AI・HPC向けアクセラレーテッドコンピューティング | 幅広い企業ITとクラウドサービス |
| 強みの所在 | GPUクラスタの性能、稼働、観測、専門支援 | サービスの広さ、地域、統合性、企業基盤 |
| 顧客が買う価値 | 大規模AIを速く立ち上げ、長く走らせる能力 | 多様な業務を一つのクラウドで運用する能力 |
| 主な弱点 | 設備投資、資金調達、顧客・ベンダー集中 | AI専用環境では抽象化や汎用性が負担になる場合 |
だからCoreWeaveとAWSを、「どちらが上か」だけで比べるのは筋がよくありません。預けるのが企業IT全体なのか、フロンティアAIの学習・推論なのかで、勝ち筋そのものが違います。市場全体の競争構造は、AIインフラ市場2026で詳しく整理しています。では、CoreWeaveはどこで、この「専門特化」という勝ち筋を手に入れたのでしょうか。物語の出発点は、クラウドでもシリコンバレーでもなく、ウォール街にあります。
ウォール街からGPUクラウドへ――異色の創業物語
CoreWeaveの原点はクラウドではなく暗号資産マイニングであり、GPU・電力・冷却を資産として回す経験が後の競争力になった。
CoreWeaveの物語は、シリコンバレーのガレージではなく、金融市場の仕事をしていた3人から始まりました。Michael Intrator、Brian Venturo、Brannin McBeeは2017年、GPUを使った暗号資産マイニング事業Atlantic Cryptoを立ち上げます。
マイニングでは、GPUの購入価格だけを見ても勝てません。電力単価、冷却、稼働率、故障率、暗号資産価格、中古GPUの残存価値まで含めて、1時間ごとの採算を読む必要があります。つまり3人が先に学んだのはクラウドの作り方ではなく、高価な計算資産を休ませず、収益へ変える方法でした。
暗号資産市場が冷え込むと、GPUを別の用途へ振り向けられる柔軟性が生きました。VFXレンダリング、機械学習、科学技術計算へ計算能力を提供し、2019年にCoreWeaveへ改称します。これは単なる社名変更ではありません。暗号資産価格へ賭ける会社から、計算需要そのものへ賭ける会社への転換でした。
ただし、創業譚を美談にしすぎてはいけません。マイニング経験だけで、現在のAIクラウドが完成したわけではありません。大規模AIには、エンタープライズ級のセキュリティ、可用性、ネットワーク、データ管理、サポートが必要です。原点が与えたのは完成品ではなく、「GPUは買った瞬間ではなく、働いた時間に価値を生む」という経営感覚でした。持っているだけでは足りない。稼働してこそ、価値になる。
AIへの転換――なぜ巨大クラウドの隙間へ入れたのか
生成AI以前からGPU専用基盤へ投資した先行性と、AI需要の急増に合わせて設備・ソフト・運用を一体化した集中戦略が転機である。
転機は、AI研究者が必要とするGPUと、一般的なクラウドが得意とするサービスの間に隙間が生まれたことです。AIモデルが大きくなるほど、必要なのは単体GPUの性能ではなく、数百・数千台を束ねるネットワーク、データ供給、障害復旧、ジョブ管理になります。
巨大クラウドは強大ですが、あらゆる顧客と用途に応える設計を持ちます。CoreWeaveはそこへ正面から総力戦を挑まず、AI・HPCへ集中しました。レストランに例えれば、世界中の料理を出すホテルと、厨房も仕入れも一皿のために最適化した専門店の違いです。メニューの数では勝てなくても、特定の料理を大量かつ安定して出す勝負なら戦えます。
2026年第2四半期のCoreWeaveは、稼働電力を約1.5GW、契約済み電力を約3.7GWまで拡大したと公表しました。売上は25.75億ドルで前年同期比約2.1倍です。これは、同社が小さなGPU貸出業者から、発電所級の電力を扱うインフラ事業者へ変わったことを示します。
ただし電力契約は、そのまま計算能力ではありません。土地、受電、建屋、冷却、GPU、ネットワーク、試験をそろえ、顧客が使える状態にして初めて売上になります。AIインフラ投資がGPU調達から物理実装競争へ移った背景は、AIインフラ投資2028年予測で補完しています。
MFUとは――GPUのカタログ性能と実力の間
MFUはGPUの理論演算性能のうちモデル計算に使えた割合であり、CoreWeaveの強みを理解する重要指標だが、単独でクラウド全体を評価する万能指標ではない。
MFU(Model FLOPs Utilization/モデル演算効率)は、GPUが理論上出せる演算能力に対し、実際のモデル学習でどの程度を有効利用できたかを示す割合です。ピーク性能100のGPUでも、通信やデータ待ちで半分の時間が止まれば、モデルを進める仕事は50しかできません。
CoreWeaveは2025年3月19日に公開した自社分析で、NVIDIA Hopper GPUによるMFU 50%超と、公開済みのファウンデーションモデル学習ベンチマークに対する最大20%高いクラスタ性能を示しました。いずれもモデル、GPU構成、精度、並列化などの測定条件に依存する同社公表値です。より具体的には、128基のH100を用いた条件を合わせた比較で、MosaicMLの公開値41.85%に対し49.2%を得たと説明しています。
ここで「CoreWeaveは他社より常に20%速い」と一般化してはいけません。もし手元に複数のGPUクラスタの見積書が並んでいるなら、この20%をそのまま比較表へ転記する前に、測定条件を確認する必要があります。これはCoreWeave自身による試験であり、モデル、GPU、精度、シーケンス長、並列化、ソフトウェア構成によってMFUは変わります。異なるGPUを使った比較も含まれます。正確には「同社の全スタック最適化が、特定条件で高いMFUを示した」と読むべきです。
MFUとgoodputは何が違うのか
MFUが「走っている間のエンジン効率」なら、goodputは予定時間のうち有効な仕事を完了できた割合に近い指標です。学習中にノードが故障し、再起動や巻き戻しが発生すれば、走行中のMFUが高くても納期は遅れます。
CoreWeaveは、クラスタ検証、監視、予防的なノード交換、オブザーバビリティによって、最大96%のgoodputを達成すると公表しています。これも同社の条件付き公表値ですが、「速いGPU」より「長い学習を完走させる仕組み」を売るという戦略をよく表しています。
| 指標 | 何を測るか | 見落としやすい点 |
|---|---|---|
| 理論FLOPS | チップが理論上出せる最大演算性能 | 通信、I/O、故障、ソフトウェア待ちを含まない |
| MFU | 理論性能のうちモデル演算へ使えた割合 | モデルと試験条件が違えば単純比較できない |
| goodput | 割り当て時間のうち有効な処理を進められた割合 | 事業者によって定義や測定範囲が異なり得る |
| ※MFU 50%超、最大96% goodputはCoreWeave公表値。第三者による全環境共通の保証値ではありません。 | ||
何がすごいのか――MFUを押し上げる技術の堀
CoreWeaveの技術的な堀は単一の秘密兵器ではなく、ベアメタル、ネットワーク、冷却、ストレージ、監視を同時に詰める全スタック設計である。
大規模学習は駅伝に似ています。一人だけ世界記録で走っても、たすきが遅れ、選手が倒れ、給水が届かなければチームは勝てません。CoreWeaveの競争力は、最速の走者を所有することではなく、たすき、コース、給水、救護まで同じレースのために設計することにあります。
ベアメタルとトポロジー認識
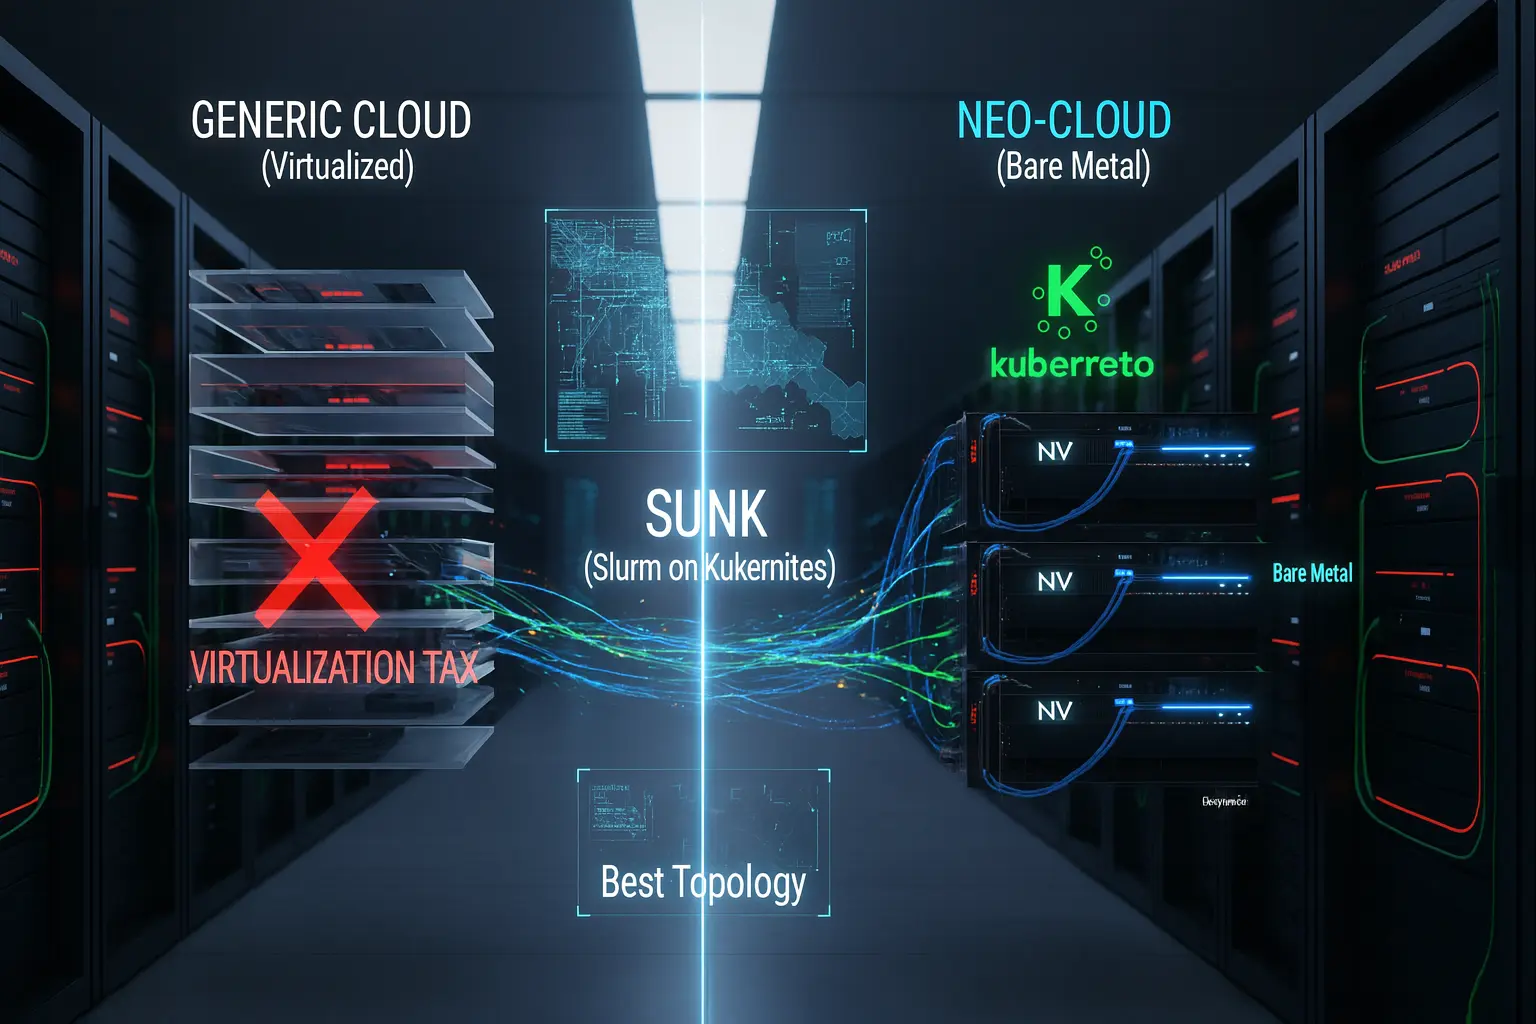
CoreWeave Kubernetes Serviceは、高性能ベアメタル上でKubernetesを動かします。重要なのは「仮想化が常に悪い」という単純な話ではありません。AI学習ではGPU間の物理的な接続関係が性能を左右するため、ジョブをどのノードへ置くかが重要になります。
同社のSUNK(Slurm on Kubernetes)は、研究者が使い慣れたSlurmのワークフローとKubernetesの運用性を組み合わせ、トポロジーを考慮してジョブを配置します。近いGPUを一つの仕事へ集められれば、遠回りする通信を減らせます。
InfiniBandと高速ネットワーク
数千基のGPUで学習すると、各GPUが計算した勾配を集約するAll-Reduceが頻繁に発生します。これは、数千人が同時に解いた問題の答えを集め、全員へ配り直す作業です。一人でも共有が遅れれば、ほかのGPUは待ちます。
CoreWeaveはNVIDIA Quantum InfiniBandやSpectrum系スイッチを活用し、NCCL通信のオーバーヘッドを減らします。SHARPは集約処理の一部をネットワーク側へオフロードできる技術です。NVLink、InfiniBand、Ethernetの役割を深掘りする場合は、AIデータセンターネットワーク完全ガイドが補完記事になります。
液体冷却――GPUを熱で眠らせない
電力の大部分は最後に熱になります。冷却が追いつかなければGPUはクロックを落とし、サーマルスロットリングで性能が低下します。そこで高密度ラックでは、冷却液をチップ付近まで運ぶDirect-to-Chip液冷が重要になります。
2026年6月、CoreWeaveはNVIDIA Vera Rubin NVL72の立ち上げと検証を完了したと公表しました。同社によればVera Rubinは100%液冷で、ValveyやRackyと呼ぶラック単位の冷却・電力・環境管理技術も投入しています。Vera Rubinのチップとラック構成そのものは、Vera Rubin AIデータセンター完全ガイドへ役割を分けます。
ストレージ、チェックポイント、可観測性
モデル学習は計算だけでは完結しません。大量の学習データを供給し、途中状態をチェックポイントとして保存し、異常時には再開する必要があります。データが届かなければGPUは待ち、保存が長ければ学習が止まります。
CoreWeaveはAI Object Storage、Tensorizer、監視基盤、Mission Controlを組み合わせ、データ転送と障害対応による停止を減らそうとしています。AIクラウドの性能はGPUの瞬間最高速ではなく、計算・通信・保存・復旧を含むレース全体で決まるのです。駅伝と同じです。どこか一つでたすきが止まれば、最速の走者も前へ進めません。
成長の秘密――GPUファイナンスと長期契約
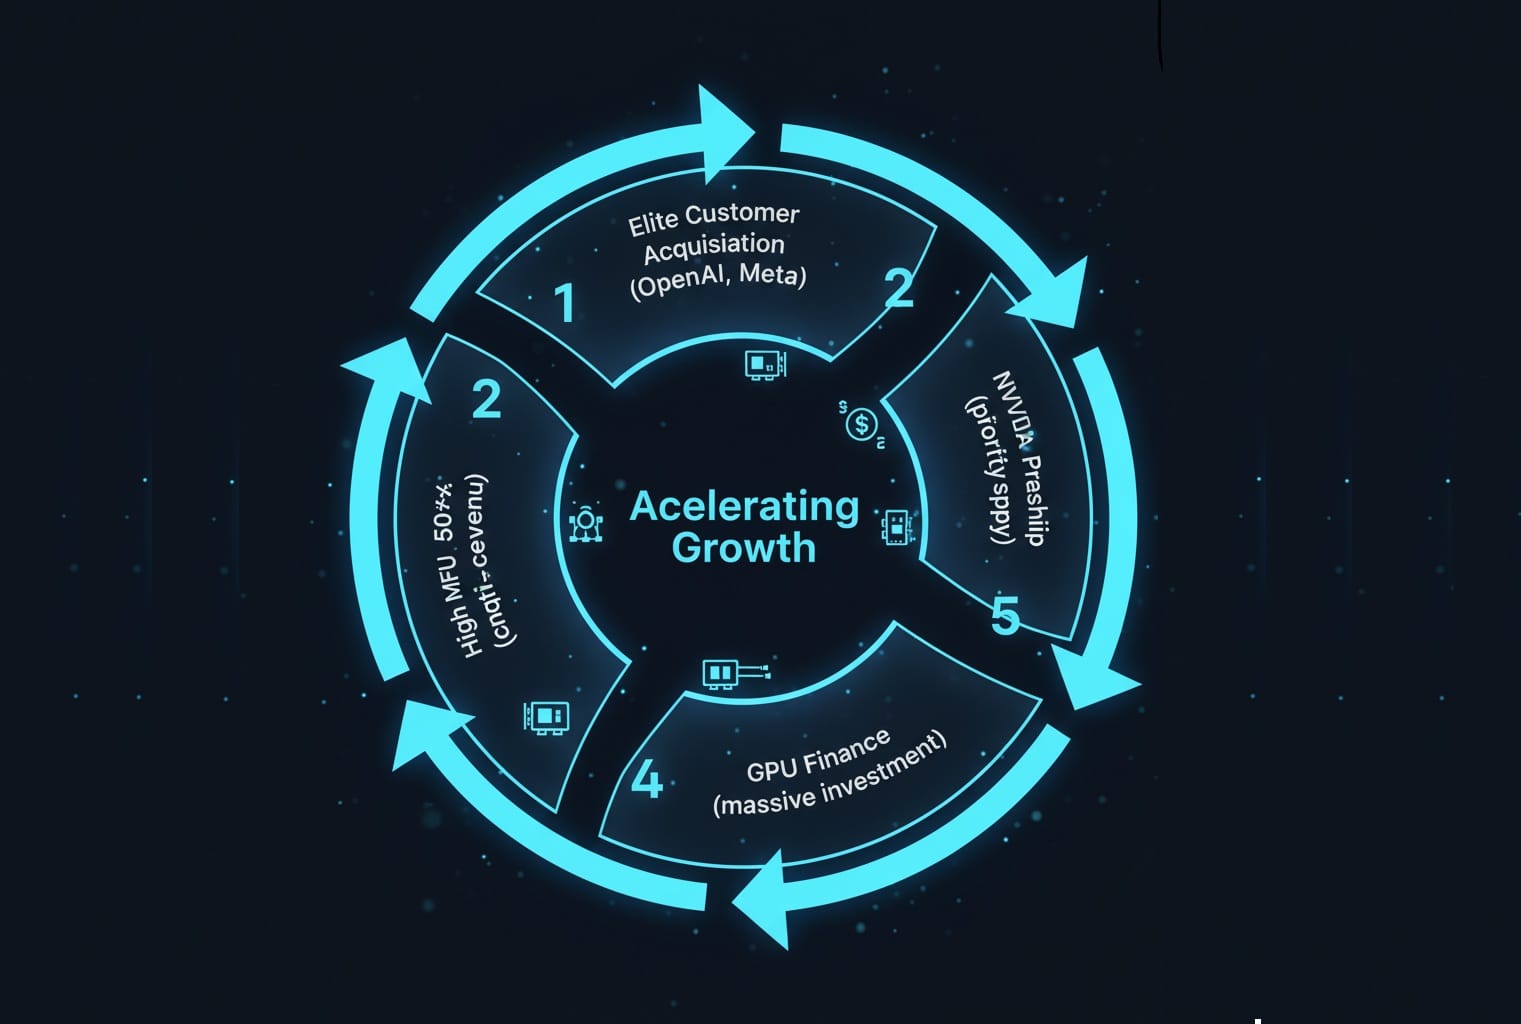
CoreWeaveは顧客との長期契約を将来収入の根拠として資金を調達し、その資金をGPUとデータセンターへ戻す資本集約型フライホイールを回している。
AIインフラは、注文が入ってからGPUを買えばよい商売ではありません。建屋、受電、液冷設備、ネットワーク、GPUを先に用意し、検証して初めて顧客を迎えられます。需要を信じて先に巨額投資できるかが、供給速度を決めます。
CoreWeaveは、信用力の高い顧客との複数年契約や設備資産を基礎に、デットを含む巨額資金を調達してきました。この手法はしばしば「GPUファイナンス」と呼ばれます。ただし、CoreWeaveが金融手法そのものを発明したと断定するのは正確ではありません。プロジェクトファイナンスや資産担保金融の考え方を、AI計算設備の急拡大へ適用したと捉える方が適切です。
2026年第1四半期には、同社は85億ドルのノンリコース型Delayed Draw Term Loan Facilityを確保したと発表しました。契約が資金を呼び、資金が設備を作り、設備が次の契約を呼ぶ。この循環が成長のエンジンです。しかし、回転が速いほど、一つの部品への依存は重くなります。その重要な部品を握っているのがNVIDIAです。
NVIDIAとの関係――近いが、同じ会社ではない
CoreWeaveはNVIDIAの投資先・パートナーであり、Hopper、Blackwell、Vera Rubinなど新世代基盤の早期検証で緊密に協力しています。2026年にはVera Rubin NVL72の立ち上げと検証を業界で初めて完了したと公表しました。
しかし、CoreWeaveはNVIDIAのクラウド部門でも子会社でもありません。NVIDIAはチップ、ネットワーク、ソフトウェアを広く売り、CoreWeaveはそれらを使ってAIクラウドを運営する独立企業です。関係が近いからこそ最新GPUへのアクセスや共同最適化で優位を得やすい一方、NVIDIA技術への依存が高いこと自体が供給・交渉・世代交代リスクになります。
CoreWeaveはSEC提出書類で、現在使用するGPUはすべてNVIDIA製であり、顧客契約もNVIDIA GPUを指定していると開示しています。供給者の変更が必要になれば、予定した計算資源を提供できず、売上の遅延、費用増加、利益率低下につながる可能性があります。NVIDIAとの近さは、CoreWeave最大の強みであると同時に、容易には切り替えられない依存関係でもあるのです。
この構図をAIインフラ市場全体から捉えるには、AIインフラ戦争|NVIDIA×OpenAI・巨大契約の全貌も参考になります。
2026年の現在地――売上・受注残・電力をどう読むか
CoreWeaveは驚異的な需要を獲得した一方、売上成長、受注残、稼働電力、会計赤字を同時に読まなければ将来性を見誤る。
数字だけを見ると、CoreWeaveは矛盾した会社に見えます。売上は前年同期から倍増し、巨大な受注残を抱えながら、公式会計では純損失が続いている。この矛盾こそ、CoreWeaveの現在地を読み解く鍵です。
| 指標 | 公表値 | 読み方 |
|---|---|---|
| 四半期売上 | 25.75億ドル | 前年同期12.12億ドルから約2.1倍 |
| 営業損益 | 4,900万ドルの損失 | 急拡大中でも公式会計上の営業黒字は未確立 |
| 純損益 | 6.26億ドルの損失 | 利払いなど資本コストの重さに注意 |
| 調整後EBITDA | 15.10億ドル、利益率59% | 事業の現金創出力を見る参考だが、利息・減価償却等を除く非GAAP指標 |
| Revenue Backlog | 約1,040億ドル | 将来売上の可視性を示すが、設備提供などの条件付き |
| 稼働電力 | 1.5GW | 実際に稼働へ到達した設備規模 |
| 契約済み電力 | 約3.7GW | 将来の拡張余地。稼働能力とは区別が必要 |
| ※出典:CoreWeave 2026年第2四半期決算(2026年6月30日終了四半期)。調整後EBITDAは非GAAP指標です。 | ||
Revenue Backlogは、いわば「将来売上の候補となる契約残高」です。2025年末の668億ドルから、2026年3月末994億ドル、6月末約1,040億ドルへ増えました。さらにCoreWeaveは、7月以降に追加した250億ドル超の新規顧客コミットメントを6月末残高へ含めていないと説明しています。
しかし、1,040億ドルが銀行預金のように確定しているわけではありません。同社の定義には、残存履行義務に加え、サービスの提供能力や可用性などの条件を満たした場合に売上計上を見込む金額が含まれます。データセンター建設が遅れれば、契約があっても計算能力を渡せません。
また、第2四半期の支払利息純額は6.40億ドル、純損失は6.26億ドルでした。利息だけで四半期売上の約4分の1です。調整後EBITDAが厚く見えても、公式会計では資本コストが利益を押し下げます。利息、減価償却、株式報酬などを含む公式会計の利益とは、分けて読む必要があります。CoreWeaveは「需要がない会社」ではなく、「需要を満たすための資本負担が極めて重い会社」と読むのが実態に近いでしょう。
CoreWeaveの将来性――成長装置と危険装置は同じである
CoreWeaveの将来性はAI需要の大きさだけでなく、巨額契約を予定どおり設備・稼働・キャッシュへ変換できるかで決まる。
CoreWeaveを急成長させた武器と、同社を最も危うくするリスクは、どちらも「最新GPUと電力を誰より早く大量に確保する」という同じ戦略から生まれます。強気に設備を押さえれば需要を先取りできますが、需要の鈍化、建設遅延、金利上昇、技術世代交代が起きたときの固定負担も大きくなります。
成長を支える4つの要因
- AI学習から推論への需要拡大:モデル開発だけでなく、本番推論が継続的な計算需要を生む
- 顧客層の拡大:AIラボだけでなく、Meta、Anthropic、Cohere、Mistral、Databricks、企業顧客との契約を公表
- 新世代基盤への早期対応:BlackwellからVera Rubinまで、顧客が本番でデバッグする前に基盤を検証する
- クラウド間接続:Google Cloudとの接続を皮切りに、CoreWeave Interconnect、SUNK Anywhere、LOTA Cross-Cloudを展開
見逃せない5つのリスク
- 設備履行リスク:契約済み電力を稼働設備へ変えるまでに、受電・冷却・建設・GPU供給の壁がある
- 資本コスト:巨額借入により利払いが増え、会計利益とキャッシュを圧迫する
- 顧客集中:巨大契約は成長を加速する一方、少数顧客の方針変更が影響しやすい
- NVIDIA依存:最新GPUの優先対応が強みである反面、単一エコシステムへの依存を深める
- 技術陳腐化:GPU世代交代が速く、旧世代設備の稼働率と残存価値を維持する必要がある
株価が上がるか、テンバガーになるかは、この記事では予測しません。テック企業として評価するなら、四半期の値動きよりも、稼働電力、設備立ち上げ速度、goodput、顧客構成、利息負担、受注残の売上転換を追う方が本質的です。市場の期待ではなく、成長装置が実際に回り続けているかを確認するためです。
企業はCoreWeaveをどう評価すべきか
クラウド選定ではGPUの時間単価だけでなく、学習完了までの時間、失敗回数、移行費、データ転送、支援体制を含むTCOで判断すべきである。
もしあなたの会社がCoreWeaveを候補にするなら、「H100はいくらか」だけを聞いてはいけません。安いGPUが何度も止まれば、研究者の待ち時間、再実行、納期遅延で総費用は膨らみます。逆に高い時間単価でも短期間で完走できれば、製品投入を早められます。
ここで一度、自社に問いを返してみてください。いま困っているのは「GPUが借りられないこと」なのか、それとも「借りても学習が完走しないこと」なのか。答えによって、選ぶべきクラウドは変わります。
| 判断軸 | 確認する質問 | 危険な見方 |
|---|---|---|
| 実効性能 | 自社モデル・精度・GPU数でのtokens/s、MFU、完走時間はどうか | 事業者公表の最大値だけで決める |
| 可用性 | ノード障害、交換、チェックポイント、SLA、goodputの定義は何か | 稼働率と学習完走率を同じと考える |
| データ | 投入・保存・退避・クラウド間転送の時間と料金はどうか | GPU単価だけをTCOとみなす |
| ロックイン | Kubernetes、Slurm、ストレージ、監視データを他環境へ移せるか | 短期性能だけで出口設計を省く |
| 供給 | 必要な時期に必要GPU数と電力を確保できる契約か | 契約締結を即時利用可能と誤認する |
| 事業継続 | 長期契約、前払い、容量予約の責任分界と代替策は何か | 急成長企業だから供給は自動的に安全と考える |
向いているケース
CoreWeaveが向くのは、大規模な学習・推論を行い、最新GPU、広帯域ネットワーク、専門的な運用支援を一体で必要とする組織です。数百・数千GPUへ拡張したときに通信と障害対応が支配的になるワークロードほど、AI特化設計の価値が出やすくなります。
向いていないケース
一般的なWebシステム、豊富な業務SaaS連携、世界中のリージョン、既存のAWS/Azure/GCPサービスとの密結合が中心なら、総合クラウドの方が自然な場合があります。小規模な推論や断続的な検証では、専用クラスタよりサーバーレスAPIや従量課金が合理的なこともあります。
正しい問いは「CoreWeaveはAWSより優れているか」ではなく、「自社のAI処理で、専門クラウドの速さが移行・契約・集中リスクを上回るか」です。
一次情報からどこまで言えるか
確認できる事実は高い需要と急速な設備拡大であり、長期的な勝者になるかは受注残を安定稼働と利益へ変換できるかに残されている。
確認できること
- 2026年第2四半期売上25.75億ドル、Revenue Backlog約1,040億ドル、稼働電力1.5GWは同社決算で公表されている
- Hopper GPUでMFU 50%超、最大20%高い性能、最大96% goodputはCoreWeaveの自社試験・説明として公開されている
- 2026年6月にVera Rubin NVL72の立ち上げと検証を完了したと同社が公表している
- 一方で第2四半期は営業損失4,900万ドル、純損失6.26億ドル、支払利息純額6.40億ドルである
まだ証明されていないこと
- すべてのモデルとクラスタ規模で他クラウドより20%速いこと
- 約1,040億ドルのRevenue Backlogが全額、予定どおり売上になること
- 契約済み3.7GWが遅延なく稼働し、十分な利用率と採算を得られること
- 急速なGPU世代交代の中で、長期的に高い資本効率を維持できること
したがって、CoreWeaveを「次のAWS」と断定するのも、「借金でGPUを買うだけの会社」と切り捨てるのも早計です。2026年8月時点の証拠が示すのは、AI専用クラウドという新しい企業類型が巨大需要を獲得し、その経済性を実運用で試しているという現在地です。
まとめ――GPUを持つ会社から、GPUを働かせる会社へ
CoreWeaveの本質はGPUの在庫量ではなく、計算資産を止めずに顧客成果へ変え、契約と資本で再拡大する仕組みにある。
CoreWeaveは、暗号資産マイニングでGPUを資産として扱う方法を学び、AI特化クラウドへ転換しました。ベアメタル、InfiniBand、液体冷却、ストレージ、スケジューリング、可観測性を一体化し、GPUのカタログ性能と実際の成果の間にある「効率の谷」を埋めようとしています。
そこへ長期契約と資金調達を組み合わせ、設備を先回りして作るフライホイールを構築しました。2026年第2四半期の売上、受注残、稼働電力は、その装置が猛烈な速度で回っていることを示します。
しかし、回転が速い装置ほどブレーキも重要です。設備遅延、利払い、顧客集中、NVIDIA依存、旧世代GPUの価値低下が同時に襲えば、強みだった先行投資が固定負担へ変わります。
満席の新幹線を持つだけでは勝てない。定刻に走らせ、乗客を届け、次の編成を無理なく増やせるか。CoreWeaveの将来性は、GPUの台数ではなく、この三つを証明し続けられるかにかかっています。
その答えは、まだ出ていません。
専門用語まとめ
- ネオクラウド
- AI・HPCなどGPU中心の処理へ特化した新興クラウド事業者の総称。業界共通の厳密な規格名ではありません。
- MFU(Model FLOPs Utilization)
- GPUの理論演算性能のうち、モデルの学習計算に有効利用できた割合。モデルや試験条件をそろえて比較する必要があります。
- goodput
- 割り当てた計算時間のうち、失敗・再起動・保守などを除いて有効な処理を進められた割合。定義は提供者ごとに確認が必要です。
- Revenue Backlog
- CoreWeaveが将来の売上として見込む契約残高。残存履行義務等を含みますが、設備提供や可用性などの条件を伴います。
- 調整後EBITDA
- 利息・税金・減価償却等を除いて事業の収益力を見る非GAAP指標。公式会計の営業利益や純利益とは異なります。
- SHARP
- All-Reduceなどの集約処理をネットワーク側へオフロードし、分散計算の通信負担を減らすNVIDIAの技術です。
参考文献 / 出典
一次情報
- CoreWeave – 2026年第2四半期決算
- CoreWeave – 2026年第1四半期決算
- CoreWeave – 2025年度通期決算
- CoreWeave – MFUとGPUクラスタ性能の検証
- CoreWeave – Vera Rubin NVL72の運用と検証
- CoreWeave – Why CoreWeave
- CoreWeave – SUNK
- CoreWeave – 2026年第1四半期Form 10-Q(SEC提出書類)
※企業の性能値、goodput、技術的優位性はCoreWeaveの自社試験・自社発表を含みます。本文では第三者による一般保証値と区別して記載しています。
あわせて読みたい
よくある質問
Q1.CoreWeaveは何の会社ですか?
A1.AI学習・推論やHPC向けにGPUクラスタを提供する、AI特化型クラウド企業です。GPUだけでなく、ネットワーク、ストレージ、冷却、Kubernetes、Slurm、監視・運用支援を一体で提供します。
Q2.CoreWeaveは何がすごいのですか?
A2.大規模GPUを調達するだけでなく、止めずに高効率で動かす全スタックをAI専用に最適化している点です。MFU 50%超や最大96% goodputを公表していますが、いずれも条件付きの自社公表値として読む必要があります。
Q3.CoreWeaveの将来性と最大のリスクは何ですか?
A3.AI計算需要と巨額受注残は強い追い風ですが、契約を設備・稼働・利益へ変換できるかが最大の焦点です。設備建設、利払い、顧客集中、NVIDIA依存、GPUの世代交代が主なリスクです。
更新履歴
- 2026年8月13日:2026年第2四半期決算、Vera Rubin検証、MFUの条件、将来性とリスクを反映し全面改訂
- 2025年10月20日:初版公開