※本記事は継続的に最新情報へアップデートしています。
本記事の問いは、現場を何より重視するトヨタが、なぜNVIDIAの大規模な「仮想世界」を必要とするのか、という一点である。
2026年7月、NVIDIAはトヨタとの協業を車両から工場・ロボティクス・都市インテリジェンスへ広げ、OmniverseライブラリとIsaac Simを活用した工場・ロボットのシミュレーションを進める方針を公表した。
両社は実機データ、シミュレーション、模倣学習、強化学習、Diffusion Transformer、世界モデルといった似た技術を使うが、「何を起点にし、何を最適化するのか」は大きく異なる。
その違いと、両社がなぜ交わり始めたのかを解くことが本記事の主題である。
✅ 先に結論
トヨタ/TRIは「現場接地型」、NVIDIAは「経験増幅型」と捉えると違いが分かりやすくなります。
- トヨタ/TRI:現場・人・実機を強い起点にし、仕事が現実の環境で成立することを重視する
- NVIDIA:実世界の経験をSim・生成AI・基盤モデルで増幅し、学習と評価を大規模化する
- 共通する方向:Real → Sim → Scale → Real → Kaizenの閉じた学習ループへ向かう
まず結論:トヨタ方式とNVIDIA方式は何が違うのか
トヨタ/TRIとNVIDIAは同じ技術要素を使いながら、最適化する学習ループと事業上の重心が異なるのである。
| 比較軸 | トヨタ/TRI | NVIDIA |
|---|---|---|
| 起点 | 現場・人・実機 | データ・モデル・計算基盤 |
| 最適化対象 | 現場で仕事が成立すること | 学習・開発を大規模化すること |
| データ | 高品質な実演・実機データを強いアンカーにする | 実データをSim・生成AIで増幅する |
| 身体 | 身体とAIを共同設計できる | 多様な身体へ共通基盤を展開する |
| Simulation | 現実との誤差を縮める | 探索範囲と試行回数を広げる |
| 評価 | 実機・現場で仕事が成立するか | 大量並列評価+実機検証 |
| 事業構造 | 垂直統合型 | 水平プラットフォーム型 |
| ※出典:トヨタ、TRI、NVIDIAの一次情報をもとにArpable編集部作成(2026年9月時点)。 | ||
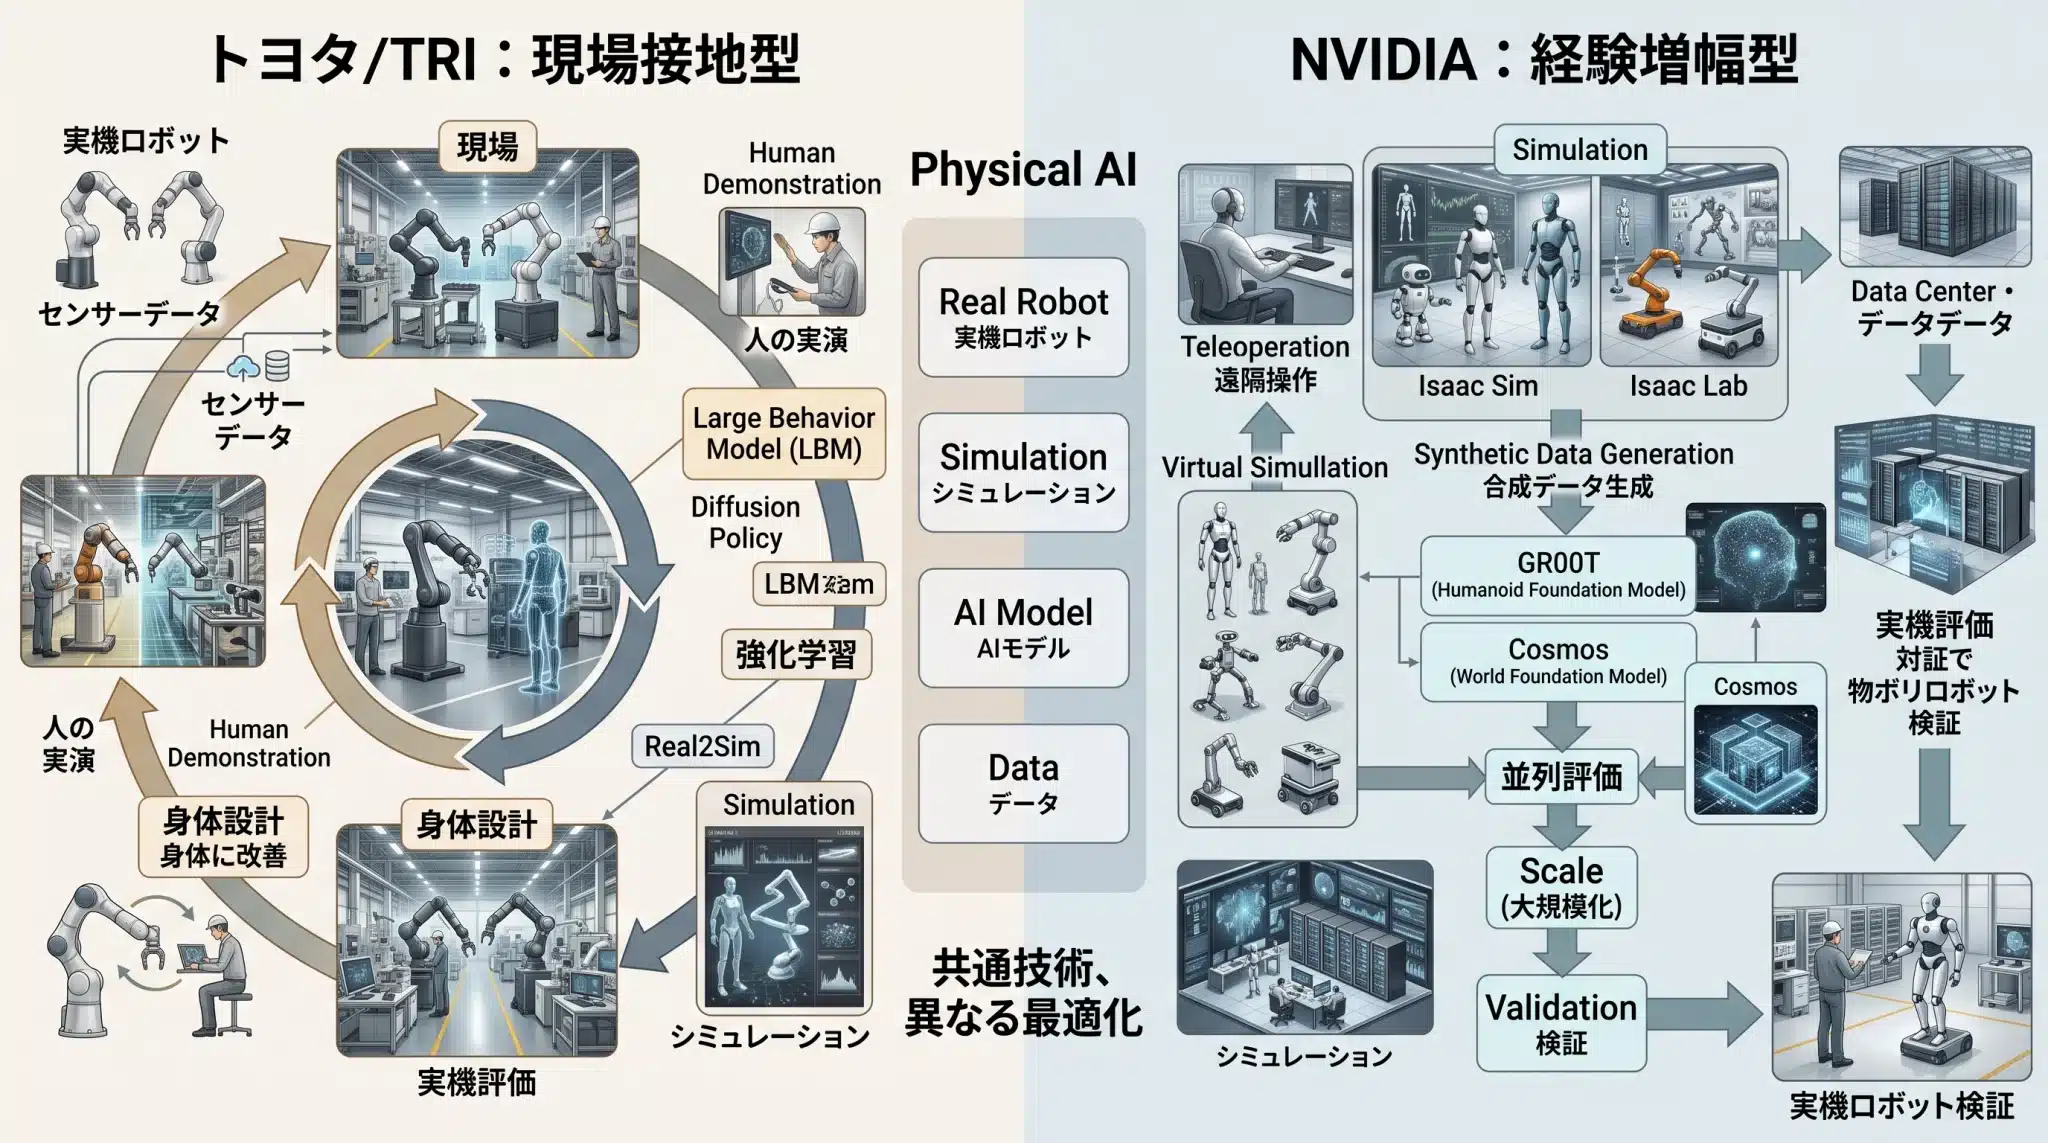
本記事では、トヨタ側を「現場接地型」、NVIDIA側を「経験増幅型」と呼びます。両社の公式名称ではありませんが、公開されている研究と実装を比較するための整理として用います。
なお、TRIとトヨタ自動車の未来創生センターは役割が異なります。TRIはLarge Behavior Model(LBM)や世界モデル、Boston Dynamicsとの共同研究などを進め、未来創生センターはELEY、ヒューマノイドの強化学習、Potaroなど、身体設計や実機・現場への適用を研究しています。
トヨタのPhysical AI――現場・環境・身体から設計する
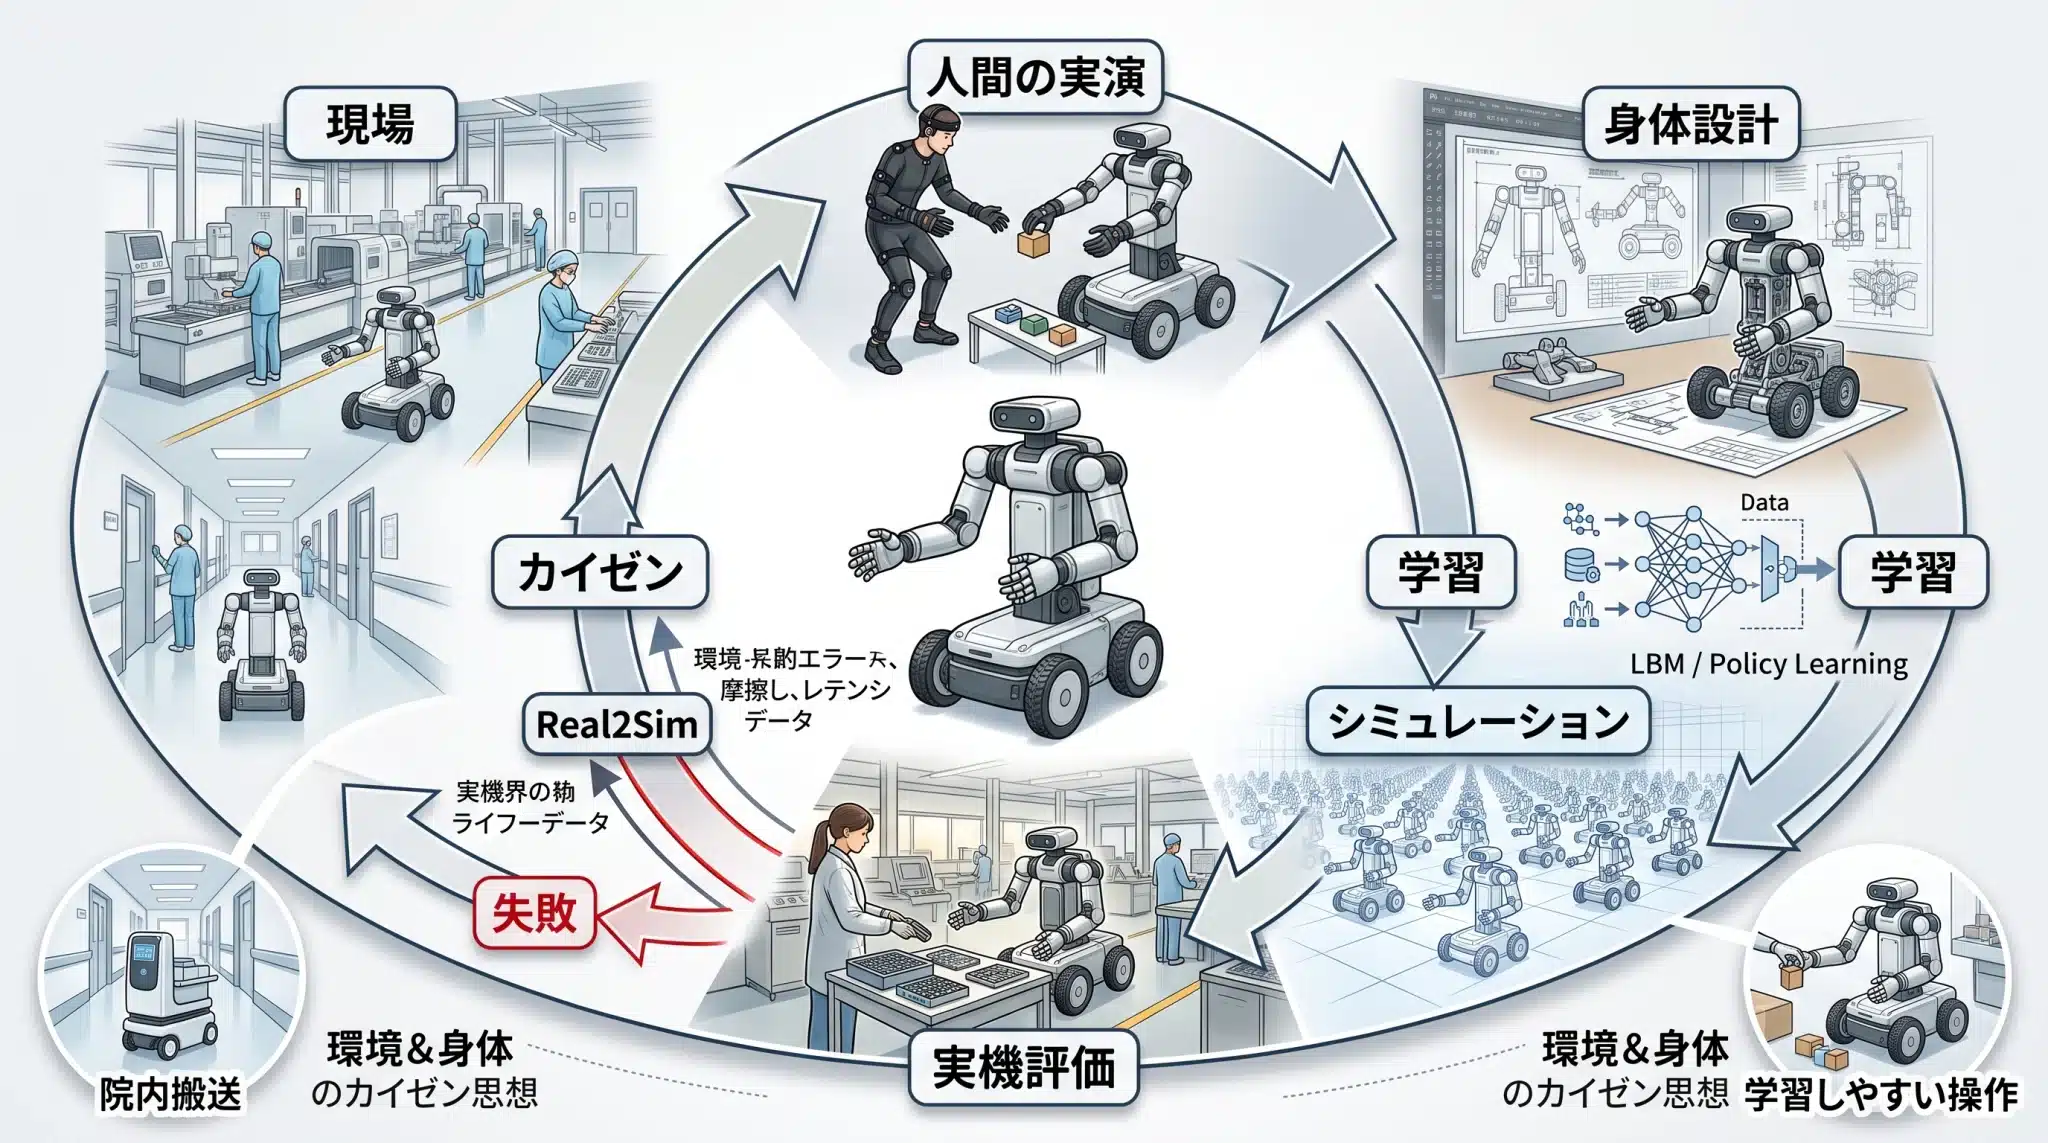
トヨタ方式は、AIモデルだけでなく現場・環境・身体まで含めて設計し、実機で仕事が成立することを最適化するのである。
Potaro:ロボットだけでなく環境を変える
象徴的なのが、トヨタ記念病院で運用されている院内搬送ロボット「Potaro(ポタロ)」です。2023年5月から24台が稼働し、トヨタ公式によれば搬送成功率99%、累計走行距離27,000kmに達しています(2026年1月時点)。[8] 重要なのは台数ではありません。
通路、待機場所、エレベーター、自動ドア、人の動線まで含め、ロボットが働ける環境を設計していることです。「ロボットを現場へ入れる」のではなく、「現場とロボットを一緒に設計する」。ここにトヨタらしさがあります。
ELEY:今度は身体そのものを学習しやすくする
ELEY(エリー)は二足歩行型ではなく、全方向移動台車の上に人間に近い二本の腕を備えたモバイルマニピュレーターです。低減速比のQDD(Quasi Direct Drive)アクチュエータ、高いバックドライバビリティ、人間に近い腕の寸法や関節配置を採用し、人の動作を学びやすい身体を目指しています。
Potaroが「環境」を変える例なら、ELEYは「身体」を変える例です。AIだけを賢くするのではなく、AIが学びやすい身体を作る。この共同設計は完成機メーカーであるトヨタの強みです。
TRIのLBM――人間の技能をデータとして移す
TRIは人間の実演を大規模な行動データへ変換し、多数のタスクへ転用できるLarge Behavior Modelを研究しているのである。
Diffusion Policyは、一つの「平均的な正解動作」に押し込めず、複数の成立する動作パターンを扱いやすい手法です。TRIはこの考え方を大規模な多タスク学習へ拡張し、Large Behavior Model(LBM)を研究しています。
Science Roboticsで公開された大規模検証では、約1,700時間のロボットデータを使ってDiffusion Transformer型LBMを学習し、1,800回の実世界ロールアウトと47,000回超のシミュレーションロールアウトで評価しました。難しい新規タスクでは、事前学習によって必要な追加データを3分の1から5分の1程度に減らせたと報告されています。
ここで重要なのは、このデータがTRIの実機だけではない点です。実機テレオペ、シミュレーション、UMI、Open X-Embodimentなどを組み合わせています。「トヨタ/TRI=実機だけ」という理解は正しくありません。
2025年にはBoston Dynamicsの電動AtlasにもTRIのLBMを適用し、歩行、しゃがむ、把持、再把持、移動を一連の全身動作として実行する研究成果を公開しました。[5] ただし、これはあくまで研究段階の成果です。何時間も動き続けられるか、見たことのない作業に対応できるかは、これからの検証課題です。
トヨタも仮想世界でロボットを鍛えている
トヨタも強化学習、Sim2Real、Real2Simを使い、現実を基準にシミュレーション自体を改善する開発ループを構築しているのである。
トヨタ未来創生センターは、シミュレーション上に数千体のヒューマノイドを用意し、強化学習で歩行を学ばせています。トヨタによれば、1~2時間程度で歩行を学習し、その後に実機へ移して検証しています。
さらに実機アクチュエータから得た静摩擦、動摩擦、粘性摩擦、慣性などをシミュレータへ戻すReal2Simも実施します。シミュレーションで学び、実機で誤差を測り、その誤差を仮想世界へ戻す。トヨタはシミュレーションを避けているのではなく、現実を基準に仮想世界もカイゼンしているのです。
NVIDIAのPhysical AI――現実の経験を「データ工場」で増幅する
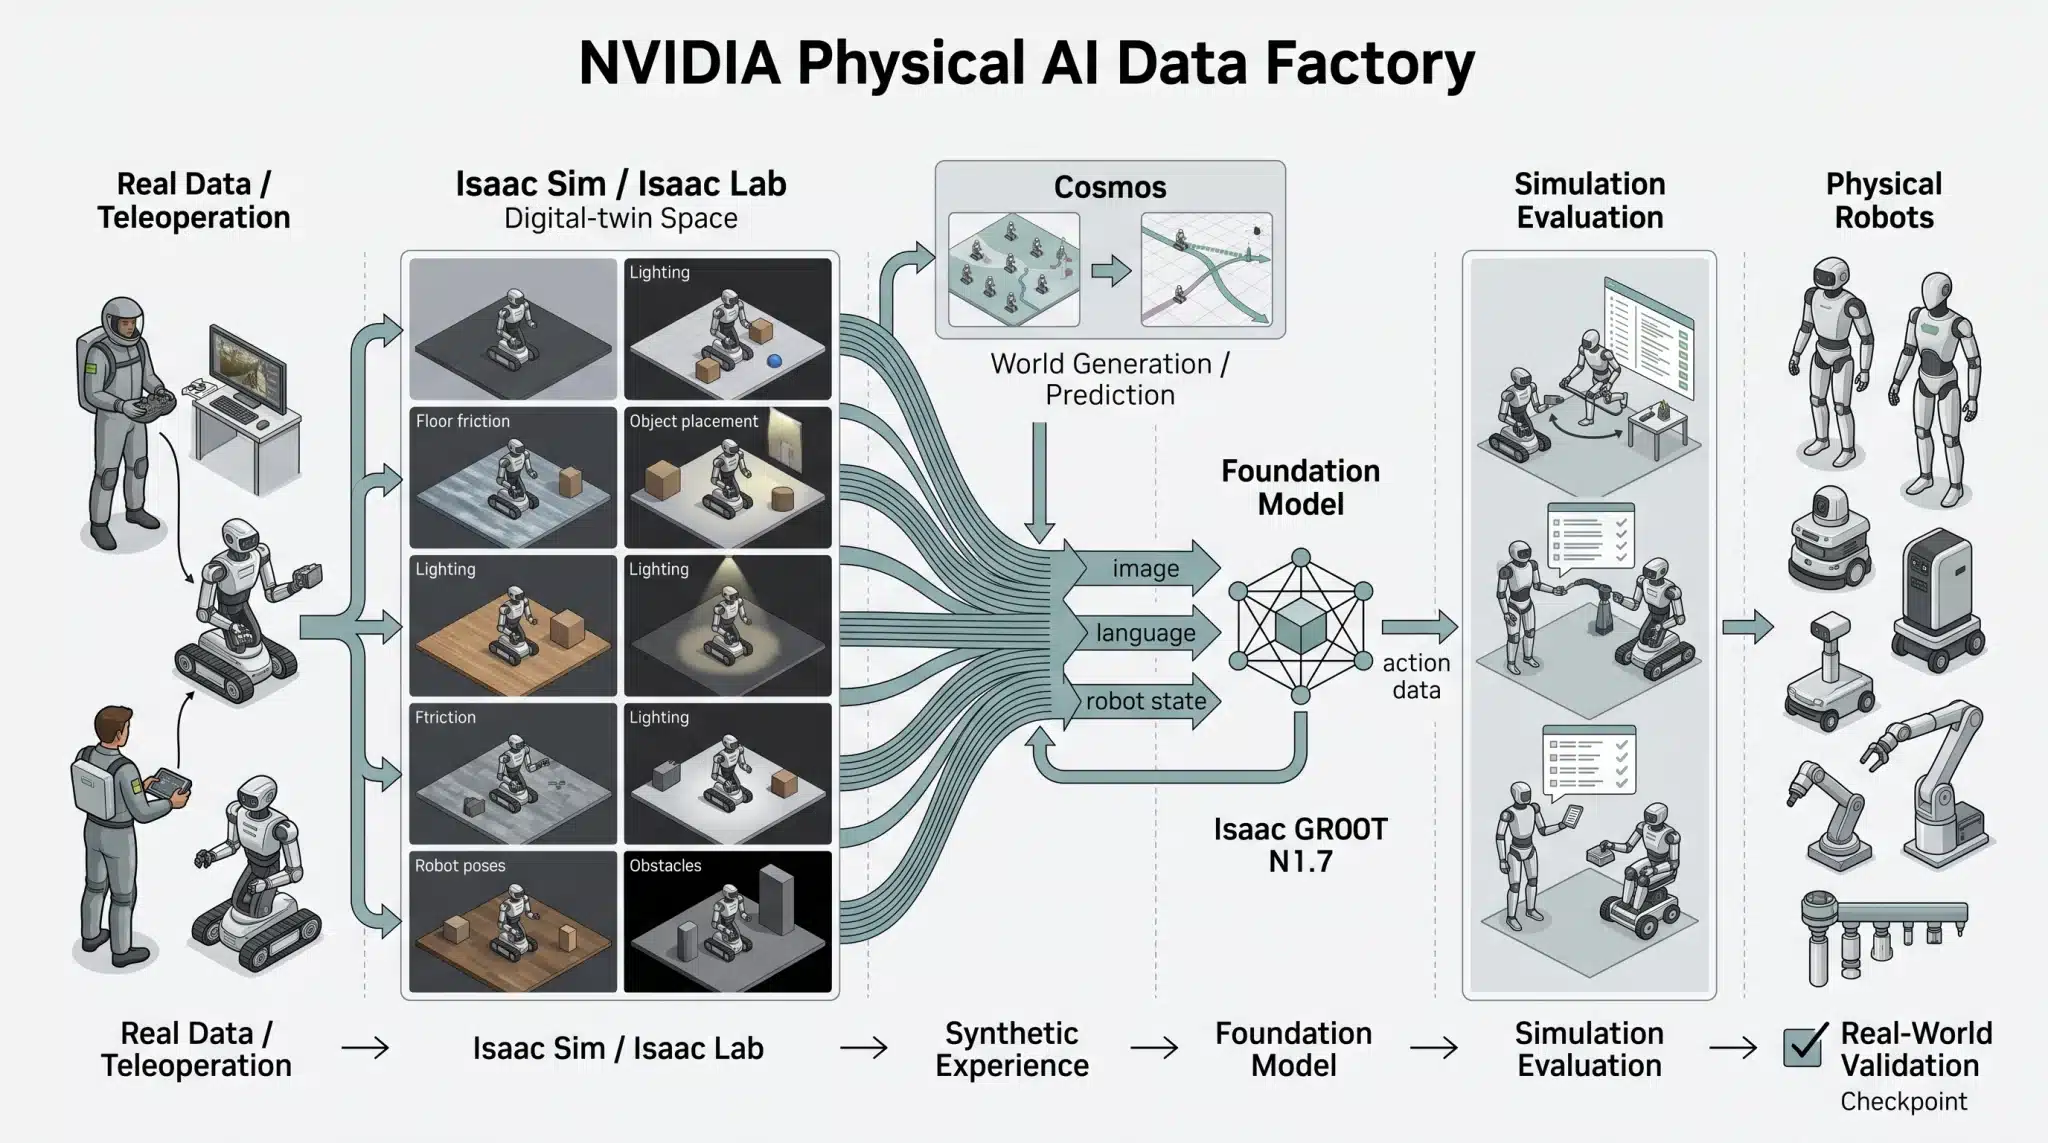
NVIDIA方式は、実データをシミュレーション、生成AI、基盤モデルで増幅し、学習・評価を共通基盤として大規模化するのである。
Isaac Teleopで人間の実演を集め、Isaac Sim / Isaac Labで仮想環境を作り、GR00Tで行動モデルを学習・評価します。さらに必要に応じて、Cosmosによる世界生成や未来予測で学習データを補強します。個別製品より重要なのは、これらを接続できる開発基盤です。
NVIDIA Isaac GR00T N1.7は、画像・言語・ロボット状態などを入力して連続行動を生成するVLA(Vision-Language-Action)モデルです。NVIDIAの2026年7月の開発ブログによれば、事前学習には約3万2,000時間の実世界デモ・人間一人称データに加え、約8,000時間のシミュレーションロールアウト/デモが使われています。行動生成部にはDiffusion Transformerを採用しています。[6]
Cosmos 3は、視覚推論、世界生成、行動予測を統合するWorld Foundation Modelです。「この行動をしたら世界はどう変化し得るか」という未来候補を生成・評価し、合成データや方策学習を補強できます。[7]
言い換えれば、NVIDIAが作っているのは「現実では集めきれない経験を計算機上で量産するデータ工場」です。ただし、生成された世界が自然に見えることと、実機で安全に動けることは同義ではありません。最終的な実機検証は不可欠です。NVIDIA側の開発基盤をさらに掘り下げる場合は「SO-101で学ぶNVIDIA IsaacとPhysical AI」も参考になります。
違い① データ――「現実を基準にする」か「経験を増幅する」か
トヨタ/TRIは実世界データを強い基準点とし、NVIDIAはその周囲の経験空間を計算機上で大規模に広げるのである。
実機データには摩擦、遅延、変形など現実の複雑さが自然に含まれますが、収集には時間・人・機体が必要です。NVIDIAはシミュレーションや生成モデルによって、危険ケースや希少ケースまで大量に試せるようにします。
最終的には、質の高い実データをアンカーにし、仮想空間で経験を増幅するハイブリッド型へ両者は近づいています。しかし、データを増やすだけでは十分ではありません。身体が違えば、同じ技能をそのまま移せるとは限らないからです。
違い② 身体――AIと身体を共同設計するか、多様な身体へ広げるか
トヨタは身体そのものをAIの学習条件として設計でき、NVIDIAは共通AI基盤を多様なロボットへ展開しようとするのである。
ELEYのように身体、アクチュエータ、関節配置まで変えられるのはメーカーの強みです。一方NVIDIAは、多様なロボットメーカーが同じモデル、データ形式、シミュレーション環境を利用できることに価値があります。
この差は技術思想だけでなく、メーカーとプラットフォーマーという事業上の立ち位置から生まれています。
違い③ シミュレーション――「現実へ近づける」か「探索空間を広げる」か
トヨタは現実との誤差を縮めるためにSimを使い、NVIDIAは経験量と探索範囲を広げるためにSimを大規模化するのである。
開発ループとして単純化すると、トヨタはReal → Sim → Real、NVIDIAはReal → Sim → Scale → Realと表せます。もちろん実際には両社とも双方を行います。
自社に必要なのは、シミュレーションの「精度」でしょうか。それとも試行できる「量」でしょうか。実機で失敗しても原因がSimへ戻らないなら、まず精度を上げる仕組みが必要です。実機を動かす前に危険ケースを十分試せないなら、量を増やす価値が高くなります。
違い④ 評価――「仕事が成立したか」と「どこまで事前に潰せるか」
トヨタは実機・現場で仕事が成立するかを重視し、NVIDIAは大量の条件を実機投入前に並列評価できる基盤を提供するのである。
8時間動けるか、人が横切れば止まれるか、部品位置が少しずれても対応できるか。トヨタ側ではこうした実機・現場評価が重要になります。一方NVIDIAは、実機へ出す前に多数の条件をシミュレーションで並列評価できます。
シミュレーションで失敗するロボットは現場へ出せません。しかし、シミュレーションで成功しただけでも現場へ出せません。Physical AIには両方の評価が必要です。
違い⑤ スケール――現場を増やすトヨタ、エコシステムを増やすNVIDIA
トヨタは成立した仕組みを工程や工場へ横展開し、NVIDIAは共通基盤を多数のメーカーや開発者へ横展開するのである。
トヨタは、一つの現場で成立した仕組みを別工程、別工場、グループへ横展開します。NVIDIAは、一つの開発基盤を多数のロボットメーカー、研究機関、開発者へ広げます。
100の工場へロボット運用を広げる企業と、100のロボットメーカーへ開発基盤を広げる企業。同じ「スケール」でも、増やしているものは違うのです。
では、どちらの方式が何に効くのか
重要なのは方式の優劣ではなく、自社の学習ループのどこにボトルネックがあり、どの強みを使うべきかを見極めることである。
| 求める効果 | 重心を置きやすい方式 |
|---|---|
| 接触の多い精密作業・柔軟物操作 | 実機・人間デモを強く使う方式 |
| 歩行・バランス・危険条件探索 | 大規模シミュレーション |
| 多数の機体への横展開 | NVIDIA型の共通基盤 |
| 特定工場への最適化 | トヨタ型の現場閉ループ |
| 最終的な実機信頼性 | 実データ+Sim+実機検証の統合 |
| ※出典:本記事で扱うトヨタ/TRI、NVIDIAの公開情報をもとにArpable編集部整理(2026年9月時点)。 | |
見るべきなのは、自社の学習ループのどこにボトルネックがあるかです。データ不足なのか、Sim環境なのか、実機検証なのか、失敗データが学習へ戻らないことなのか。課題が違えば、打ち手も変わります。
対立ではなく融合へ――トヨタとNVIDIAはなぜ2026年に手を組んだのか
2026年の協業拡大は、現場資産を持つトヨタと学習基盤を持つNVIDIAの強みが、閉じた学習ループの中で補完し得ることを示すのである。
NVIDIAの発表では、トヨタとの協業は車両だけでなく、工場シミュレーションや都市インテリジェンスにも広がっています。製造分野では、OmniverseライブラリとIsaac Simを使い、工場・ロボティクスのワークフロー、ロボット動作、デジタルツイン環境をシミュレーションすると説明されています。
現場を重視するトヨタが、なぜNVIDIAの仮想世界を必要とするのか。両社が協業の狙いをこの言葉で説明しているわけではありませんが、公開情報から見ると、その答えは両社の資産が補完的だからだと考えられます。
トヨタには、現実の工場、人、ロボット、身体設計、成功・失敗データ、カイゼンがあります。NVIDIAには、GPU、Digital Twin、Isaac、GR00T、Cosmos、大規模並列学習があります。現場で得た経験を仮想世界で増幅し、結果を再び実機へ戻す。そして新しい失敗を次の学習へ返す。両社の違いは、閉ループを作るうえではむしろ補完関係になります。
両社の協業を企業戦略の視点から整理した内容は「トヨタとNVIDIAの全方位戦略」でも詳しく解説しています。
Physical AIの勝負は「モデル」ではなく学習ループになる
Physical AIの競争力はモデル単体ではなく、現実と仮想世界を往復し、成功と失敗を次の学習へ戻す速度で決まるのである。
TRIのLBMはDiffusion Transformerを使い、TRI研究者が参加するUnified World Modelsでは、動画と行動のDiffusionを一つのMultimodal Diffusion Transformerで扱います。[9] NVIDIAのGR00T N1.7も、VLMとDiffusion Transformerを組み合わせ、実データとSimデータの双方を使います。[6]
使っている「部品」は、以前より似てきました。差がつくのは、それをどうつなぎ、改善ループをどれだけ速く回せるかです。実世界で良質な経験を集める。仮想世界で増幅する。実機へ戻す。失敗を再び学習へ返す。
Real → Sim → Scale → Real → Kaizen。
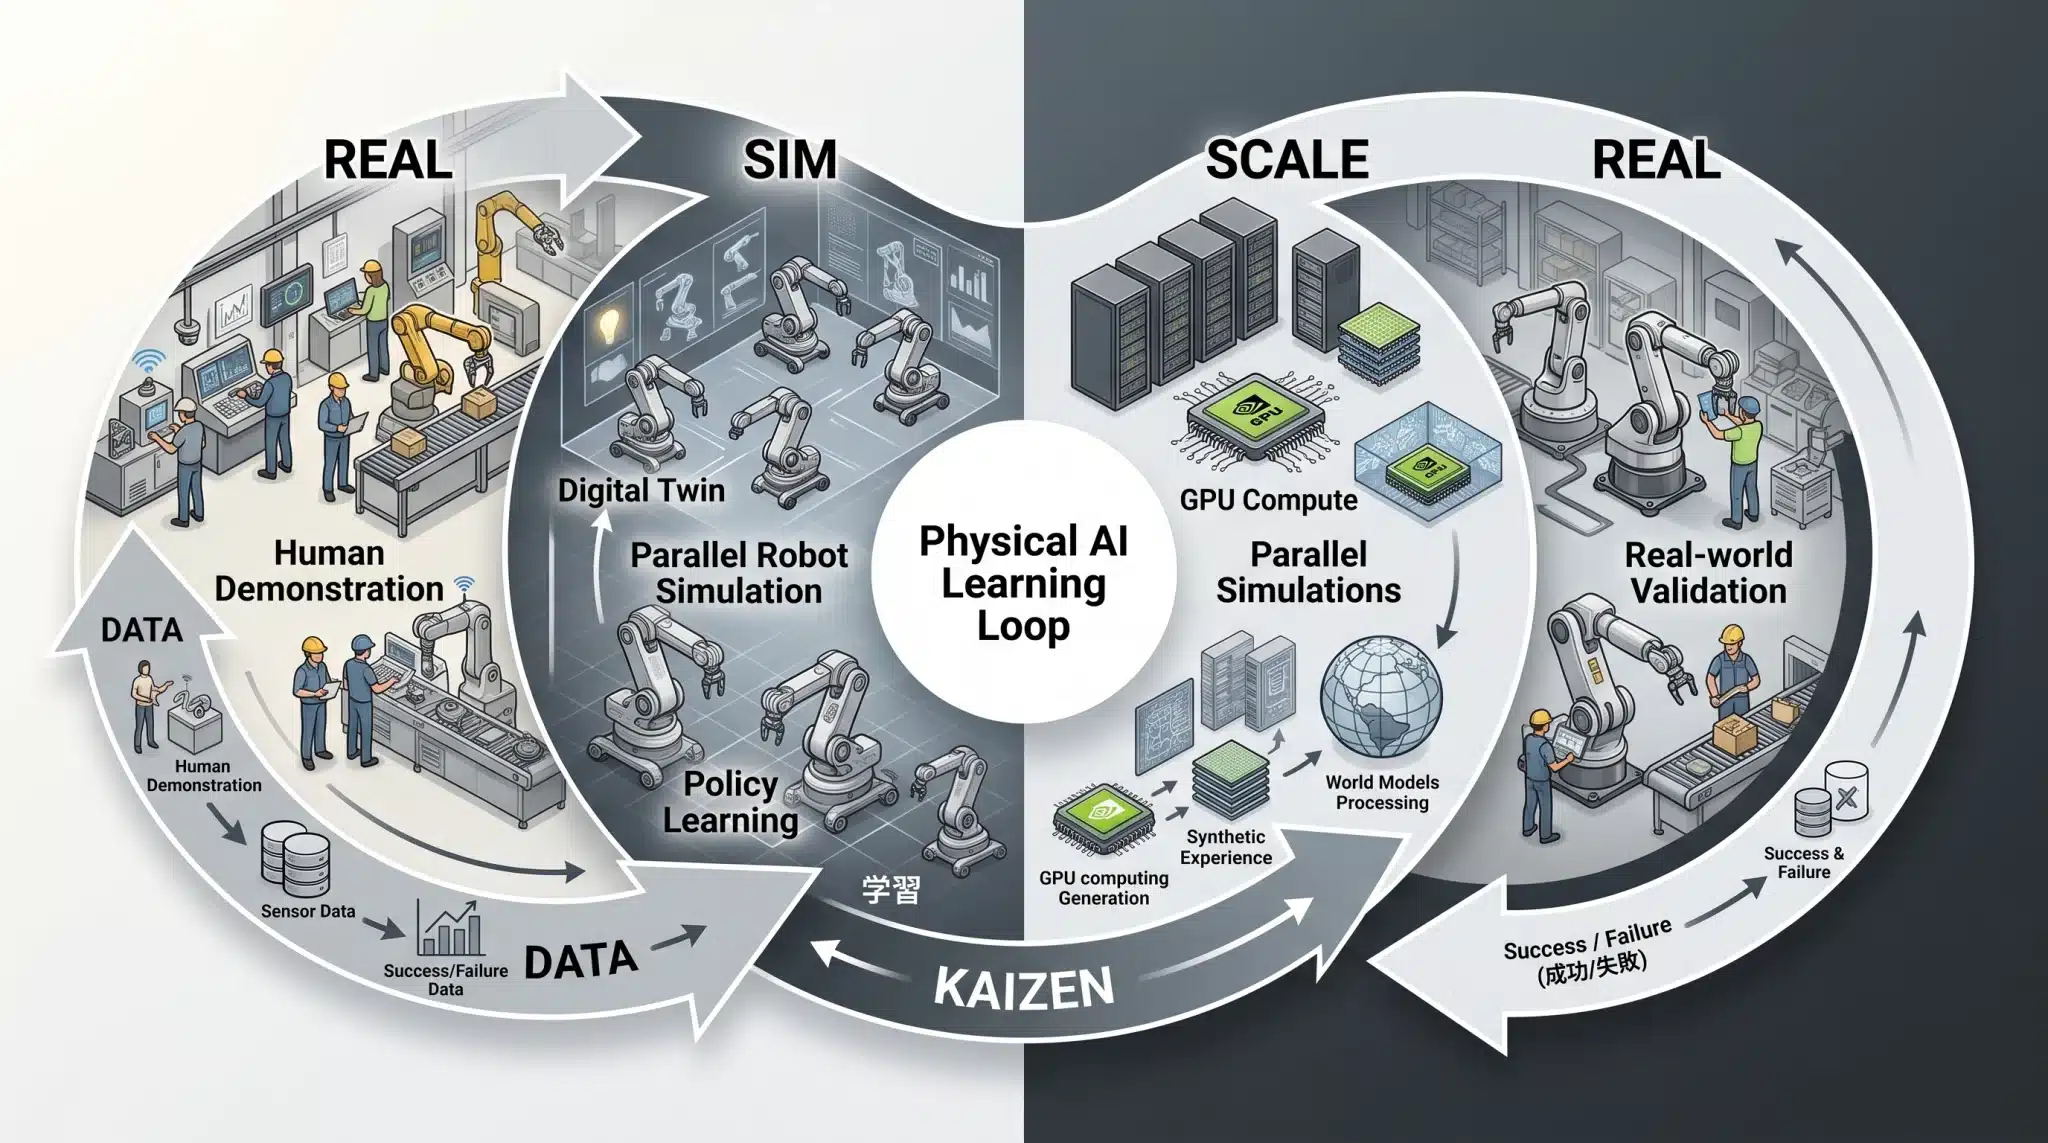
月単位だった改善が週単位へ、週単位だったものが日単位へ近づけば、同じ基盤モデルを使っていても数年後の差は大きくなります。
企業がPhysical AI導入で確認すべき5つのポイント
企業導入ではモデル名よりも、データ収集、Sim、実機評価、失敗の再学習までを自社で閉じられるかを確認すべきである。
確認すべきなのは、①現場から高品質な成功・失敗データを取れるか、②現実をSimへ写せるか、③Sim2Real Gapを測れるか、④十分な回数の実機評価ができるか、⑤失敗データが次の学習へ戻るか、の5点です。
Physical AIとは、優秀なモデルを一度導入するプロジェクトではありません。現場そのものを、学び続けるシステムへ変えるプロジェクトです。
まとめ――トヨタは現実から学び、NVIDIAは現実を増幅する
トヨタとNVIDIAの違いを追うと、Physical AIの競争軸がモデル性能から学習ループ全体の速度と質へ移っていることが分かるのである。
NVIDIAが作ろうとしているのは、多様なロボットを高速に学習・評価できる基盤です。トヨタが作ろうとしているのは、人とロボットが同じ現場で働き、その成功と失敗を次の改善へ戻せる仕組みです。
NVIDIAは経験を増幅する。トヨタは経験を現場価値へ変える。
Real → Sim → Scale → Real → Kaizen。現実と仮想世界の間で、どれだけ速く、正確に学び続けられるか。そこに、トヨタ方式とNVIDIA方式が交わる次の競争軸があります。
あなたの現場では、今日起きた失敗のデータは、次の学習へ戻っていますか。
専門用語まとめ
Physical AIを理解するために、LBM、VLA、Sim2Real、Real2Simなどの主要概念を整理した用語集である。
- Physical AI
- AIが物理世界を認識し、判断し、身体を使って行動する技術・システム。
- Diffusion Policy
- 拡散モデルの考え方をロボットの連続行動生成に応用した方策学習手法。複数の有効な動作パターンを扱いやすい。
- LBM
- Large Behavior Model。多様なロボット行動データを事前学習する行動モデル。
- VLA
- Vision-Language-Action。画像・言語・ロボット状態などから行動を生成するモデル。
- Sim2Real
- シミュレーションで学習・検証した方策を実機へ移す考え方。
- Real2Sim
- 実機データを使い、シミュレータの物理特性を現実へ近づける手法。
- World Model
- 現在の観測や行動から、将来の状態がどう変化し得るかをモデル化する仕組み。
参考文献 / 出典
主要な数値、製品仕様、研究成果、協業内容の根拠となる一次情報を整理した出典一覧である。
一次情報
- NVIDIA, “NVIDIA and Japan Bring Full-Stack AI and Robotics to Every Industry”, July 15, 2026
- トヨタ自動車 未来創生センター, 「やさしく触れることで未来を変える」― ELEY, 2026年3月31日
- トヨタ自動車 未来創生センター, 「ヒューマノイドロボットと強化学習の取り組み」, 2026年3月31日
- Toyota Research Institute, “A Careful Examination of Large Behavior Models for Multitask Dexterous Manipulation”, Science Robotics, 2026
- Toyota Research Institute / Boston Dynamics, “AI-Powered Robot by Boston Dynamics and Toyota Research Institute Takes a Key Step Towards General-Purpose Humanoids”, August 20, 2025
- NVIDIA Developer, “Develop Humanoid Robot Policies End-to-End with NVIDIA Isaac GR00T”, July 7, 2026
- NVIDIA, “NVIDIA Launches Cosmos 3, the Open Frontier Foundation Model for Physical AI”, May 31, 2026
- トヨタ自動車 未来創生センター, 「人と院内搬送ロボットPotaroの共存~ロボットの移動を支える認識技術~」, 2026年3月5日
- University of Washington / Toyota Research Institute, “Unified World Models: Coupling Video and Action Diffusion for Pretraining on Large Robotic Datasets”, RSS 2025
次に読むならこの3本
本記事の比較軸を補完するため、Physical AI全体、トヨタの現場実装、NVIDIAの開発基盤を深掘りする3本である。
補足Q&A
本文で拾い切れないトヨタとNVIDIAのPhysical AI比較上の疑問を、検索補助クエリに沿って整理したQ&Aである。
Q1.
トヨタのPhysical AIとNVIDIAのPhysical AIは何が違いますか?
A1.
トヨタ/TRIは現場・実機・身体設計を強い起点にし、NVIDIAは実世界の経験をSim・生成AI・基盤モデルで増幅する点に大きな違いがあります。
Q2.
トヨタはNVIDIAのIsaacやOmniverseを使っていますか?
A2.
はい。NVIDIAが2026年7月に公表した協業拡大では、トヨタがOmniverseライブラリとIsaac Simを工場・ロボティクスのワークフローやデジタルツイン環境に活用すると説明されています。
Q3.
ELEYはヒューマノイドロボットですか?
A3.
ELEYは人間に近い二本の腕を持ちますが、二足歩行型ではなく、全方向移動台車を備えたモバイルマニピュレーターです。
Q4.
TRIのLBMとNVIDIA Isaac GR00T N1.7の違いは何ですか?
A4.
TRIのLBMは多様なロボットデータから連続行動を学習し、GR00T N1.7はVLMとDiffusion Transformerを組み合わせ、多様な機体への展開を狙います。ただし両者の技術は接近しており、「Diffusion対VLM」という単純な比較は適切ではありません。
Q5.
Physical AIでは実機データとシミュレーションのどちらが重要ですか?
A5.
両方必要です。実機データを基準にし、Simで経験を増幅し、実機で誤差を測って再び学習へ戻す閉ループが重要です。
更新履歴
2026年9月時点で記事へ反映した主要な更新内容を記録した履歴である。
- 2026年9月18日:初版公開。トヨタ/TRIとNVIDIAのPhysical AI開発方式、2026年の協業拡大、主要研究・製品情報を反映。