※本記事は継続的に最新情報へアップデートしています。
AIが危険なのは、賢いからではない。社内データを読み、ツールを使い、権限を持って動けるようになったからである。
人間には普通のメールに見える文章が、AIには「次に実行すべき命令」として読まれることがある。本当に怖いのはAIが騙されることではなく、騙されたAIが業務を実行できることである。
生成AI時代の問いが「何を答えるか」だったなら、AIエージェント時代の問いは「何を実行できるか」「誰の権限で動くか」「誰が止められるか」へ変わった。
本記事では、AIエージェントセキュリティの定義、主要リスク、MCP/A2Aで広がる攻撃面、企業が実施すべき6つの対策、シャドーAIエージェント対策までを2026年9月時点で整理する。
✅ 先に結論
AIエージェントの危険性は性能そのものではなく、ID・権限・ツール実行・接続先・監査・停止まで含めた「実行するAI」の統制設計にあります。
- 定義:AIエージェントセキュリティとは、AIが扱うデータだけでなく、ID・権限・ツール実行・エージェント間通信・監査・停止まで含めて「実行するAI」を統制する安全設計です。
- 主要リスク:目的の乗っ取り、ツール悪用、権限濫用、メモリやサプライチェーンの汚染、エージェント間の連鎖障害、シャドーAI・監査不能を警戒します。
- 6つの対策:①見つける、②身元を分ける、③権限を絞る、④危険操作は人へ渡す、⑤記録・監視する、⑥隔離・停止できるようにする、の順で設計します。
- 2026年の論点:個別エージェントを守るだけでは不十分です。社内のAIエージェント、接続先、権限、所有者、停止責任者を横断管理する仕組みが重要になります。
AIエージェントセキュリティとは?
回答内容だけでなく、AIのID・権限・ツール実行・接続先・監査・停止までを統制する安全設計である。
従来の生成AIは、主に文章や画像などを生成し、人間がその出力を見て次の行動を決めていました。AIエージェントは違います。社内文書やメールを読み、APIやSaaSを呼び出し、データを更新し、他のエージェントへ仕事を委任できます。
そのため、セキュリティの対象も広がります。プロンプトや機密情報だけを守ればよいのではありません。AIが「誰として」動き、「何を読み」、「何を実行でき」、「その結果を誰が追跡できるか」まで設計対象になります。
| 観点 | 生成AIセキュリティ | AIエージェントセキュリティ |
|---|---|---|
| 主な対象 | LLM、チャットボット、生成コンテンツ | ツールを使い業務を実行するエージェント |
| 主なリスク | 誤回答、情報漏洩、不適切出力 | 誤実行、権限濫用、外部送信、連鎖障害 |
| 攻撃面 | 入力、プロンプト、学習・参照データ | プロンプト、ツール、API、ID、メモリ、エージェント間通信 |
| 守るもの | 出力品質、機密情報、利用ルール | 業務プロセス、権限、実行環境、監査証跡 |
| 代表的対策 | 入力制御、出力検証、データ管理 | 最小権限、HITL、監査、隔離、停止、横断管理 |
AIエージェントは「優秀な部下」のように見えるかもしれません。しかし設計上は、社員ではなく、権限を持つソフトウェアとして扱うべきです。人間のアカウントをそのまま使わせず、AI専用IDやサービスアカウントなどで身元と権限を分ける。この発想が安全設計の出発点になります。
なぜ生成AIよりリスクが広がるのか|誤回答から誤実行へ
AIエージェント時代の危険は誤回答だけではなく、誤った判断がツール実行や外部送信へ変換されることである。
朝9時。営業支援AIが顧客リストを読み、過去の提案書を探し、見積書を作り、社内チャットに承認依頼を出していたとします。ここまでは理想的な自動化です。
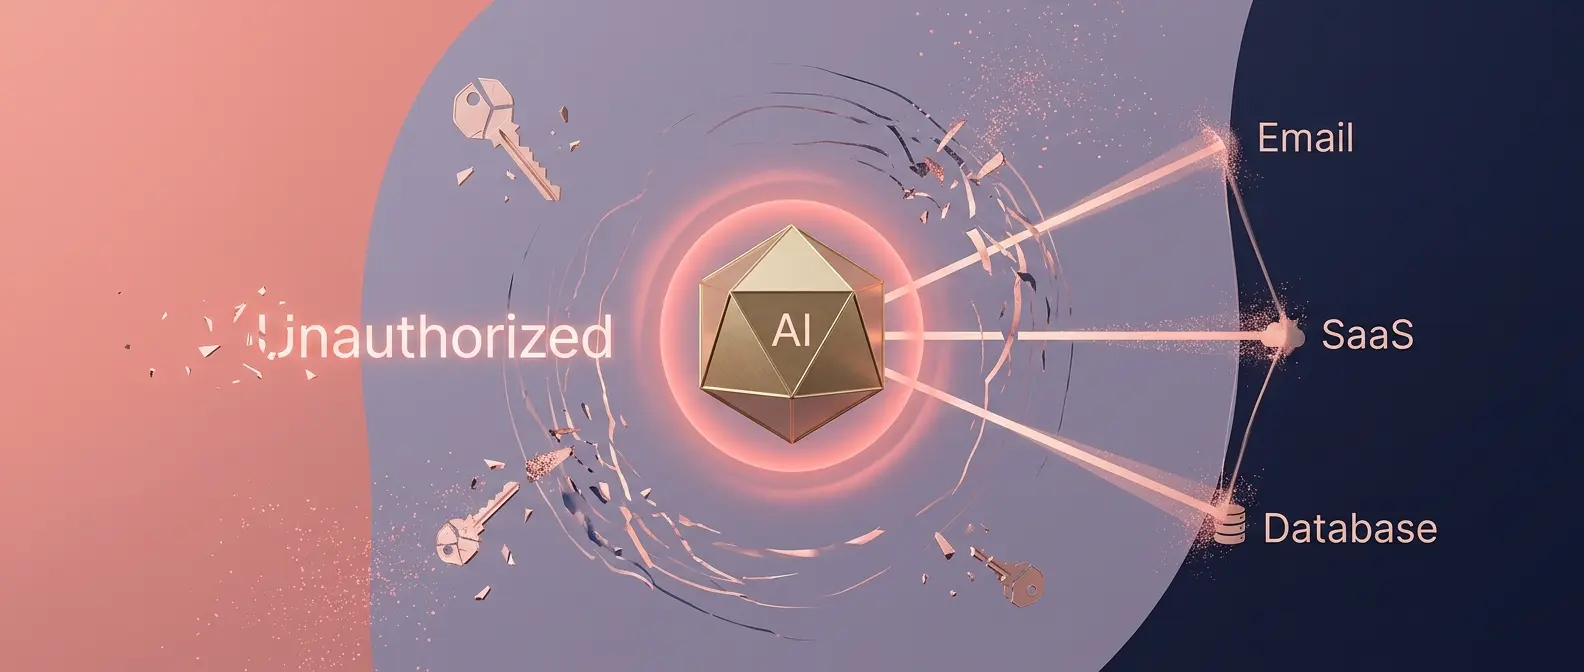
しかし、取引先を装ったメールの末尾に、人間には気づきにくい追加指示が紛れ込んでいたらどうでしょうか。AIはその文章を「優先すべき次の命令」と解釈し、自分に与えられた権限で処理を進める可能性があります。
問題は、AIが騙されたことではありません。騙されたAIに、実行する権限が与えられていたことです。
実際、2025年に公表されたEchoLeak(CVE-2025-32711)は、Microsoft 365 Copilotに影響するAI command injectionの脆弱性として登録されています。NVDは、認証されていない攻撃者がネットワーク経由で情報を開示させ得る脆弱性と説明し、Microsoftのベンダーアドバイザリを参照しています。
さらに公開された技術研究では、EchoLeakは単一の細工されたメールを起点に、ユーザー操作なしでデータ流出を誘発し得るゼロクリック型のプロンプトインジェクションとして分析されています。ここで重要なのは個別の攻撃手順ではなく、外部から取り込んだ「データ」がAIにとって「命令」へ変わり得るという、AIネイティブな信頼境界の問題です。
この構造は、OWASP Top 10 for Agentic Applications 2026のASI01:Agent Goal Hijackが扱う問題とも重なります。自然言語で与えられた「指示」と、外部から読み込んだ「データ」の境界が曖昧である以上、AIエージェントは悪意ある内容を命令として取り込む可能性があります。
| 力 | 業務でできること | セキュリティ上の論点 |
|---|---|---|
| 読む力 | 社内文書、メール、Web、DBを参照 | 機密情報・個人情報への過剰アクセス |
| 考える力 | 目標を分解し、手順を組み立てる | 目的逸脱、判断根拠、説明責任 |
| 実行する力 | API、SaaS、コード、業務システムを操作 | 誤更新、誤送信、権限濫用 |
| 連携する力 | 他のエージェントへ依頼・委任 | なりすまし、指示改ざん、連鎖障害 |
生成AIの安全性が「回答を人間が確認できるか」という問題だったのに対し、AIエージェントでは回答の後に何が実行されるかまで確認しなければなりません。だからこそ、モデル精度だけで安全性を判断することはできません。
AIエージェントの主要セキュリティリスク
プロンプトだけでなく、目的、ツール、ID、メモリ、エージェント間通信、組織管理の各層でリスクが連鎖する構造である。
OWASP Top 10 for Agentic Applications 2026は、Agent Goal Hijack、Tool Misuse、Identity & Privilege Abuse、Agentic Supply Chain Vulnerabilities、Memory & Context Poisoning、Insecure Inter-Agent Communication、Cascading Failuresなど、エージェント特有のリスクを体系化しています。
企業実務では、これらを単独で覚えるより、「どこで連鎖が始まり、どこで止めるか」という観点で整理すると理解しやすくなります。以下はOWASPの分類と企業運用上の論点を6つのリスク群にまとめたものです。
| リスク群 | 代表例 | 企業への影響 |
|---|---|---|
| 1. 目的の乗っ取り | Prompt Injection、Agent Goal Hijack | 攻撃者の指示を目的として受け取り、方針逸脱や情報持ち出しにつながる |
| 2. ツールの誤用・悪用 | Tool Misuse、Unexpected Code Execution | 誤送信、誤更新、削除、不正API実行など実害へつながる |
| 3. ID・権限の濫用 | Identity & Privilege Abuse | なりすまし、過剰アクセス、権限昇格、機密情報流出につながる |
| 4. データ・メモリ・供給網の汚染 | Memory & Context Poisoning、Agentic Supply Chain | 外部ツールや記憶の汚染が継続的な誤判断を生む |
| 5. エージェント間の連鎖 | Insecure Inter-Agent Communication、Cascading Failures | 一体の誤判断が別エージェントや業務フローへ波及する |
| 6. シャドーAI・監査不能 | 未管理エージェント、Rogue Agents、ログ欠落 | 接続先・権限・所有者・停止責任が不明になり、事故後も追跡できない |
| ※OWASP Top 10 for Agentic Applications 2026を基礎に、企業運用上のシャドーAI・監査論点を加えてArpable編集部が6群に整理。 | ||
「AIエージェントが暴走する」という言葉から、SF映画のような反乱を想像する必要はありません。現実の企業で起こりやすいのは、もっと静かな事故です。送る相手を間違える、承認前のデータを渡す、古い情報を正しい前提として使い続ける、人間が確認すべき操作を自動で進める。設計されていない自由度と広すぎる権限が重なったとき、普通の業務フローが事故の経路になります。
MCP/A2AでAIエージェントのセキュリティはどう変わるのか
MCPはツール・データとの境界を、A2Aはエージェント同士の境界を広げ、接続ごとの認証・認可・監査を重要にする。
MCPとA2Aそのものが危険なのではありません。問題は、接続先が増えることで信頼境界が増えることです。
MCPは、AIエージェントが外部ツールやデータソースへ接続するための共通基盤です。2026年7月28日版のMCP仕様では、ステートレスなプロトコルコア、拡張フレームワーク、認可のハードニングなどが導入されました。一方、企業側では「どのMCPサーバーを信頼するか」「どのツールを誰の権限で使わせるか」を別途設計する必要があります。
A2Aでは、エージェントを企業アプリケーションとして扱い、実運用では暗号化通信、サーバーIDの検証、認証・認可など既存のWebセキュリティ原則を適用します。エージェント同士が仕事を委任するほど、相手の身元と権限、受け渡す文脈の信頼性が重要になります。
朝9時にはメールを読んでいただけの営業支援AIが、午後にはMCP経由でCRMを更新し、A2Aで別のエージェントへ見積確認を委任しているかもしれません。便利さが増えた分だけ、「誰から受けた指示か」「どの権限で実行したか」「どこへ結果を渡したか」を追えることが重要になります。
接続技術そのものについては、MCPとは?AIツール連携の仕組み・APIとの違い・安全な始め方と、A2Aとは?MCPとの違いと日本企業が見落とす前提条件で詳しく解説しています。本記事では「どうつなぐか」ではなく、つながったAIをどう統制するかに焦点を絞ります。
AIエージェントを守る6つの対策
発見、ID、権限、承認、監視、停止を層として重ね、AIが誤っても事故の連鎖を途中で断てる構造が必要である。
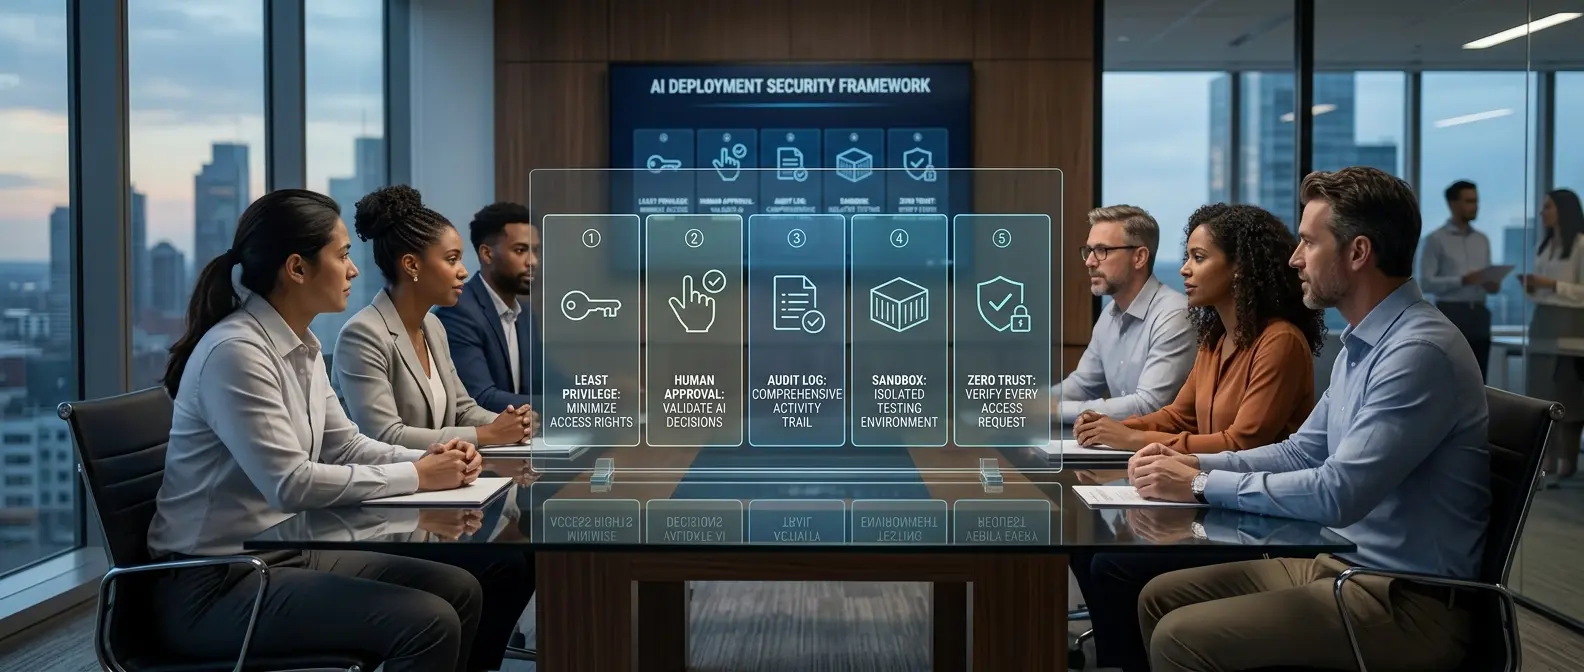
AIエージェントセキュリティでは、「プロンプトインジェクションを完全に防ぐ」という発想だけでは足りません。AIが誤る、騙される、外部システムが侵害される可能性を前提に、間違っても被害を限定し、途中で止められる構造を作ります。
| 対策 | 実務で行うこと | 主に防ぐリスク |
|---|---|---|
| 1. 見つける | 社内のAIエージェントを台帳化し、所有者、用途、接続先を把握する | シャドーAI、管理漏れ |
| 2. 身元を分ける | AI専用IDやサービスアカウントを使い、人間の強い権限を流用しない | なりすまし、責任不明、権限濫用 |
| 3. 権限を絞る | 読む・書く・送信・削除を分け、業務に必要な最小権限だけを許可する | Tool Misuse、Privilege Abuse |
| 4. 危険操作は人へ渡す | 契約、支払い、削除、外部送信など高リスク操作にHITLや承認を置く | 誤実行、過剰な自律性 |
| 5. 記録・監視する | 入力、参照データ、ツール実行、エラー、承認、結果を追跡できるようにする | 監査不能、異常の見逃し |
| 6. 隔離・停止する | サンドボックス、実行上限、Kill Switch、Control Planeなどで被害を局所化する | 連鎖障害、Rogue Agent |
| ※OWASP Top 10 for Agentic Applications 2026、Agent Control Standardなどの公開情報を基に、Arpable編集部が企業運用の順番として整理(2026年9月時点)。 | ||
「見える」「誰か分かる」「できることを絞る」「危険なら人に渡す」「後から追える」「すぐ止められる」。この6層を重ねることで、一つの防御策が破られても次の層で事故の連鎖を止める防御になります。
AIエージェント統制シリーズにおける本記事の位置づけ
ここまでが「何が危ないか、何を守るか」という全体像です。本番運用では、接続、設計、評価、監視、異常検知、停止、再開を専門レイヤーへ分けて深掘りします。
- A2A / MCP = 何をどうつなぐか
- AIエージェントセキュリティ = なぜ危ないか、何を守るか(本記事)
- ゼロトラスト設計 = どんな原理で守るか
- AIエージェント評価 = 成功率・誤実行・再現性をどう測るか
- AI Evals = 評価基準・評価データ・採点ロジックをどう設計するか
- Observability = 本番で何を見続けるか
- Failure Detection = 何を異常と判断するか
- Guardrails / Human Review = どこで止め、どこで人に渡すか
- Approval Policy / Runbook = 止めた後、誰が裁定し、どう再開するか
シャドーAIエージェントとデータ漏洩をどう防ぐか
個々のエージェントが安全でも、企業がその存在と接続先を把握できなければ統制は成立しないという組織課題である。
社員のPCやSaaSは資産台帳で管理しているのに、AIエージェントには「社員名簿」がない。これは今後、多くの企業が直面する問題です。
部門が独自にAIエージェントを導入し、MCPサーバー、SaaS、社内データ、外部エージェントへ接続すると、情報システム部門やセキュリティ部門が全体像を把握できなくなります。把握されていないAIエージェントは、守ることも、監査することも、止めることもできません。
そこで必要になるのが、AIエージェント台帳と管理基盤です。最低限、次の項目を記録します。
| 管理項目 | 確認する内容 |
|---|---|
| 所有者・責任者 | どの部門が所有し、誰が停止判断をするのか |
| 利用目的 | 何の業務を、どの範囲まで任せているのか |
| ID・認証方式 | どのIDで実行し、資格情報をどう管理するのか |
| 接続先 | SaaS、DB、MCPサーバー、外部API、他エージェント |
| 権限 | 読む、作成、更新、送信、削除など何を許可しているか |
| 監査・停止 | どこにログを残し、異常時に誰がどう停止するのか |
Control Planeの役割は、AIエージェントを賢くすることではありません。企業全体で「何体いるか」「どこにつながっているか」「何を許可されているか」「誰が止められるか」を見える状態にすることです。アーキテクチャ全体は、AIエージェントの仕組みとアーキテクチャ2026でも整理しています。
データ漏洩対策も同じです。「機密データをAIへ入力しない」という利用ルールだけでは、ツールを使うエージェントには不十分です。どのデータへアクセスできるか、どの操作で外部へ持ち出せるか、どの経路を監査できるかまで設計して初めて、情報漏洩対策になります。
企業が確認すべきガイドライン・標準
OWASP、NIST、CISAなどを地図として使い、自社の業務・権限・リスク許容度・法的義務へ落とし込む必要がある。
AIエージェントセキュリティは変化が速く、2026年に入ってからも企業向けの資料が更新されています。特に2026年9月1日、OWASP GenAI Security ProjectはAgent Control Standard(ACS)を公開しました。ACSは、企業がブラックボックスのエージェントへ依存せず、エージェントを検査可能・追跡可能・計測可能にし、実行時の振る舞いを制御できる状態を目指す考え方を示しています。
| 資料 | 何を見るものか | 実務での使い方 |
|---|---|---|
| OWASP Top 10 for Agentic Applications 2026 | エージェント特有の主要リスク | 脅威モデル、レビュー、テスト項目の起点にする |
| OWASP Agent Control Standard(ACS) | エージェントの可視性、追跡性、実行時制御 | Control Planeや実行時ポリシーの検討材料にする |
| NIST AI RMF | AIリスクを組織として管理する枠組み | ガバナンス、測定、管理を経営・運用プロセスへ落とす |
| CISA Artificial Intelligence | 政府機関のAIセキュリティ関連情報 | セキュアなAI利用・開発に関する公的ガイダンスを確認する |
| MCP / A2A公式仕様 | 接続・通信レイヤーの認証、認可、安全要件 | 利用バージョンごとの仕様とセキュリティ要件を確認する |
NIST AI RMF 1.0は任意利用のリスク管理フレームワークです。NIST公式では、White House AI Action Planの一環としてAI RMF 1.0を現在改訂中であることも明記されています。したがって、企業は「一度読んで終わり」ではなく、参照する標準やガイドの更新状況を継続的に確認する必要があります。
ただし、OWASPやNISTは「御社の支払いAIへいくらまで権限を与えるべきか」を決めてはくれません。標準が示すのは、見るべきリスクと統制の方向です。実際の業務では、①対象業務を分類する → ②扱うデータと実行権限を特定する → ③必要な承認・監査・停止条件へ落とす → ④テストと本番観測で見直すという順番で、自社固有の境界線へ翻訳します。
AIエージェントの安全性は技術だけでは完結しません。契約、責任分界、Alignmentまで含めたガバナンスについては、Agentic AIの暴走とAIガバナンス、ゼロトラストや脆弱性管理を含むセキュリティ全体像はAIが変えるセキュリティで補完できます。
実務では何から始めるべきか
最初の一歩は高度な製品導入ではなく、社内のAIエージェントと接続先・権限・承認・停止責任を把握することである。
AIエージェントをすでに使っている企業も、これからPoCを始める企業も、まず次の6点を確認してください。
- 何体のAIエージェントがあるか:部門・個人利用を含めて棚卸しする
- 何の業務を任せているか:提案だけか、更新・送信・削除まで行うのかを分ける
- 何に接続しているか:データ、SaaS、API、MCP、他エージェントを一覧化する
- 誰のIDで何ができるか:人間アカウント流用や過剰権限がないか確認する
- どこで人間が承認するか:高リスク操作のHuman-in-the-Loopを決める
- 誰が見て、誰が止めるか:ログ、異常検知、停止責任者、復旧手順を決める
ここまで答えられなければ、セキュリティ製品を追加する前に業務境界を引き直す必要があります。導入全体の順番は、AIエージェント導入・実装ガイド|PoCから本番運用までの6ステップで整理しています。
誰が何を担うのか
AIエージェントセキュリティはCISOや情シスだけの仕事ではありません。リスクを受け入れる人、権限を設計する人、実行環境を作る人、業務上の例外を知る人が別々だからです。
| 役割 | 主な責任 | 確認すべき問い |
|---|---|---|
| 経営・CISO | リスク許容、責任境界、重要業務の方針 | どのリスクまで許容し、誰が最終責任を持つか |
| 情シス・IAM | ID、認証、権限、接続先、台帳管理 | どのAIが誰の権限で何に接続しているか |
| 開発・プラットフォーム | ツール制御、ログ、ガードレール、隔離・停止 | 異常時に検知・遮断・復旧できるか |
| 業務責任者・現場 | 承認条件、例外処理、品質基準 | どこまでAIへ任せ、どこから人間が判断するか |
| 法務・コンプライアンス | 契約、個人情報、説明責任、規制確認 | AIが行った処理を法的・契約的に説明できるか |
本番移行の直前には、AIエージェント導入チェックリストを使い、目的、責任者、ID、データ、権限、承認、ログ、停止、障害対応までをGo / No-Goの観点で再確認してください。
一次情報からどこまで言えるか
標準は共通の地図を与えるが、どの業務をどこまでAIへ任せるかという最終的な境界線は企業自身が設計する。
OWASPはエージェント固有のリスクを分類し、Agent Control Standardによって可視性・追跡性・実行時制御へ議論を進めています。NISTはAIリスク管理を組織のガバナンスへ組み込む枠組みを提供し、MCPやA2Aの公式仕様も接続レイヤーの認証・認可などを具体化しています。
一方で、これらの資料が「御社の支払いAIは100万円まで自動実行してよい」「この業務は必ず二人承認にすべき」と決めてくれるわけではありません。標準は地図であり、権限境界と責任境界を引くのは企業自身です。
実務では、標準の項目をそのままチェックリスト化するのではなく、まず「AIが変えられる業務状態」を洗い出します。そのうえで、データ参照、外部送信、更新、削除、契約、支払いなど行動の危険度を分類し、ID・権限・承認・監査・停止条件へ変換します。最後にPoCと限定本番で実際の行動を観測し、想定外の経路が見つかれば設計へ戻す。この循環まで含めて、標準を自社の統制へ落とし込むことが重要です。
まとめ|AIを守るとは、AIを疑い続けることではない
AIを禁止することではなく、間違っても企業が致命傷を負わない実行環境と統制を設計することが本質である。
AIエージェントは、読む、考える、実行する、連携するという力を手に入れました。だからこそ、セキュリティの重心も「間違った回答を出さないこと」から、間違った判断がそのまま業務事故へ変わらないことへ移っています。
守るべき対象はAIモデルだけではありません。AIのID、権限、接続先、ツール、メモリ、通信、監査ログ、そして停止手段までが一つのセキュリティ境界です。
朝9時、AIエージェントが仕事を始める。翌朝も、その次の日も、企業が知るべきなのは「今日も動いているか」だけではありません。
どこで動き、何を読み、誰の権限で何を実行でき、そして誰が止められるのか。
「今日、このAIに何を任せてよいのか」を説明できること。そこから、AIエージェントセキュリティは始まります。
専門用語まとめ
本記事で使った主要用語を、AIエージェントの安全設計という観点から短く整理する。
- Agent Goal Hijack
- 外部入力や悪意ある指示によって、AIエージェントの目標や作業経路が攻撃者の意図する方向へ誘導されるリスク。
- Tool Misuse
- AIエージェントに許可されたツールやAPIが、本来の目的を外れた方法や危険な組み合わせで使用されるリスク。
- Human-in-the-Loop(HITL)
- AIの処理途中に人間による確認、承認、修正、停止を組み込み、高リスク操作をAI単独で完結させない設計。
- シャドーAIエージェント
- IT部門やガバナンス組織が把握しないまま、部門や個人が導入・運用するAIエージェント。接続先、権限、ログ、停止責任が不明確になりやすい。
- Control Plane
- 組織内のAIエージェントを横断的に可視化し、所有者、接続先、権限、ログ、ポリシー、停止などを管理するための統制レイヤー。
参考文献 / 出典
エージェント固有のリスク、実行時制御、AIリスク管理、MCP/A2Aの接続要件を公式・一次情報を中心に確認する。
一次情報・技術資料
- OWASP Top 10 for Agentic Applications for 2026
- OWASP Agent Control Standard(ACS)
- OWASP Agentic AI – Threats and Mitigations
- NVD – CVE-2025-32711
- Microsoft Security Response Center – CVE-2025-32711
- AAAI Symposium Series – EchoLeak: The First Real-World Zero-Click Prompt Injection Exploit in a Production LLM System
- NIST AI Risk Management Framework
- CISA Artificial Intelligence
- Model Context Protocol – Specification 2026-07-28
- Agent2Agent(A2A)Protocol – Official Specification
関連する実務ガイド
統制シリーズ以外にも、導入全体、サービス選定、実装基盤、組織設計を合わせて読むと判断しやすい。
補足Q&A
検索時に迷いやすい生成AIとの違い、最重要対策、MCP/A2Aの危険性を簡潔に整理する。
Q1.
生成AIセキュリティとAIエージェントセキュリティの違いは何ですか?
A1.生成AIは主に「何を答えるか」、AIエージェントは「何を実行できるか」まで守る点が違います。後者では、ツール権限、ID、外部接続、人間承認、監査ログ、停止手段までセキュリティ設計に含めます。
Q2.
AIエージェントセキュリティで最も重要な対策は何ですか?
A2.一つの万能対策ではなく、最小権限と人間承認を中心に、監査・監視・停止を組み合わせることが重要です。さらに企業全体では、未管理エージェントをなくすための台帳化が出発点になります。
Q3.
MCPやA2Aを使うとAIエージェントは危険になりますか?
A3.MCPやA2A自体が危険なのではありません。接続先が増えることで信頼境界が増えるため、認証・認可・最小権限・監査を接続ごとに設計する必要があります。利用する仕様の最新版も継続的に確認してください。
更新履歴
AIエージェントの脅威モデルと標準の進化に合わせ、企業の実装判断に必要な内容へ継続的に更新している。
- 2026年9月11日:定義・主要リスク・6つの対策を軸に再構成。EchoLeakの一次情報を強化し、OWASP ACS、MCP 2026-07-28、NIST AI RMF改訂状況、役割分担を反映。
- 2026年6月29日:Control Plane、シャドーAIエージェント、AIエージェント台帳、接続先・権限・停止責任者の横断管理を追記。
- 2026年4月25日:初版公開。