※本記事は継続的に最新情報へアップデートしています。
AIエージェントは、正しい答えを返した。それでも、そのAIを本番で信頼してよいとは限らない。
裏では不要なツールを何度も呼び、本来必要のないデータへアクセスし、想定とは異なる経路を通っていることがある。最終回答だけが正しくても、途中で何が起きたのか調べられなければ、企業は重要な仕事をAIへ任せ続けることができない。
Observabilityが見るのは、AIの「答え」だけではなく「仕事の仕方」である。 本記事では、経営・技術・統制の3つの視点から、本番で何を見るべきかを整理する。
✅ 先に結論
AIエージェントObservabilityの目的は、AIを監視することではありません。「このAIに仕事を任せ続けてよいか」を判断できる状態をつくることです。
- 見る対象:Trace、Tool call、Latency、Cost、State transition、挙動変化。
- 見る人:経営・技術・統制では、必要な粒度と判断が異なる。
- 次につなぐ:観測した事実をEvals、Failure Detection、Guardrails、Human Review、Runbookへ渡し、改善ループを閉じる。
AIエージェントObservabilityとは?監視との違い
AIエージェントObservabilityとは、実行経路や外部操作を追跡し、異常や変化の原因を調査・切り分けられる状態である。
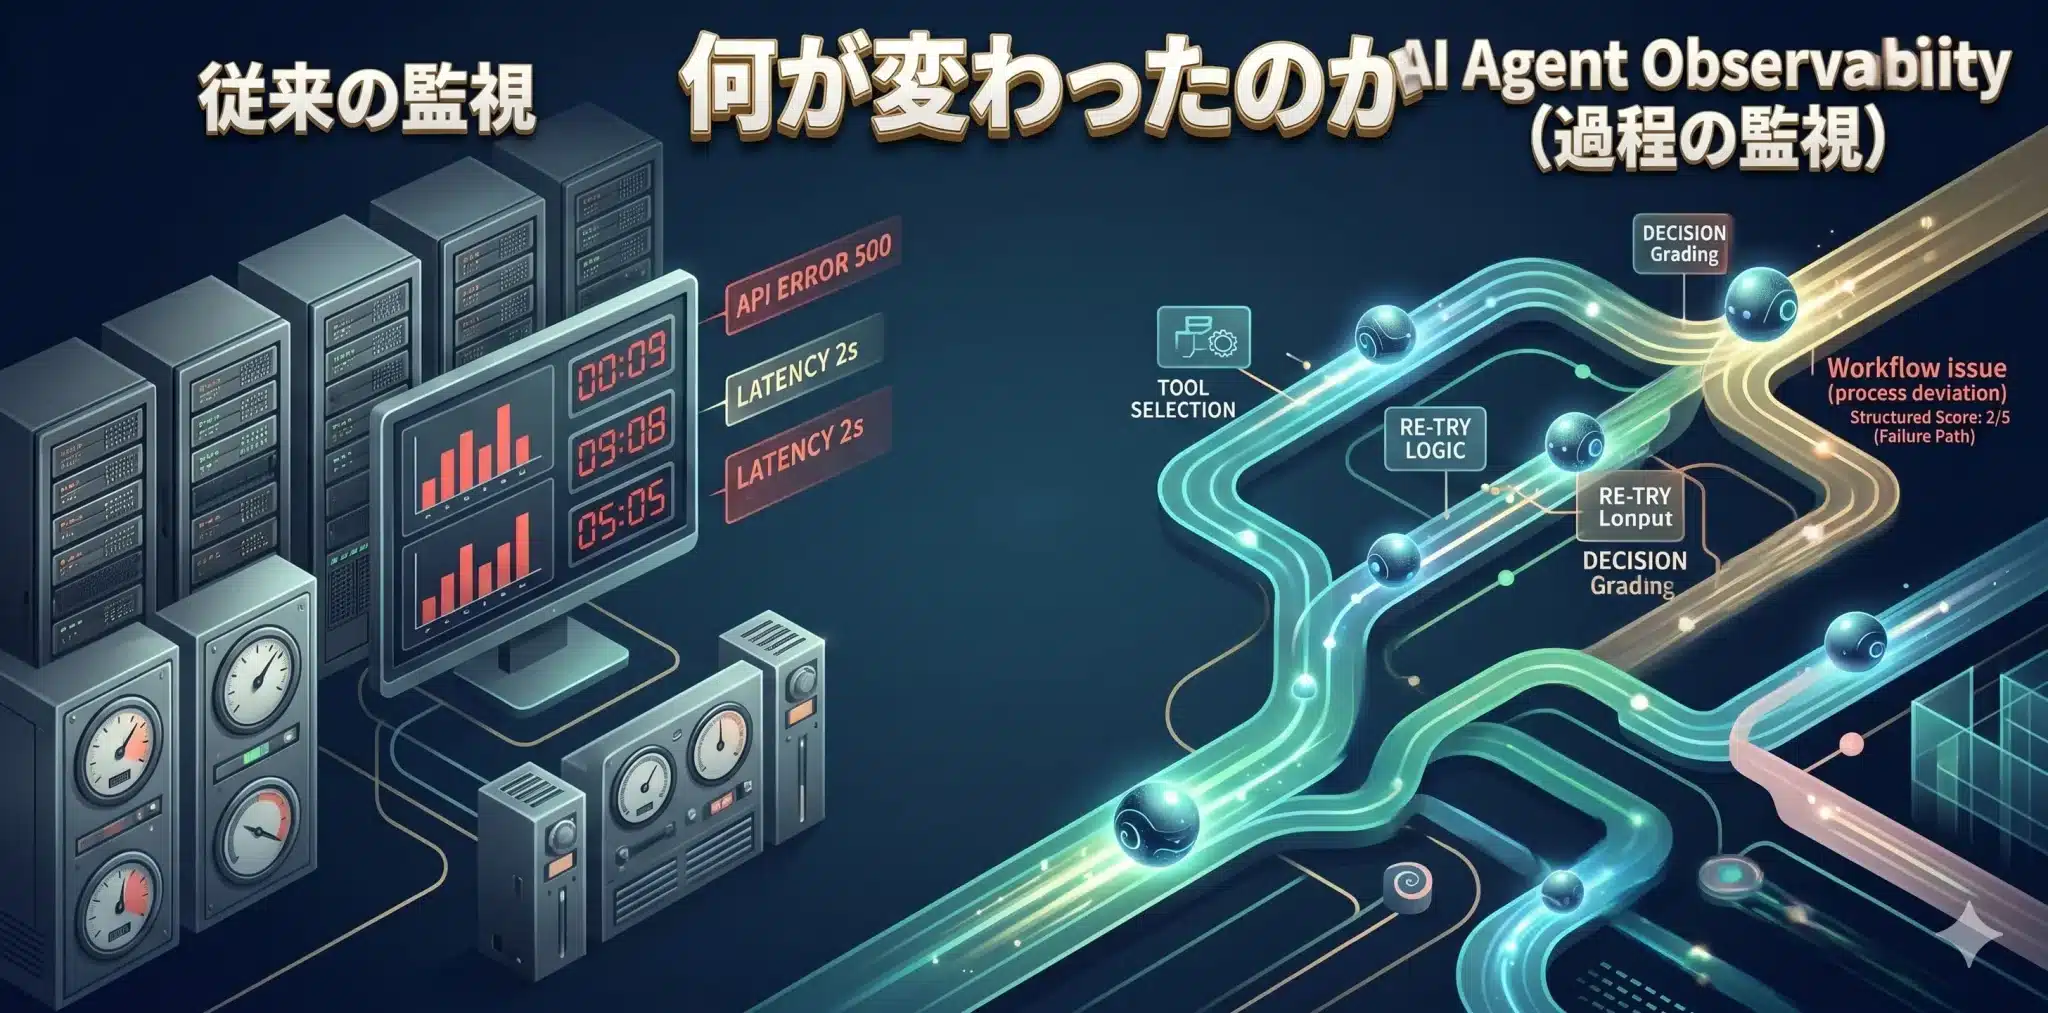
Observability(オブザーバビリティ)は一般に「可観測性」と訳されます。ここで重要なのは言葉ではなく、問題が起きたときに何が起き、どの経路を通り、どこから挙動が変わったのかを調べられることです。
従来のMonitoringは、CPU使用率、エラー率、応答時間、サービス停止など、あらかじめ定めた指標やしきい値から異常を検知することを得意としてきました。AIエージェントでも、こうした監視は引き続き不可欠です。
そのうえでAIエージェントでは、システム自体は正常でも「仕事の進め方」がおかしくなることがあります。APIは正常で、最終回答も一見正しい。それでも、不要な検索を繰り返し、想定外のToolを選び、承認前に次の処理へ進んでいることがあります。
「システムは正常だが、AIの仕事の仕方がおかしい」。この状態を調べるために、MetricやLogに加えてTrace、Tool call、状態遷移などを結び付けて見ます。
ログとTraceは何が違うのか
ログが個々の出来事を記録した「点」だとすれば、Traceは、それらをつないだ一連の実行経路です。どのモデルを呼び、何を検索し、どのToolを実行し、どこでRetryし、どの状態へ進んだのか。AIが仕事を終えるまでの足跡です。
OpenAIのTrace Gradingは、こうした実行履歴へスコアやラベルを付け、Workflowレベルの問題を見つける考え方を示しています。重要なのは、モデルの内部推論そのものを常に読めるという意味ではありません。取得範囲はモデルや基盤の仕様に左右されるため、企業は実行された処理、Tool call、中間出力、状態遷移、外部操作といった観測可能な事実を中心に追うべきです。
なぜAIエージェントは本番に出ると「見えなくなる」のか
非決定的な出力、外部Tool、データ、状態変化が連鎖するため、AIエージェントは最終回答だけでは成功も失敗も判断できない。
営業部門のAIエージェントに、「優良顧客を抽出し、次回提案の候補をまとめてほしい」と依頼したとします。数分後、AIは妥当な候補一覧を返しました。ここだけを見れば「成功」です。
しかしTraceを開くと、本来1回で済む検索を何度も繰り返し、不要な顧客属性まで参照し、同じAPIを再実行していた。さらに「候補を作る」という依頼を越えてCRM更新へ進もうとしていた。こうした事実は、最終回答を読むだけでは分かりません。
AIエージェントは検索だけでなく、CRM更新、メール送信、チケット変更、社内DBへの書き込みまで実行できます。AIが何を「言ったか」以上に、何を「したか」が企業リスクになる場面が増えています。
| 観点 | Monitoring | Observability |
|---|---|---|
| 主な問い | 決めた指標は正常か | なぜこの挙動になったのか調査できるか |
| 代表情報 | Metric、Log、Error | Trace、Tool call、State、Cost |
| 役割 | 異常検知・安定運用 | 実行経路の調査・原因切り分け |
| ※ObservabilityはMonitoringを置き換えるのではなく、AI固有の実行情報を加えて調査可能性を広げる。 | ||
AIエージェントが企業システムへ接続されるほど、この問題は重要になります。接続についてはA2AとMCPの違い、導入全体についてはAIエージェント導入・実装ガイドで整理しています。
経営にとってObservabilityとは「予見可能性」である
経営に必要なのはAIを完全に予測することではなく、予想外を早く捉え、その時点の最善手へ戻れる予見可能性である。
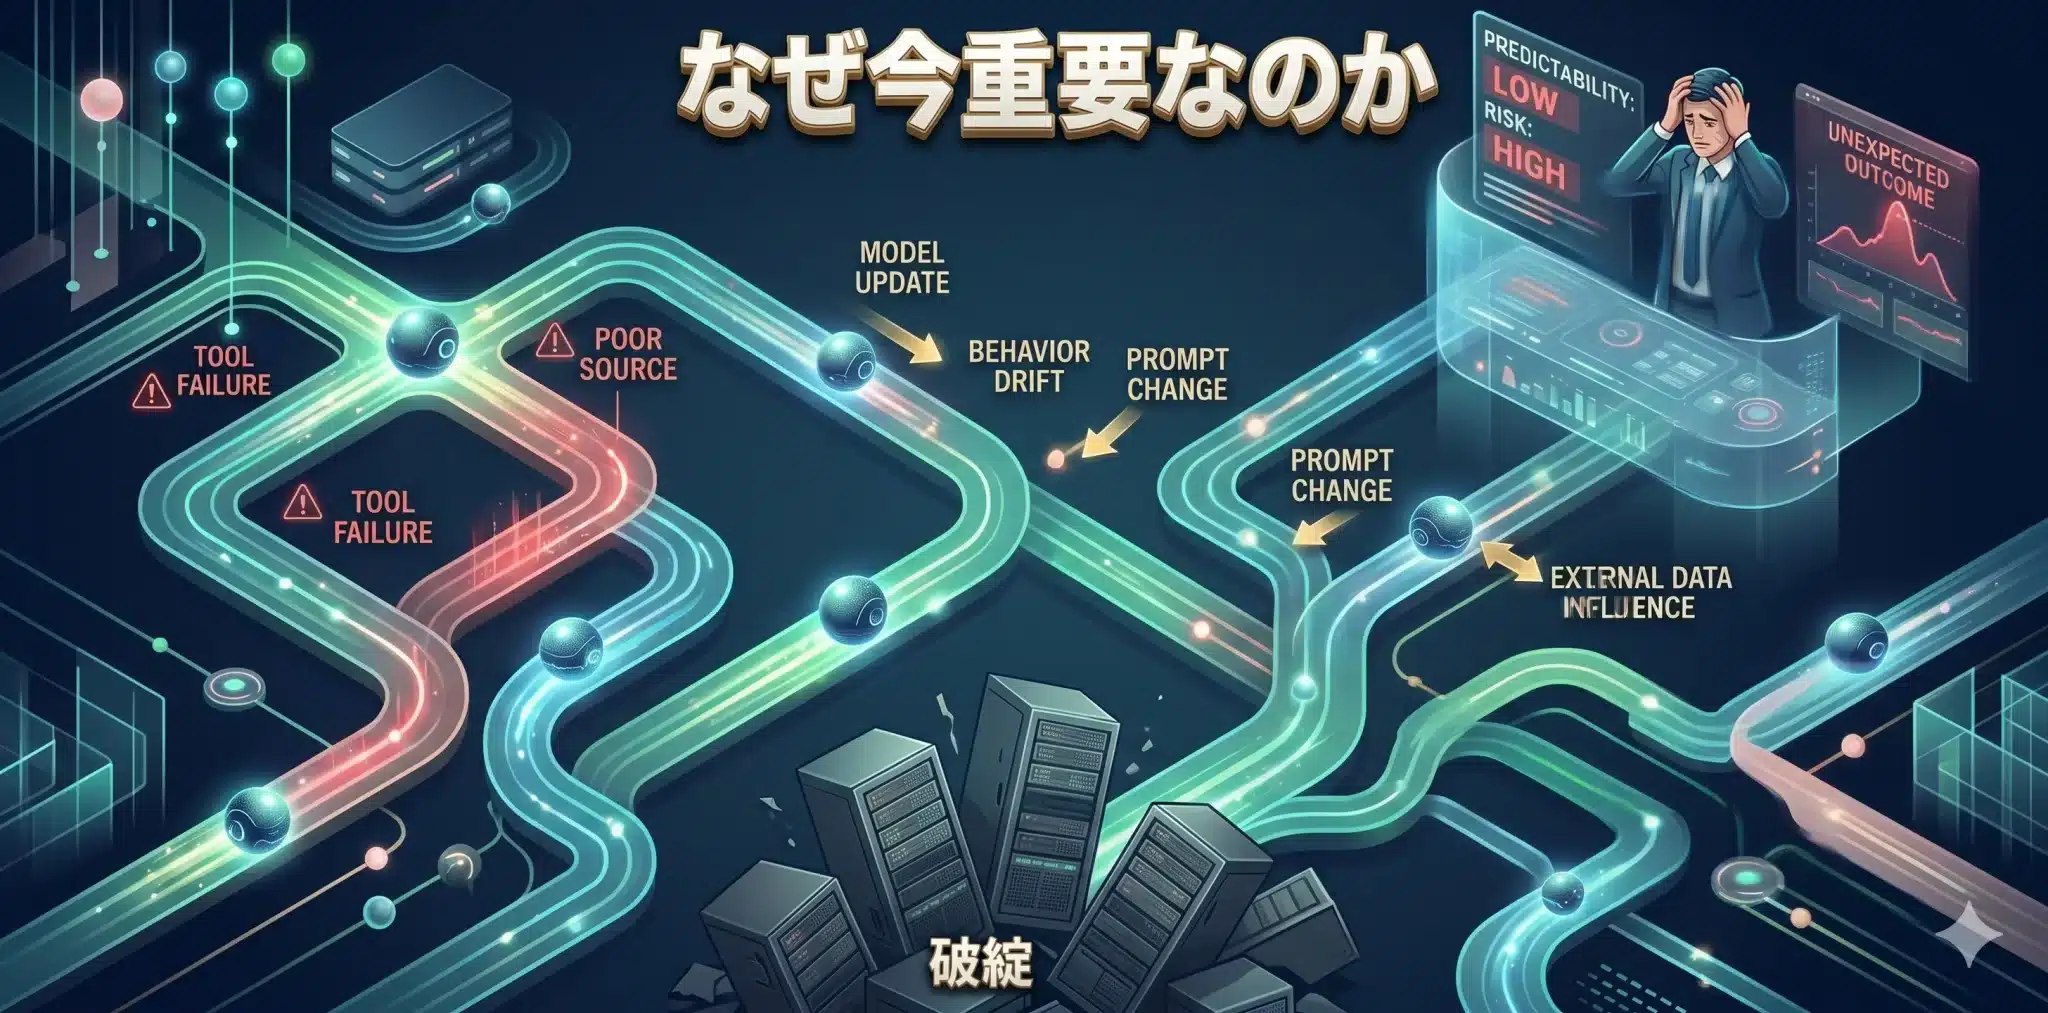
私は長年、国内外のプロジェクトを管理する中で、成功を左右する重要な要素の一つは予見可能性だと考えてきました。これは未来をすべて当てることではありません。予想外を早く捉え、原因を切り分け、その時点で最善の判断へ移れることです。
AIエージェントも同じです。同じ入力でも挙動が揺れる可能性があり、モデルだけでなくPrompt、外部データ、Tool、Workflowの変更でも仕事の進め方が変わります。だから必要なのは、すべてを事前に読み切ることではありません。
気づく → 原因を追う → 判断する → 改善する。
Observabilityは、このループの入口です。何が起きているのか分からなければ、異常検知も停止判断も再評価も始まりません。
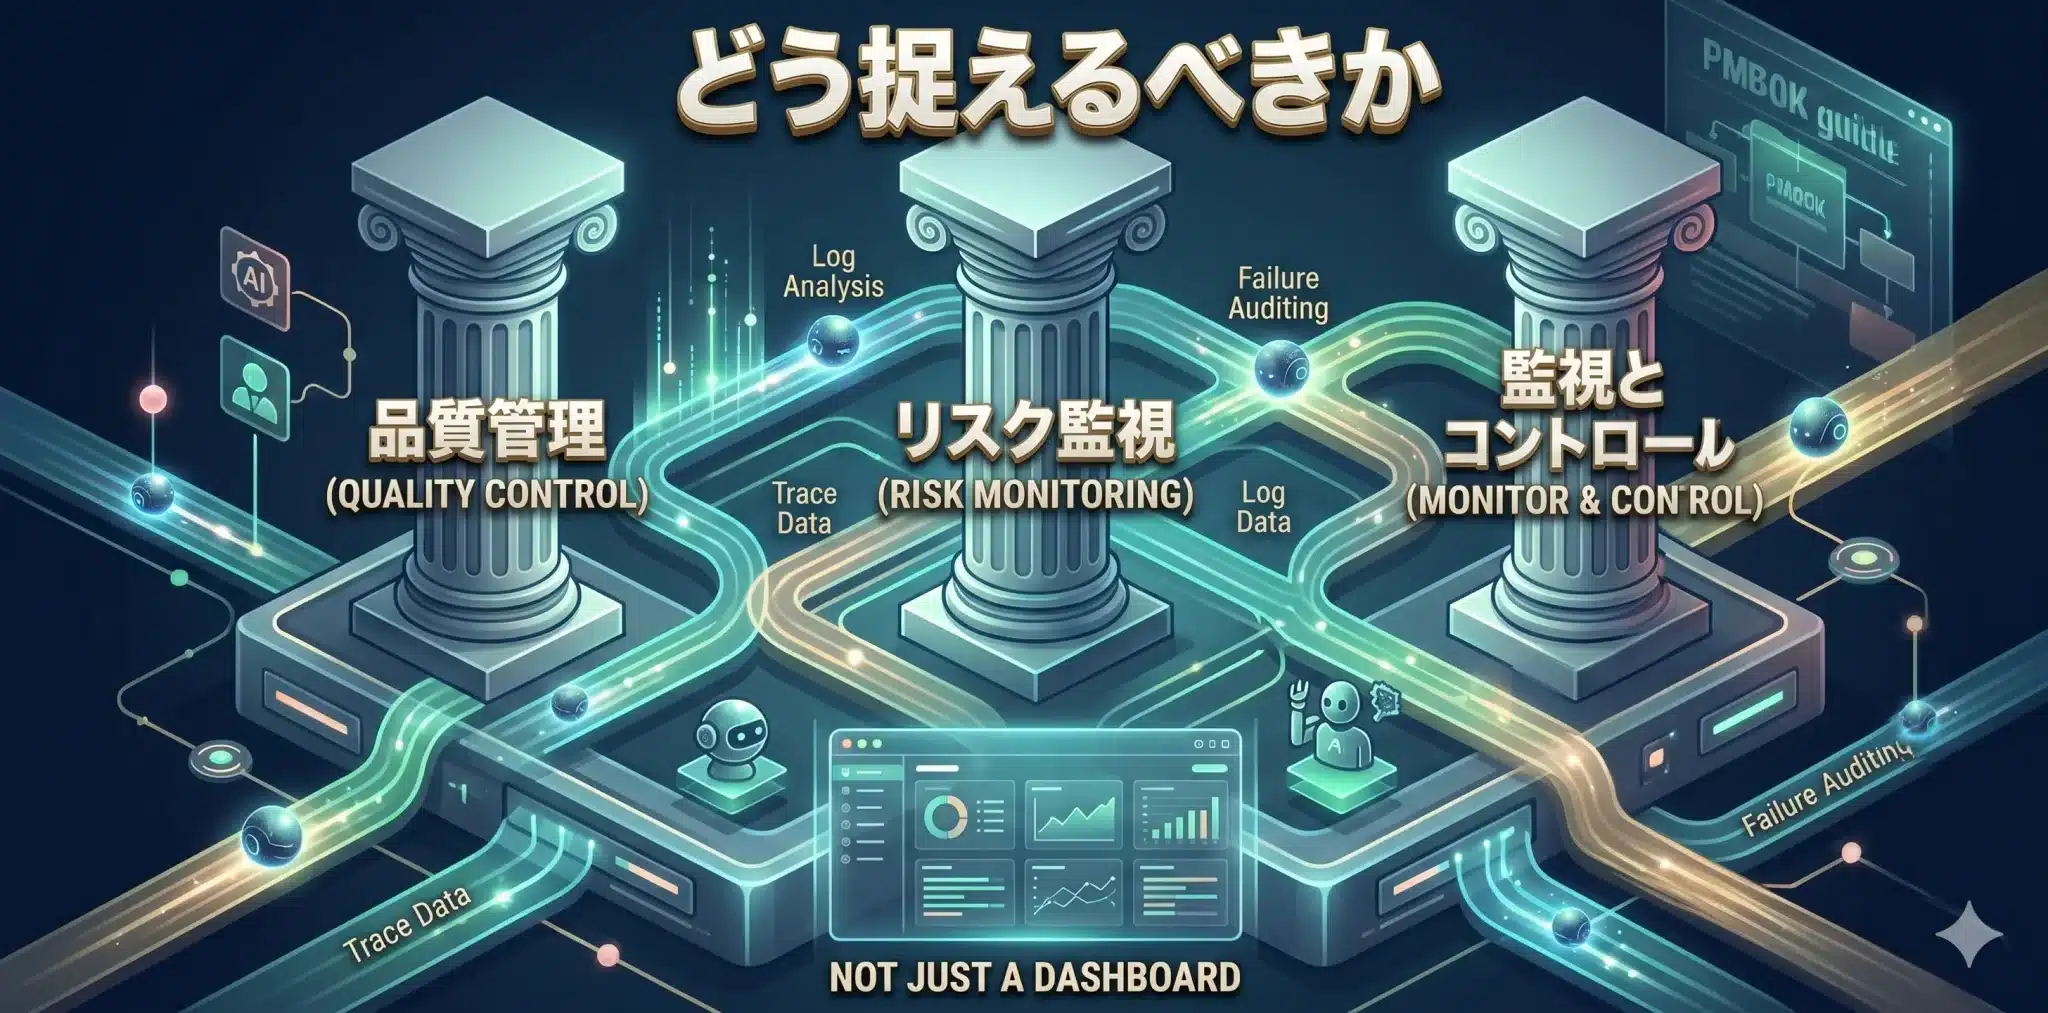
Observabilityはエンジニアだけの話でもありません。業務成功率、人間介入率、1業務あたりのコスト、重大な誤実行、変更後の品質。これらは技術指標であると同時に、「このAIへどこまで仕事を任せるか」を決める経営上の判断材料です。
AIエージェントで本番時に見るべき6項目
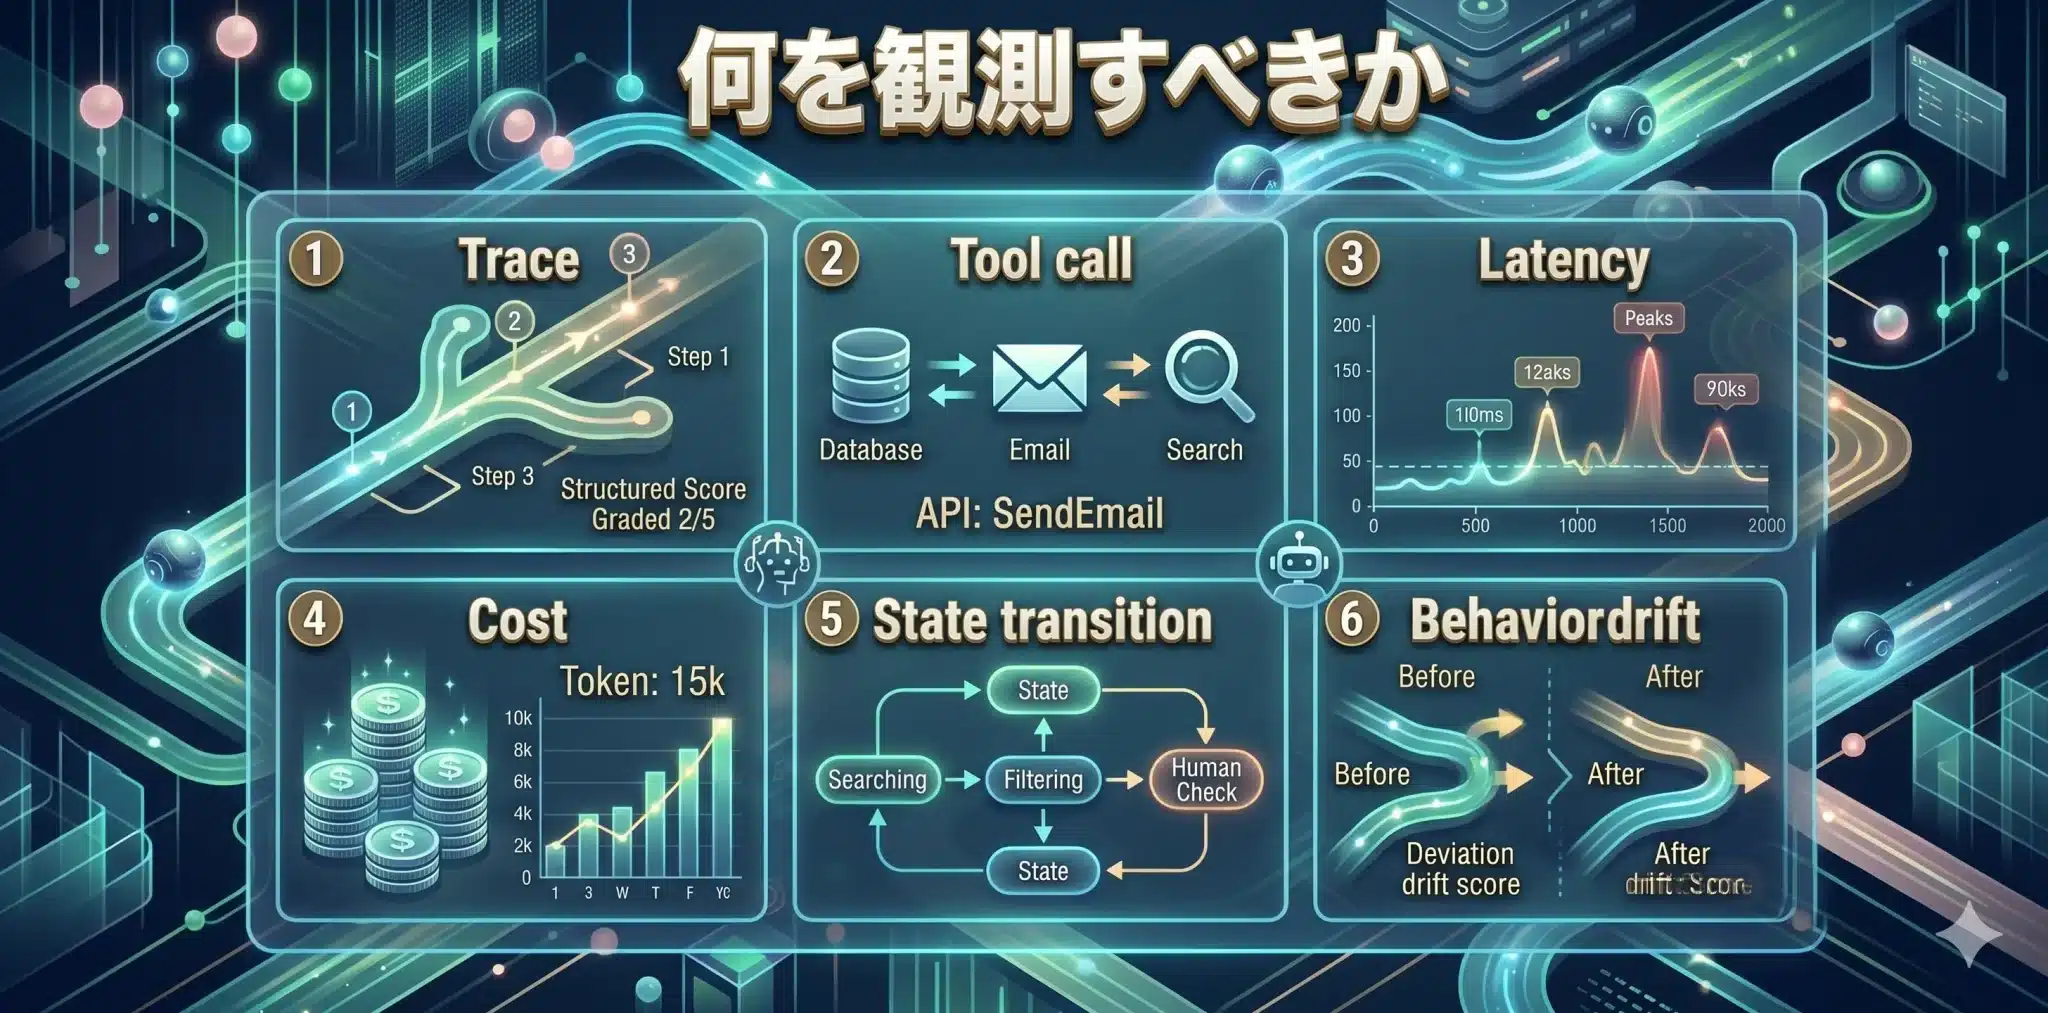
本番ではTrace、Tool call、Latency、Cost、State transition、挙動変化の6項目を組み合わせて見ることが重要である。
TraceとTool call ― 何をしたのか
Traceはタスク開始から終了までの実行経路、Tool callは検索、DB参照、メール送信、CRM更新などの外部操作です。先ほどの営業AIなら、「候補一覧は正しいが、検索を繰り返し、CRM更新へ進もうとした」という事実をここで捉えます。
「AIは何を言ったか」だけでなく、「AIは何をしたか」を見る。これがエージェント時代の基本です。
LatencyとCost ― 効率よく仕事を終えたのか
Latencyは業務完了までの時間、Costはモデル、トークン、検索、Tool、Retryなどにかかった費用です。経営視点では「LLMを1回呼ぶといくらか」より、1業務を完了するまでに総額いくらかかったかを見る方が実態に近くなります。
結果が正しくても、RetryとTool callが増え続けているなら、AIの仕事ぶりは改善しているとは言えません。
State transitionと挙動変化 ― 正しい進め方をしているか
State transitionは、「検索中 → 候補作成 → 人間確認待ち → 更新実行」のような状態の移り変わりです。本来必要な「人間確認待ち」を飛ばして更新へ進んでいれば、回答が正しくても統制上は問題です。
また本記事ではBehavior driftを、「似た条件でも以前と異なる仕事の進め方が増えていく状態」と呼びます。これは公的な単一標準用語ではなく、挙動変化を捉えるための実務上の表現です。モデル変更やPrompt改修後に、Tool数、Retry、実行経路、処理時間が変化していないかを見ます。
| 項目 | 何を見るか | 判断すること |
|---|---|---|
| Trace | 実行経路 | どこから問題が始まったか |
| Tool call | 外部操作 | Tool選択・権限は適切か |
| Latency | 処理時間 | 業務利用に耐えられるか |
| Cost | 業務完了までの費用 | 業務価値に見合うか |
| State transition | 状態の移動 | 正しいWorkflowを通ったか |
| Behavior drift | 過去との挙動差 | 仕事ぶりが変化していないか |
経営・技術・統制では「見るべきもの」が違う
同じObservabilityでも、経営者、トップエンジニア、統括責任者では、見る情報と下す判断が異なる。
もし今、AI運用ダッシュボードを役員会に映したら、「それで、今日は何を判断すればよいのか」に答えられるでしょうか。
大量のログがあり、きれいな画面が表示されている。それだけでObservabilityが完成するわけではありません。「見えること」と「管理できること」は違います。
| 役割 | 主に見るもの | 判断すること |
|---|---|---|
| 経営者・事業責任者 | 成功率、重大事故、人間介入率、1業務コスト、業務価値 | 任せ続けるか、利用範囲を広げるか |
| CTO・トップエンジニア | Trace、Tool、Retry、Latency、Cost、State、Version | どこで問題が起き、何を直すか |
| AI統括・ガバナンス責任者 | 高リスク操作、承認、ポリシー逸脱、停止履歴、監査証跡 | どこで止め、誰へ渡すか |
本記事ではこの考え方を便宜上「3層Observability」と呼びます。これは公的な標準ではなく、Arpable編集部による実務上の整理です。同じ事実を、経営には意思決定の材料、技術には原因究明の材料、統制にはリスク判断の材料として届けます。
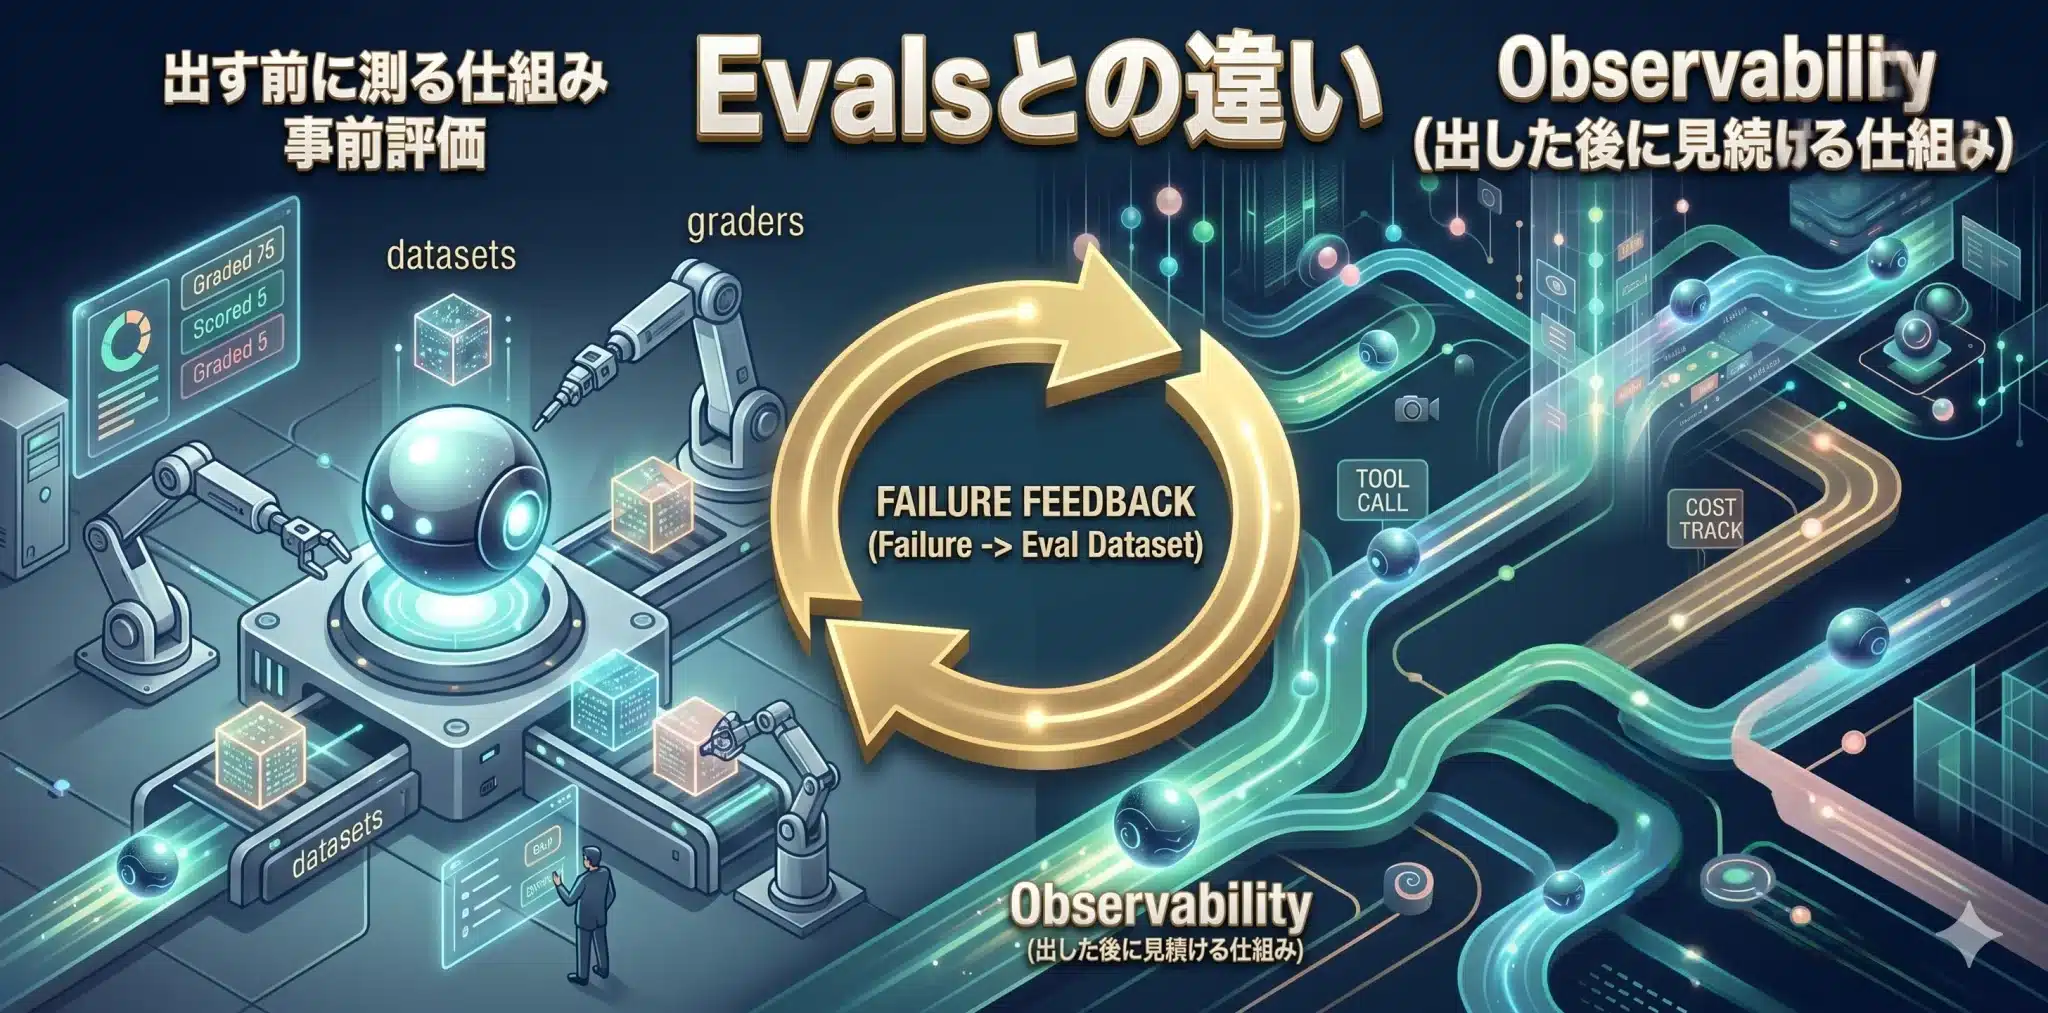
Observability・Evals・Failure Detection・Guardrailsの違い
AI統制では、見る・評価する・異常を判断する・止める・再開するという役割を分け、一つの運用ループへつなぐ必要がある。
| 機能 | 中心となる問い | 役割 |
|---|---|---|
| Observability | 何が起きたか? | 実行事実を取得・追跡する |
| Evals | 期待どおりだったか? | 品質・安全性・成功条件で評価する |
| Failure Detection | 異常なのか? | 失敗兆候や異常パターンを検知する |
| Guardrails / Human Review | 止めるべきか? | 制限し、必要な場面を人へ渡す |
| Approval Policy / Runbook | 誰が判断し、どう再開するか? | 停止後の承認・復旧・再開を定める |
OpenAIの「Evals終了」をどう理解すべきか
ここで誤解してはいけないのは、OpenAIが「Evals=AIを評価する考え方」そのものをやめるわけではないという点です。終了予定なのはOpenAI Platform上で提供されてきたEvals製品で、2026年11月30日以降は利用できなくなる予定です。
学校そのものがなくなるのではなく、「OpenAIが用意した特定の試験会場」が閉じると考えると分かりやすいでしょう。
今後より重要になるのは、特定製品に依存せず、本番で見つかった失敗を評価ケースへ戻し、開発・運用の中で継続的に再検証できる仕組みを持つことです。
先ほどの営業AIなら、Observabilityで想定外のCRM更新が見つかり、Failure Detectionが異常を判断し、Guardrailが止め、人間が確認する。再現可能な失敗ならEvalsへ戻して次回のテストに加える。このループが閉じて初めて、AI運用は「見えるだけ」から「改善できる」状態へ変わります。
AIエージェント統制シリーズにおける本記事の位置づけ
- A2A / MCP = 何をどうつなぐか
- AIエージェントセキュリティ = なぜ危ないか、何を守るか
- AI Evals = 何を良しとするか
- Observability = 本番で何を見るか(本記事)
- Failure Detection = 何を異常と判断するか
- Guardrails / Human Review = どこで止め、人へ渡すか
- Approval Policy / Runbook = 止めた後、誰が判断し、どう再開するか
Observabilityツールは何を基準に選ぶべきか
製品名ではなく、Trace、外部操作、コスト、評価連携、データ管理をどこまで追え、移植できるかで判断すべきである。
AIエージェントObservabilityには、LLMアプリケーション向けの専用基盤、エージェント基盤に統合されたTracing機能、既存Observability基盤をAIへ拡張する方法などがあります。
大切なのは「最も有名な製品」を選ぶことではありません。TraceをAgentやToolをまたいで追えるか、Costを業務単位で見られるか、評価ケースへ戻せるか、機密情報をどう扱うか、既存の監視基盤へ接続できるかを確認します。
| 選定軸 | 確認ポイント |
|---|---|
| Trace / Tool | 複数Agent・Toolをまたぐ実行経路と外部操作を追えるか |
| Cost / Performance | Session・Agent・業務単位で費用と遅延を見られるか |
| Evaluation | 本番Failureを評価データやRegression testへ戻せるか |
| Security | Prompt、顧客情報、個人情報をどう保存・マスキングするか |
| Interoperability | OpenTelemetry、API、既存監視・SIEM基盤へ接続できるか |
製品は変わります。しかし、何を観測するかという設計は残ります。OpenTelemetryのような標準との接続性を確認し、観測データを特定ベンダーの画面だけに閉じ込めないことも重要です。
同時に、Observability自身が新たな情報漏洩経路にならないよう注意が必要です。TraceにはPrompt、検索結果、Tool引数、中間出力が含まれる可能性があります。この点はAIエージェントセキュリティやゼロトラスト設計とセットで考えるべきです。
実務ではどう始めるか|1業務から閉じたループを作る
最初から全社監視を目指さず、一つの重要業務で観測・判断・停止・改善までのループを完成させることが現実的である。
Observability導入でありがちな失敗は、最初から「すべてのログを集める」ことです。データ量だけが増え、誰も見ないダッシュボードが完成します。
- 重要業務を1つ選ぶ:成功・失敗を業務として説明できるユースケースを対象にする。
- Traceを残す:モデル、検索、Tool、Retry、状態遷移を一つの実行として追う。
- 高リスクToolを決める:送信、更新、削除、外部共有などを特定する。
- 誰が何を見るかを決める:経営・技術・統制で粒度を分ける。
- 異常時の次工程を決める:Detection、Guardrails、Human Review、Runbookへつなぐ。
- 本番Failureを評価へ戻す:再現可能な失敗を次のテストケースに加える。
営業AIでCRM更新の逸脱が見つかったなら、それを「今回だけの事故」で終わらせず、同じ条件を評価ケースへ追加します。モデルやPrompt、Workflowを変更したあとにも再テストすれば、Observabilityが継続改善へつながります。
Observabilityは、ダッシュボードが完成した時点では完成していません。観測した事実が、人間の判断、停止、修正、再評価へ流れたとき、初めて運用基盤になります。
Observability導入セルフチェック
- TraceとTool callを追えるか?
- Latency、Cost、状態遷移、挙動変化を確認できるか?
- 高リスク操作を後から監査できるか?
- 経営・技術・統制で「誰が何を見るか」が決まっているか?
- 異常時に停止・人間確認・再開へつながるか?
- 本番Failureを次の評価ケースへ戻せるか?
導入全体の進め方はAIエージェント導入・実装ガイド、本番運用全体はLLMOps完全ガイドも参照してください。
一次情報からどこまで言えるか
一次情報はTraceやTool利用を観測し、評価と改善へつなぐ重要性を示す一方、万能なしきい値までは与えていない。
OpenAIのTrace関連資料は、Agentの実行履歴を評価し、Workflowレベルの問題を調査する考え方を示しています。またAgents SDKにはTracingが組み込まれ、モデル生成、Tool call、handoff、Guardrailなどを記録できます。
Anthropicは、自社のマルチエージェントResearchシステムでproduction tracingを導入し、検索クエリ、情報源の選択、Tool failureなどの原因切り分けに役立ったと説明しています。また同社のEvals解説では、transcriptを読み、Agentの失敗と評価側の問題を分けて考える重要性も示しています。
Google CloudはAgent Observabilityで、LLMとのやり取り、Tool利用、状態変化、性能、安全性、品質評価などを観測対象として整理しています。これらから言えるのは、本番AIの品質を最終回答だけで判断しないという方向性です。
一方で、「重大事故率は何%以下なら安全か」「人間介入率は何%が正解か」といった万能の数字があるわけではありません。何を重要とみなし、どこから人間が介入するかは企業自身が決める必要があります。
まとめ|AIに仕事を任せ続けるために、何を見るのか
Observabilityの本質はログを増やすことではなく、AIの実行を調査可能にし、企業が次の判断を下せる状態をつくることである。
AIエージェントは、正しい答えを返した。しかし企業が知るべきなのは、それだけではありません。
どの経路を通り、何を検索し、どのToolを呼び、何を変更したのか。どこでRetryし、いくらかかり、以前と仕事の仕方は変わっていないか——問うべきことは、答えの外側にもあります。
予想外をゼロにすることはできません。しかし、予想外を早く捉え、原因を切り分け、止め、直し、次の評価へ戻すことはできます。
Observabilityとは、AIを監視する技術ではありません。AIに仕事を任せ続けるための「判断材料」をつくる仕組みです。
信頼とは、AIを疑わないことではありません。必要なときに、その仕事ぶりを確かめられることです。
いま、あなたの会社のAIが何をしているのか、説明できるでしょうか。
専門用語まとめ
| 用語 | 意味 |
|---|---|
| Observability | Trace、Log、MetricなどからAgentの挙動を調査・分析できる状態 |
| Trace | タスク開始から終了までの一連の実行経路 |
| Tool call | 検索、API、DB更新、メール送信などの外部操作 |
| State transition | Agentが「検索中」「承認待ち」「実行中」などの状態間を移動すること |
| Evals | AIの出力や実行を評価基準やテストケースで検証する考え方 |
参考文献 / 出典
一次情報
次に読むならこの3本
補足Q&A
Q1. AIエージェントObservabilityとは何ですか?
A1. Trace、Tool call、Latency、Cost、状態遷移などから本番挙動を追い、異常や変化の原因を調査・切り分けられる状態をつくることです。
Q2. ObservabilityとMonitoringは何が違うのですか?
A2. Monitoringは定めた指標やしきい値の確認を得意とします。Observabilityはそれを置き換えるのではなく、Trace、Log、Metric、Tool callなどを関連づけ、想定外の挙動を調査できる範囲を広げます。
Q3. OpenAIのEvals製品が終了すると、AI評価はできなくなるのですか?
A3. いいえ。終了予定なのはOpenAI Platform上のEvals製品であり、AIを評価するEvalsという考え方そのものがなくなるわけではありません。本番Failureを評価ケースへ戻し、継続的に検証する仕組みは引き続き重要です。
更新履歴
- 2026年9月13日:検索動向と2026年の運用環境を踏まえて全面更新。6つの観測項目、経営・技術・統制の3層整理、OpenAI Evals製品の終了予定、ツール選定軸を反映。
- 2026年4月29日:初版公開。