2026年9月に登場したOpenAIのGPT-6 Astraは、AIが「質問に答えるモデル」から、推論し、PCやツールを操作し、仕事を成果物まで進めるエージェントシステムへ移りつつあることを象徴した。
かつてAIは「Prompt → Answer」だった。本稿では、いま起きている変化を「Goal → Reasoning → Tools → Action → Artifact」への転換として捉える。
だが、AIが自分で考え、PCを操作し、仕事を完遂できるなら、それはまだ「LLM」と呼ぶべきものなのか。
本記事ではGPT-6 Astraを単なる最新モデルとしてではなく、LLM、AIエージェント、AGI、RSIの境界がどこまで動いたのかを読み解く、2026年9月時点のAI進化地図として解説する。
✅ 先に結論
- GPT-6 Astraの本質は「より賢いLLM」ではなく、Reasoning、Memory、Computer Use、Toolsを組み合わせ、仕事を成果物まで進めるAIへ近づいたことにある。
- ARC-AGI-3ではStandard Harnessで62.7%、OpenAI固有のProvider Adapter・reasoning effort=highでbest observed score 99.9%。AIの実力はモデル単体ではなくシステム全体で決まり始めている。
- AIはAI研究や推論チップJalapeñoの設計・最適化まで支援しているが、完全なRSI(再帰的自己改善)が成立したわけではない。
- GPT-6 AstraをAGIと断定する根拠もない。ただし、AGIをSFではなく実測能力で議論できる段階には入った。
- 人間に不要になるのは「理解」ではない。コード1行を理解する粒度から、目的・制約・構造・検証・リスク・責任を理解する粒度へ、人間の理解のレイヤーが上がっている。
GPT-6 Astraで何が変わったのか|「答えるAI」から「仕事を完遂するAI」へ
GPT-6 Astraの転換点は回答精度ではなく、推論後にPCやツールを操作し、複数工程を進めて成果物まで作る能力にある。
2025年までのAI進化は、比較的分かりやすく説明できました。
初期の生成AIは「Prompt → Answer」型でした。Reasoning Modelでは問題分解、推論、検証、やり直しが加わり、「Prompt → Reasoning → Answer」へ進みました。
GPT-6 Astraで重要なのは、その先です。人間が細かな操作ではなくゴールを与えると、AIが情報を探し、考え、ツールを選び、PCを操作し、文書、表計算、コード、CADなどの成果物まで作る。

AIに任せられる単位が「回答」から「作業」、さらに「成果物」へ広がり始めています。
コンピューター操作能力を測るOSWorld 2.0のオフライン・partial score(部分点)では、GPT-6 Astraは72.6%、GPT-5.6 Solは65.7%。1タスクあたりの所要時間も約75分から約40分へ短縮しました。
これは「仕事の72.6%を自動化できる」という意味ではありません。重要なのは、AIが数十分にわたりPC上の仕事を進められる存在になったことです。
出典:OpenAI「GPT-6 Astra: A new generation of intelligence」
AIはどうやって「考える」ようになったのか
即答型LLMからReasoning Modelへ進化し、「考える時間」そのものがAI性能の一部になった。
従来のLLMは大量の学習データから次の言葉を高速に予測してきました。しかし複雑な数学や多段階の計画では途中で誤りやすい。そこでChain of Thought、Self-reflection、Test-Time Computeなど、「すぐ答えず、考え、試し、検証し、必要ならやり直す」仕組みが発展しました。
厳密な心理学モデルとの対応ではありませんが、これは直感的なSystem 1より、時間を使って問題を分解するSystem 2的な振る舞いに近い比喩で理解できます。
そして推論能力がブラウザ、PC、ターミナル、専門ソフトと接続されたとき、Reasoning ModelはAIエージェントの「頭脳」へ変わります。
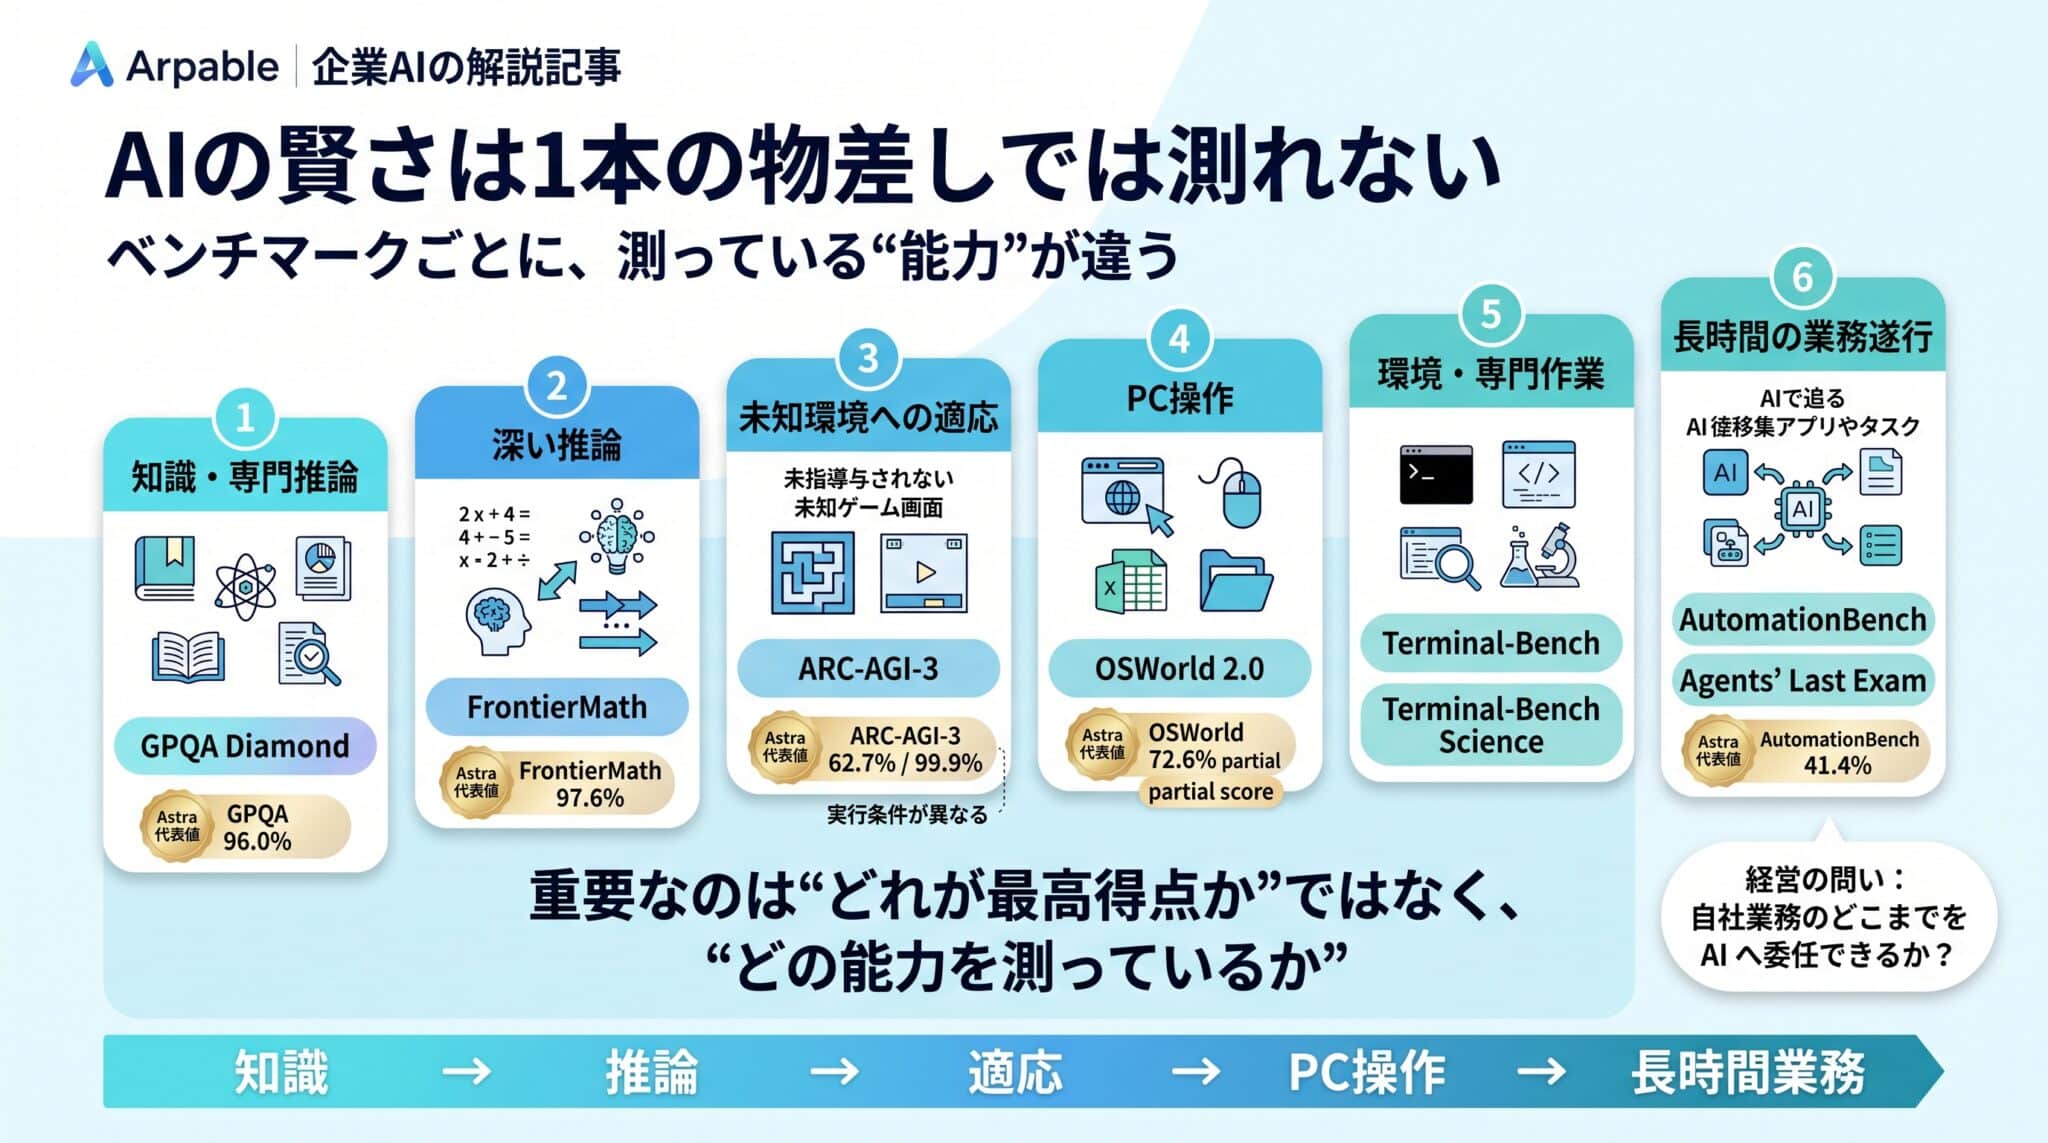
AIの「賢さ」はどう測る?|ベンチマークを能力地図として読む
2026年のAI評価は知識量だけでなく、未知環境への適応、PC操作、長時間の専門業務まで広がっている。
| 能力 | 代表ベンチマーク | 何を測るか | Astra |
|---|---|---|---|
| 科学推論 | GPQA Diamond | 大学院レベルの科学問題 | 96.0% |
| 高度な数学 | FrontierMath Tier 4 v2 | 最前線レベルの数学 | 97.6% |
| 未知環境への適応 | ARC-AGI-3 | 規則を発見しながら行動 | 62.7% / 99.9% |
| PC操作 | OSWorld 2.0 | GUIを使う長時間作業 | 72.6% partial |
| 専門業務 | Agents’ Last Exam | 実ソフトを使う知識労働 | 59.3% |
| 業務自動化 | AutomationBench | 複数工程の業務遂行 | 41.4% |
| 環境操作 | Terminal-Bench 4.0 | ターミナルを使う作業 | 57.9% |
| 科学ワークフロー | Terminal-Bench Science 0.1 | 解析・コード・シミュレーション | 64.6% |
| サイバー能力 | ExploitBench | 脆弱性を利用する能力 | 100% |
| ※出典:OpenAI、ARC Prize。評価条件が異なるため単純な横比較はできない。ARC-AGI-3の62.7%はStandard Harness、99.9%はProvider Adapter・reasoning effort=highでのbest observed score。 | |||
この表はモデルのランキングではありません。知っている → 考える → 未知環境で学ぶ → PCを操作する → 長時間仕事をするという能力の広がりを見る地図です。
なぜ同じAstraが62.7%にも99.9%にもなるのか
ARC-AGI-3では、プロバイダー中立のStandard Harnessで62.7%、OpenAI固有の状態保持と文脈管理を使うProvider Adapterで99.9%が報告されています。
受験生でいえば、前者は問題用紙と筆記具だけ、後者は長時間考えても途中状態を失わず、長い文脈を整理できる環境です。答えを教えるわけではありませんが、「考え続けられる環境」が違います。
Provider Adapterでは内部の推論状態を保持し、長い文脈を文脈圧縮(compaction)で管理します。
AIの実力 = モデル能力 × 記憶・状態管理 × ツール × 実行環境 × エージェント設計
経営側が見るべきなのは最高得点ではなく、どのAIシステムに、仕事のどこまでを任せられるのかです。
これはまだLLMなのか?|ModelとAgent Systemの境界
Astra自体はモデルだが、Memory、Tools、Computer Use、実行環境が接続されると、利用者が触れるのはAIエージェントシステムになる。
Astraそのものはモデルです。しかし企業で使うときには、その周囲にMemory、Context Management、Browser、Computer Use、Tools、Agent Runtimeが接続されます。
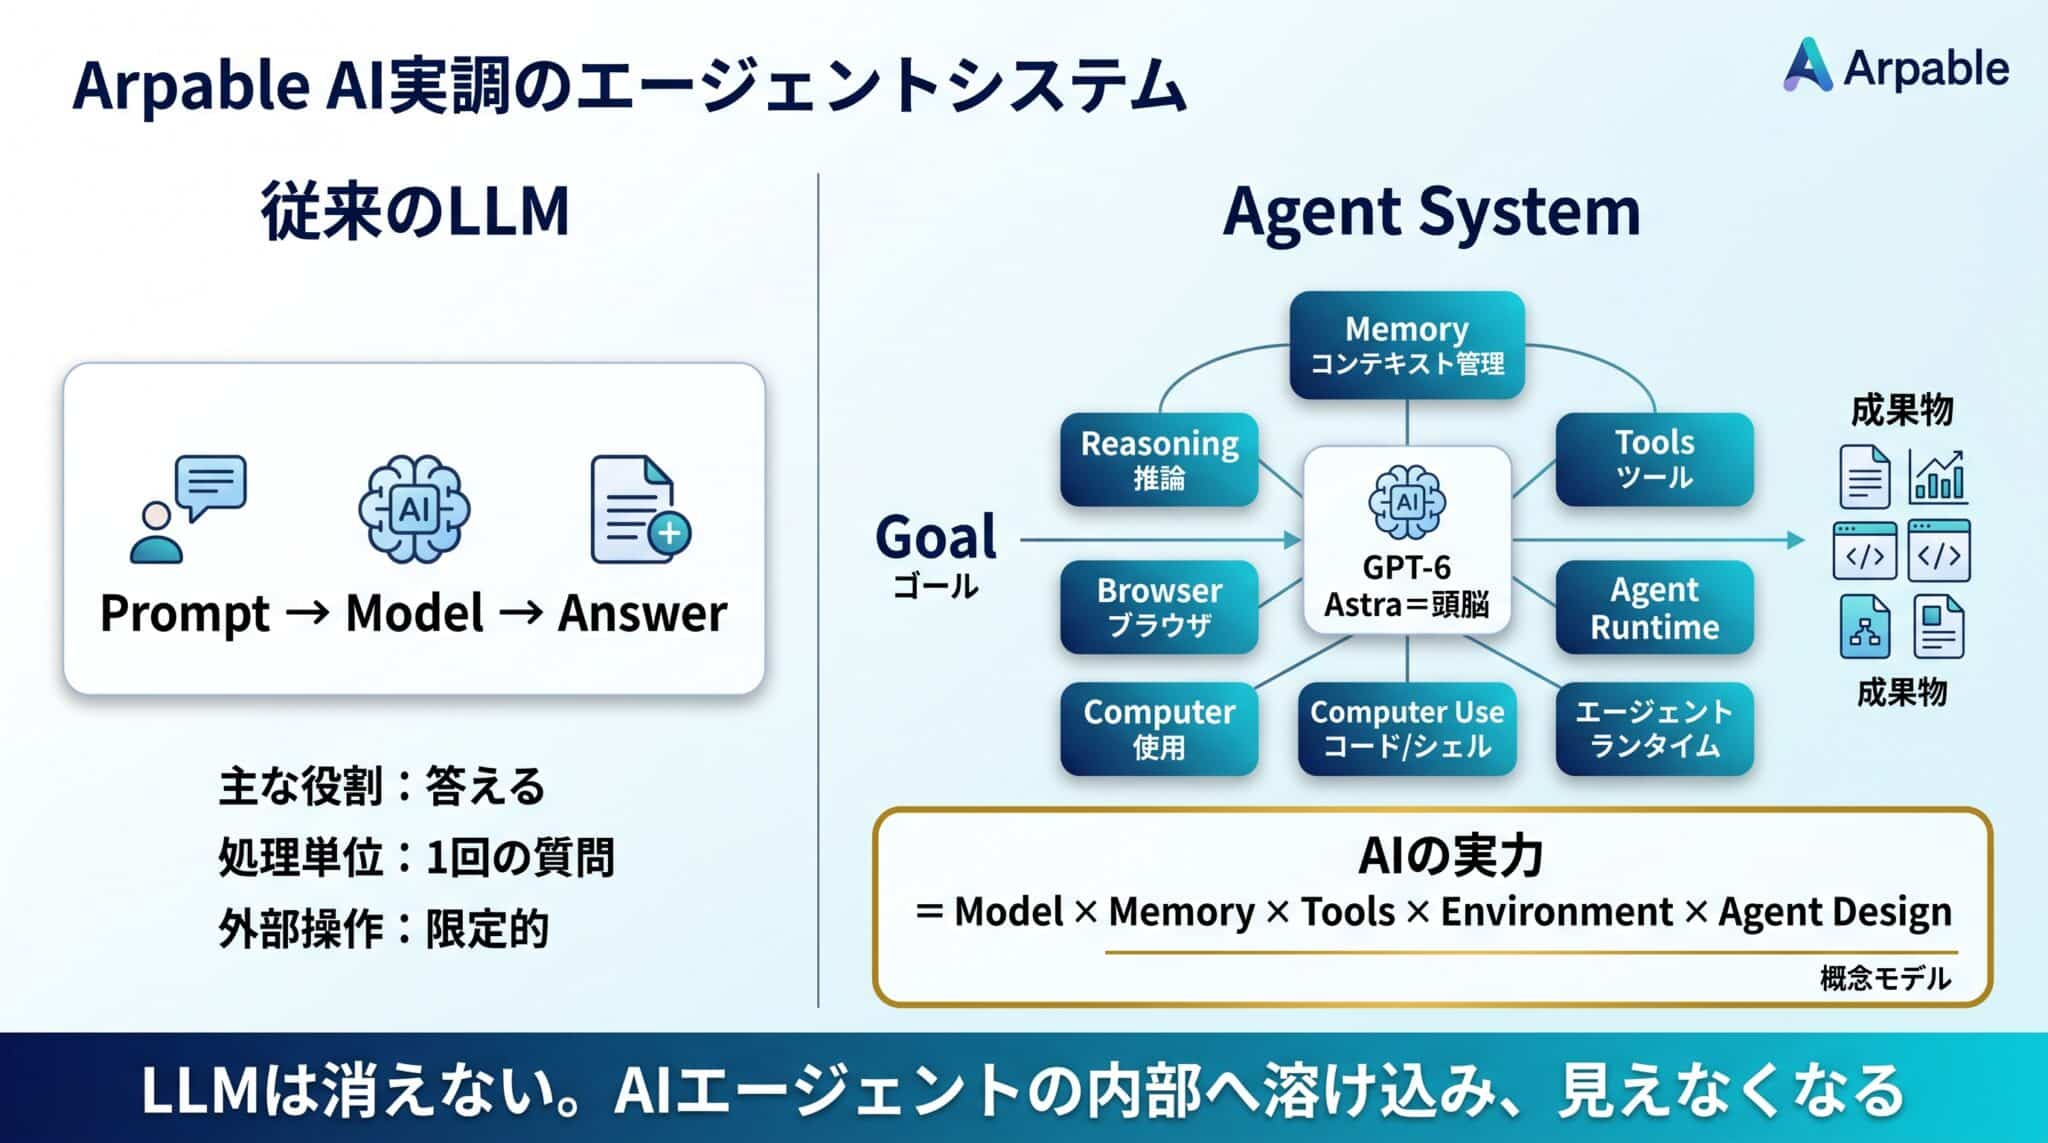
人間に例えれば、Astraは「頭脳」です。実際の仕事にはPC、過去資料、業務システム、権限、進捗管理が必要で、それらを組み合わせた全体がAgent Systemです。
LLMがなくなるのではない。LLMがAIエージェントの内部へ溶け込み、利用者から見えにくくなっている。
将来、利用者は「LLMを使う」と意識せず、「市場を調べて提案書を作って」とゴールだけを渡すようになるでしょう。その裏側でモデル、検索、PC操作、コード、ファイル作成、検証ツールが連携します。
未確認のLooped Transformer説と、公式確認された監視可能性の課題
Looped Transformerの採用は公式未確認。一方、推論過程の監視可能性低下はSystem Cardで確認されている。
一部の報道や技術解説では、AstraにLooped Transformer/Recurrent Depthを採用した可能性が指摘されています。難しい問題ほど同じ計算ブロックを繰り返し使い、処理を深くする考え方です。
ただし、OpenAIはAstraの具体的な層構造として公式確認していません。
これとは別に、System CardではAstraの監視可能性(monitorability)がGPT-5.6 Solより低下したことが確認されています。敵対的条件では、CoT-only監視を回避できる場合もあります。
出典:OpenAI「GPT-6 Astra System Card」
Looped Transformer説と監視可能性低下の因果関係は確認されていません。重要なのは、AIが何を考えたかだけでなく、何を実行し、どの権限を使ったかを監視する必要が高まっていることです。
GPT-6 AstraはOpenAIのPreparedness Frameworkで、サイバーセキュリティ能力がCriticalに達した最初のモデルです。これは安全性認証ではなく、高度な攻撃能力に対して強い隔離・監視・権限制御が必要になったことを意味します。
出典:OpenAI「Safety overview: GPT-6 Astra」
AIは研究者になり始めたのか|AI for ScienceからResearch Automationへ
2026年は汎用エージェントがコード、実験、解析、検証を横断し、AI研究プロセスそのものへ入り始めた段階である。
AIによる科学支援は以前から存在しました。Astra世代で変わり始めているのは、汎用AIが研究プロセス自体へ入っていることです。
OpenAIは2026年9月、社内で「automated research intern」の水準へ到達したと発表しました。人間が定義した研究課題を受け、熟練研究者なら数日かかるタスクを実行するシステムです。
2026年8月中旬には、人間の1労働日あたり3.1 agent-workdays相当のエージェント実行時間が使われていました。一方、4~8時間級タスクでは成功例の半数超で少なくとも1回の人間介入が必要でした。
出典:OpenAI「Research acceleration: The view inside OpenAI」
現在起きているのは「人間なしの研究」ではなく、人間が上位判断を握ったまま、実験・実装・分析の処理量をAIで増幅する変化です。
AIは自分自身を改善し始めたのか|JalapeñoからRSIを考える
AIは自分を動かす推論チップの設計・最適化にも参加し始めたが、完全なRSIには至っていない。
その入口を示すのが、OpenAIとBroadcomの推論チップJalapeñoです。
「9か月でチップ完成」と紹介されることがありますが、正確には初期設計から製造テープアウト(manufacturing tape-out)まで9か月です。量産完了ではありません。
出典:OpenAI「OpenAI と Broadcom、LLM 最適化推論チップを発表」
AIは実装候補の探索、設計・測定・検証ループ、演算回路の最適化を支援しました。人間が目標を決め、AIが多数の案を試し、結果を測定し、人間が判断する——このループを高速化したのです。
CodexとAstra系モデルを使い、当初の計画になかった3つのオープンウェイトモデルも2か月以内に高性能化しました。選定されたGPT-OSSのAttention/MoEブロックでは、AI生成実装が人間専門家の既存実装より1.5~1.8倍高速だったケースもあります。モデル全体の倍率ではありません。
出典:OpenAI「Jalapeño’s first results」
では、これがRSIなのか
RSIはRecursive Self-Improvement、再帰的自己改善です。改善されたAI自身が、次のAI改善をさらに速める循環を指します。
現在のJalapeño(ハラペーニョ)や研究自動化は、まだ完全なRSIではありません。研究テーマ、設計方針、予算、安全基準、継続・停止などの上位判断は人間が握っています。
AI-assisted AI Development → Automated AI Research → bounded self-improvement → RSI
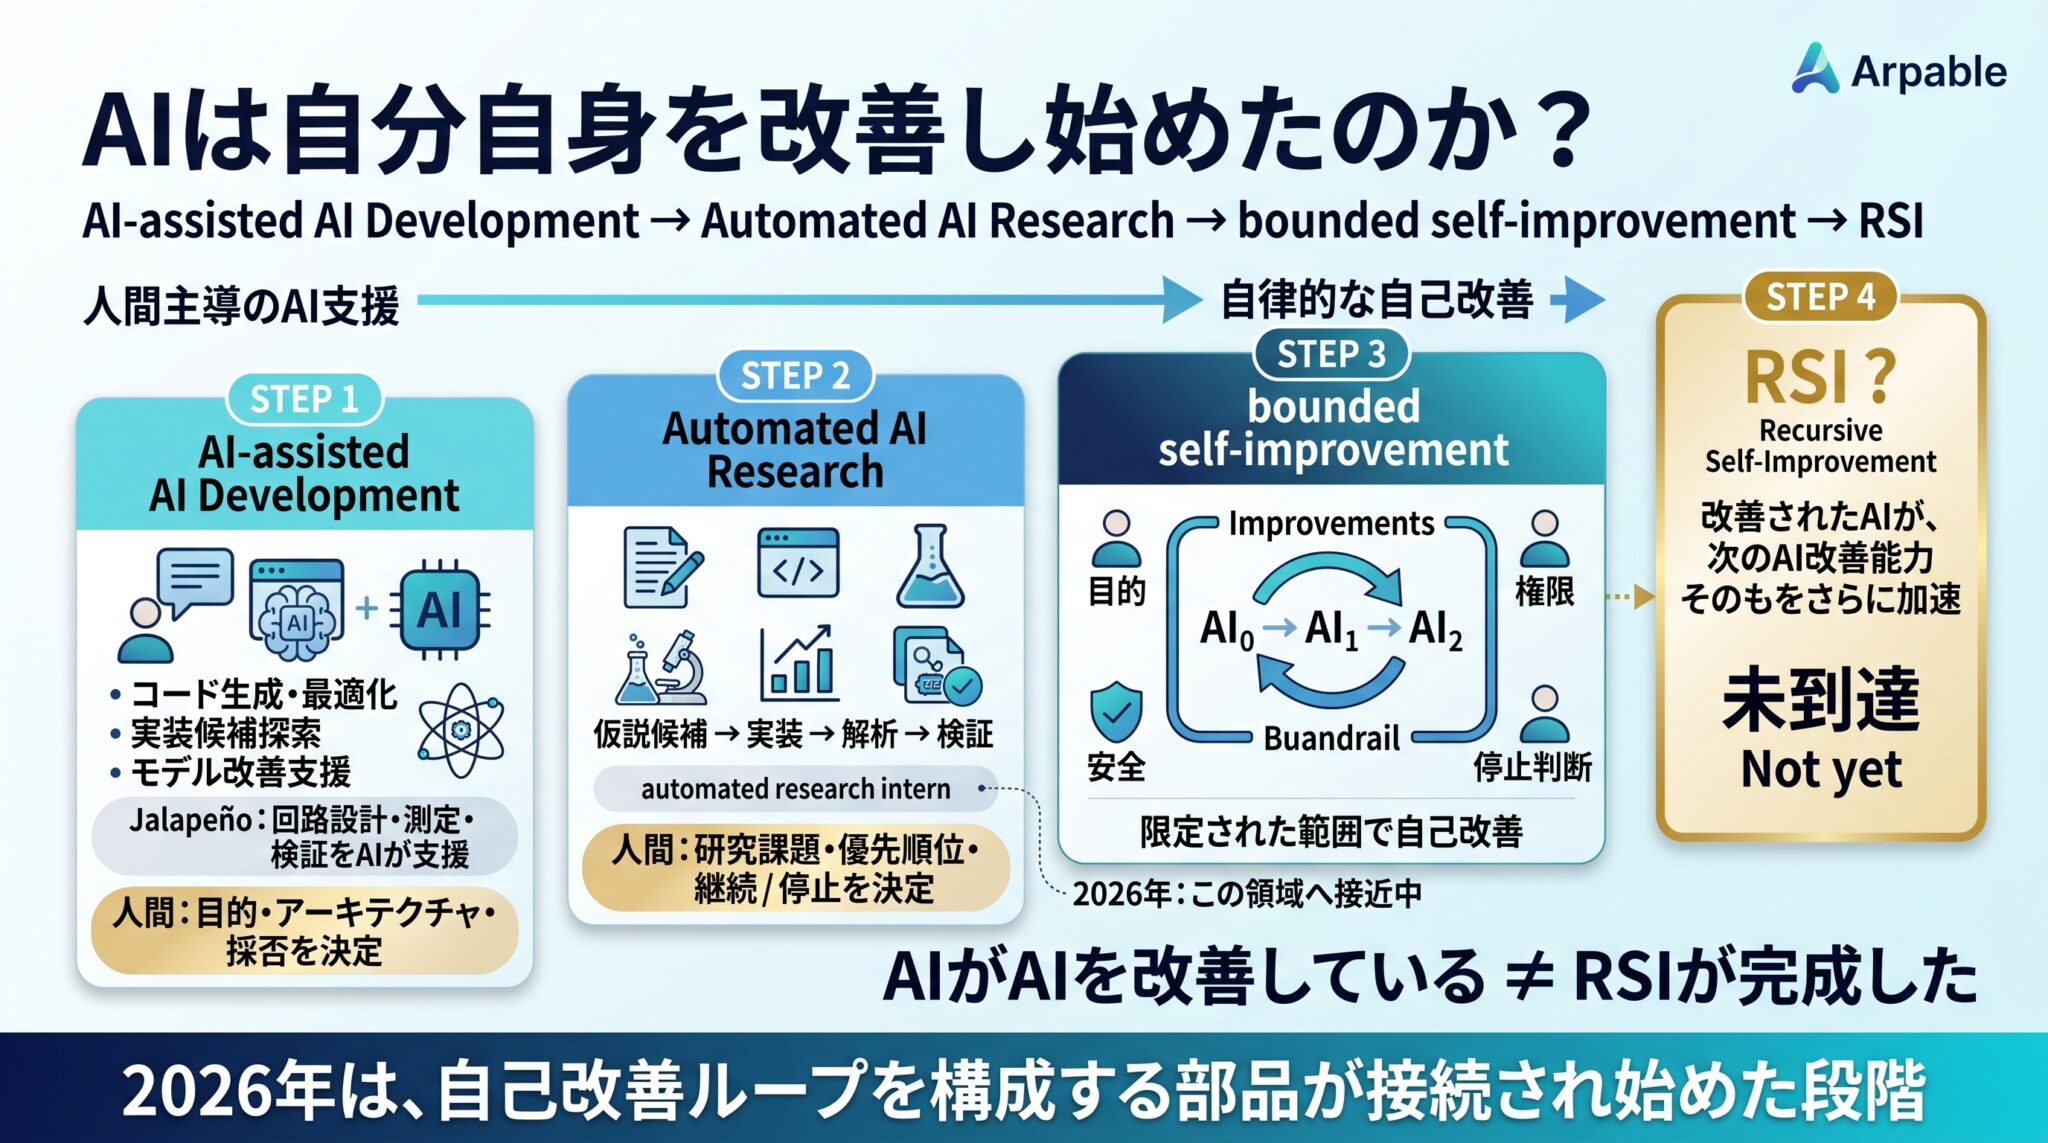
Arpable編集部では、現在を「RSIが完成した段階」ではなく、自己改善ループを構成する部品が一つずつ接続され始めた段階と捉えます。
ではGPT-6 AstraはAGIなのか?
Astraは汎用性と自律性を高めたが、経済的価値のある仕事の大部分で人間を上回ったとの包括的実証はない。
OpenAI CharterはAGIを、「経済的に価値のある仕事の大部分で人間を上回る、高度に自律的なシステム」と定義しています。
| 評価軸 | 評価 | 理由 |
|---|---|---|
| 汎用的な知能 | 大幅に前進 | 数学、科学、コーディング、PC操作まで対応範囲が広い |
| 未知環境への適応・自律性 | 大幅に前進 | ARC-AGI-3やOSWorldで能力が向上 |
| 経済的価値のある仕事の大部分で人間を上回る | 未証明 | 実務ベンチマークに未達が残り、包括的実証もない |
| ※OpenAI公式ベンチマーク、ARC Prize、OpenAI CharterをもとにArpable編集部が整理。個別ベンチマークはAGI定義を直接測定する試験ではなく、飽和自体もAGI到達の証明ではない。 | ||
現時点で最も妥当な表現は、「AGIに到達した」ではなく、「AGIを実測データで議論できる時代へ入った」です。
経営にとって重要なのはAGIというラベルより、自社業務のどこまでを今のAIへ委任でき、どこから先は人間の判断が必要なのかです。
なぜOpenAIは「製品会社」から知能プラットフォーム企業へ向かうのか
Altman氏が示した戦略観では、個別アプリよりも汎用知能と、それを利用するインターフェース/APIを重視する方向が鮮明である。
Sam Altman氏は2026年8月のインタビューで、OpenAIは「product companyよりplatform companyであるべき」という趣旨を述べました。
個別AI製品をすべて自社で作るのではなく、一つのインターフェースとAPIから知能を提供する構想です。同氏はSoraやAtlasを終了した理由にも触れ、知識労働、将来的な科学研究を担うgeneral intelligenceを優先する考えを示しています。
これはOpenAIの正式な企業方針文書ではなく、Altman氏が示した戦略観です。
出典:David Senra「Sam Altman」2026年8月23日
Chip → Compute → Model → Agent Runtime → Interface / API
AstraとJalapeñoの話はここでつながります。もし自社の議論が「どのAI製品を導入するか」で止まっているなら、次に考えるべきは、そのAIをどの業務基盤へ組み込み、どこまで仕事を委任するかです。
Don’t Think / Don’t Understand|人間はもう理解しなくてよいのか
AI時代に不要になるのは理解ではなく、全実装を同じ粒度で理解する働き方である。
Don’t Write. Don’t Read. Don’t Understand. そして、Don’t Think.
これは「人間は何も考えるな」という意味ではありません。AIが生成したコードや設計案を、人間が一行ずつすべて理解してから進んでいたら、AIの速度を活かせないという問題提起です。
本稿では、AIがシステムを生成・変更する速度と、人間・組織が安全な変更・復旧・説明に必要な理解を維持する速度との差を、Comprehension Debt(理解負債)と呼びます。
AI時代は、「理解するか、しないか」ではなく、「人間は何を、どの粒度で理解すべきか」が重要になる。
| 理解すべき対象 | 人間が答えるべき問い |
|---|---|
| 目的の理解 | 何を達成するためのシステムなのか |
| 制約の理解 | 法令、予算、権限、倫理、安全の境界はどこか |
| 構造の理解 | 主要構成、データ流、依存関係、障害連鎖はどうなっているか |
| 検証条件の理解 | 何を満たせば「正しい」「完了」と判定できるか |
| リスクの理解 | どの誤りは許容でき、どれが致命的か |
| 責任の理解 | 誰が停止・承認・復旧・説明を担うか |
| ※Arpable編集部整理。AIに実装を委任するほど、詳細実装の全読解より上位レイヤーの理解と統治が重要になる。 | |
AIに「どう作るか」を任せても、「なぜ作るか」「どこまで任せるか」「何をもって正しいとするか」「失敗したとき誰が責任を持つか」は人間の仕事として残ります。
価値の重心も、実装力 → 設計力 → 構想力 → 委任力 → 検証力へ移ります。
Don’t Understandの本質は理解の放棄ではありません。Understand every lineから、Understand the systemへ。理解する階層を上げることです。
まとめ|LLMは消えない。「見えなくなる」
GPT-6 Astraが象徴した最大の変化は、LLMが単体製品ではなくAIエージェントの知能コアとしてシステム内部へ溶け込み始めたことである。
GPT-6 AstraをAGIと断言する根拠はありません。完全なRSIが成立したわけでもなく、Looped Transformer採用も公式確認されていません。
それでもAIは、質問に答える存在から、考え、PCやツールを使い、長時間仕事を進め、成果物を作る存在へ進みました。さらにAI研究や、自分自身を動かすハードウェアの開発まで支援し始めています。
LLMはなくならない。AIエージェントの内部へ溶け込み、利用者から見えなくなっていく。
AIが「考えなくてもよいこと」を増やすほど、人間には別の問いが残ります。何をAIに任せるのか。何を人間が理解するのか。どこで止めるのか。何をもって正しいと判断するのか。そして最後に——誰が責任を引き受けるのか。
なかでも「どこで止めるのか」という問いは、AIの能力そのものとは別の問題です。
AIの能力向上に、人間や組織の監視・判断・停止能力は追いつけるのか。
OpenAI・Anthropic・Google DeepMindの一次情報から、この「Control Gap(制御ギャップ)」を整理した「AIは止められるのか?OpenAI・Anthropic・Google DeepMindが始めた『制御競争』【2026年版】」で詳しく解説しています。
2026年のAI推論革命とは、AIだけが賢くなる革命ではありません。人間自身が「自分は何を理解し、何を考えるべき存在なのか」を改めて問われ始めた革命なのです。
AIに仕事は任せられる。だが、目的と責任まで手放してよいのか。
専門用語まとめ
本記事の主要用語を、次に同じ言葉に出会ったとき迷わないための地図として整理する。
| 用語 | 意味 |
|---|---|
| Reasoning Model | 回答前に問題分解・推論・検証を行うAIモデル |
| ARC-AGI-3 | 未知環境で規則を発見し、試行錯誤できるかを見るベンチマーク |
| Harness | モデルを動かす実行環境。文脈管理や状態保持などを含む |
| Computer Use | AIが画面を認識し、PC操作を進める能力 |
| RSI | 改善されたAIが次のAI改善を加速する再帰的自己改善 |
| AGI | OpenAIでは「経済的価値のある仕事の大部分で人間を上回る高度に自律的なシステム」 |
| Monitorability | AIの思考・行動を監視し、望ましくない挙動を検出できる度合い |
| Comprehension Debt | 本稿ではAIの変更速度と、組織が維持できる理解速度との差を「理解負債」と表現 |
| ※本記事の文脈に合わせて平易に整理。厳密な定義や評価条件は各一次情報を参照。 | |
一次情報・出典
OpenAI、ARC Prizeなどの一次情報を優先し、公式確認済みの事実、評価条件、Arpable編集部の分析を区別している。最終確認日:2026年9月14日。
- OpenAI – GPT-6 Astra: A new generation of intelligence
- OpenAI – Safety overview: GPT-6 Astra
- OpenAI – GPT-6 Astra System Card
- ARC Prize – OpenAI’s GPT-6 Astra on ARC-AGI-3
- OpenAI – Research acceleration: The view inside OpenAI
- OpenAI – OpenAI と Broadcom、LLM 最適化推論チップを発表
- OpenAI – Jalapeño’s first results
- OpenAI – OpenAI Charter
- David Senra – Sam Altman, August 23, 2026
次に読むならこの3本
本記事で見たAI進化を、モデル戦略、AIエージェント実装、人間の構想力へつなげる。
補足Q&A
GPT-6 Astra、LLM、AIエージェント、AGI、RSIについて誤解されやすいポイントを確認する。
Q1. GPT-6 AstraはAGIですか?
現時点でAGIと断定することはできません。 汎用性と自律性は向上しましたが、「経済的価値のある仕事の大部分で人間を上回る」ことを包括的に実証したデータはありません。
Q2. GPT-6 AstraはLLMですか、それともAIエージェントですか?
Astraそのものはモデルであり、Memory、Tools、Computer Use、実行環境などを組み合わせた全体がAIエージェントシステムです。
Q3. AIのRSIはすでに始まっていますか?
自己改善を構成する一部のループは現実化していますが、完全なRSIが成立したとは言えません。 上位判断は依然として人間が担っています。
更新履歴
AI推論技術の変化に応じて、重要な能力・研究・安全性の変化を継続更新する。
- 2026年9月14日:旧「AI推論革命」記事の本文・図を全面刷新。GPT-6 Astra、ARC-AGI-3、Computer Use、Jalapeño、RSI、AGI、人間の「理解の粒度」を軸に2026年版として再構成。
- 2026年8月11日:記事内容を更新。
- 2025年7月31日:テンプレートv5.0適合化、最新情報に基づき内容を全面改訂。
- 2025年3月15日:初版公開。