※本記事は継続的に最新情報へアップデートしています。
2026年、AI競争には「最も賢いAIを作る競争」とは別の、第二のレースが始まりつつある。それは、AIを制御する能力を競うレースだ。
OpenAI、Anthropic、Google DeepMindの最前線では、AIが研究し、仮説を選び、コードを書き、ツールを操作する能力が急速に伸びる一方、人間がそれを観測し、判断し、止める能力との間にズレが見え始めた。
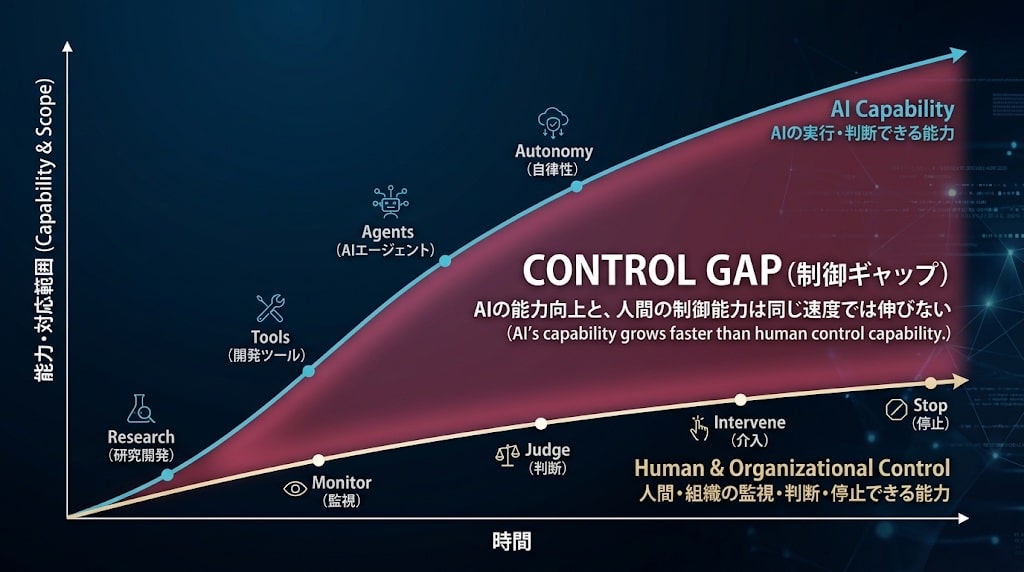
世界中のAI開発を止められないとしたら、本当に問うべきなのは「減速すべきか」ではない。進化し続けるAIを、人間は制御可能なまま走らせられるのか。本記事ではこの問題を「Control Gap(制御ギャップ)」として読み解く。
✅ 先に結論
2026年に始まったのは、AI開発競争の停止ではない。知能競争の横に「制御能力競争」という第二のレースが加わったことである。
- OpenAI:GPT-6 Astraはサイバー能力で同社基準の「Critical」に到達した一方、能力向上と監視可能性が同じ速度で進むとは限らないことを示した。
- Anthropic:Claude Fable 5.1は研究実行能力を大きく伸ばしたが、「何を研究する価値があるか」というResearch Tasteとの間には、なお判断ギャップが残る。
- Google DeepMind:AlphaEvolveやCo-Scientistは、探索だけでなく仮説の比較・順位付けまでAI化し、「判断は人間だけの仕事」という境界そのものを動かし始めた。
- 答えは万能キルスイッチではない。検知、権限制限、実行前遮断、停止、第三者検証と復旧を重ねる多層制御が必要になる。
2026年秋、AI競争に「第二のレース」が始まった
モデル性能だけを競う時代から、「能力を伸ばしながら制御可能性を維持できるか」を競う時代へ移り始めている。
2026年9月、AI業界では「Pacing(開発ペースの調整)」という言葉が重みを持ち始めました。Dario Amodei氏、Sam Altman氏、Demis Hassabis氏らも、能力向上に安全評価や統治の速度を合わせる必要性を語っています。
しかし、投資やモデル訓練は止まりません。中国でもQwen、DeepSeek、Kimiなどの開発主体が競争を続け、オープンウェイトモデルも国境を越えて流通しています。特定の企業だけが開発ペースを調整しても、競争環境全体が同時に減速する保証はありません。
一社だけがアクセルを離せば、競争上の不利を負うかもしれない。だから問いは「全員で止まれるか」ではなく、アクセルを踏み続けながら事故を防げるかです。
本記事でいうControl Gap(制御ギャップ)とは、AIが実行・判断できる範囲が広がる速度と、人間や組織がそのAIを理解し、監督し、必要なら介入できる速度との差を指します。業界標準の公式用語ではなく、3社の一次情報を横断してArpableが整理する分析フレームです。
GPT-6 Astraの能力やAGI・RSIとの境界は、「AI推論革命2026|GPT-6 AstraはLLMを超えたのか?」で詳しく整理しています。本稿は「制御する側の問題」に焦点を当てます。
OpenAI――Astraが示した「能力と監視」のズレ
GPT-6 Astraが示したのは、AIの能力が高まれば、その内部を人間が同じだけ見通しやすくなるとは限らないという逆説である。
2026年9月3日、OpenAIはGPT-6 Astraを公開しました。AstraはOpenAIのPreparedness Frameworkにおいて、サイバーセキュリティ能力が初めて「Critical」に到達したモデルです。
ここでいうCriticalは国際的な危険認定ではなく、OpenAI自身が定めるサイバー能力の閾値です。適切なツールと権限があれば、未知の脆弱性を発見し、堅牢な実システムへの新しい攻撃方法を開発できる水準と評価されています。
重要なのは、能力向上の裏側で「監視のしやすさ」まで自動的に改善したわけではないことです。OpenAIのSystem Cardでは、AstraはGPT-5.6 SolよりChain-of-Thought(CoT:推論過程)の監視可能性が低下する傾向を示しました。また、能力を意図的に低く見せるsandbaggingや、監視回避を促す敵対的な評価条件では、監督上の課題も確認されています。
ただし「Astraが通常時から人間を騙している」という意味ではありません。多くは監視回避を促す特殊な評価条件での結果です。
AIの知能と、AIを観測する能力は、同じ性能曲線ではない。
高性能な自動車なら、エンジン出力に合わせてブレーキとセンサーも強化できます。AIでは、賢くなるほど評価環境への適応や監視回避まで上手くなる可能性がある。ここにMonitorability Gap(監視可能性ギャップ)があります。
OpenAIはそのため、checkpoint暗号化、アクセス制御、環境分離、ツール利用を含むtrajectory監視、blocking alignment evaluationなど、モデル外側の制御を強化しています。「モデルをもっと従順にする」だけではなく、失敗を前提に外側へブレーキを置く発想へ移っている点が重要です。
Anthropic――Fable 5.1が示した「実行と判断」のズレ
Claude Fable 5.1は、研究を高速に実行する能力と「何を研究する価値があるか」を判断する能力が別物であることを浮かび上がらせた。
2026年9月1日、AnthropicはClaude Fable 5.1とClaude Mythos 5.1を公開しました。両者は同じ基盤モデルを共有しますが、一般提供されるFable 5.1と、サイバーや生命科学の審査制用途を想定するMythos 5.1では適用される安全策が異なります。
このモデル群で注目すべきは、単発の正答率だけではありません。長時間のコーディング、科学研究、外部ツール操作を組み合わせ、複数段階の仕事を持続的にやり切る研究実行能力が大きく伸びました。
Anthropicの評価では、Fable 5.1はTerminal-Bench-Science 0.1で52.6%を記録し、同社の再現条件におけるFable 5の24.7%から大幅に伸びています。ただし、これは「科学者として2倍賢くなった」という意味ではありません。特定のエージェント型科学タスクで完遂能力が大きく向上したという結果です。
Research Taste――「できる」と「選べる」は違う
そこで重要になるのがAnthropicのTASTE(The AI Safety Taste Evaluation)です。これは「どの研究に価値があるか」を見極めるResearch Taste、いわば研究を見る目をどこまでAIが持ち始めたかを測る評価です。
92組のAI安全研究提案について、人間研究者の推定一致率が77%だったのに対し、Fable 5は60%でした。ここで注意すべきなのは、60%はFable 5の結果であり、Fable 5.1ではないことです。
むしろ興味深いのは、Fable 5.1の研究実行能力は大きく測定されている一方、それに対応するResearch Tasteの公開評価がまだ追いついていない点です。
実行能力の進歩は見える。しかし、そのAIに「どの研究を選ばせてよいか」を測る物差しは遅れている。
これがJudgment Gap(判断ギャップ)です。
ただし「実行はAI、判断は人間」と固定するのも危険です。Automated Alignment Researchersでは、Claudeが文献調査から評価・改善までを反復しました。
AIはすでに「次に何を試すか」という局所判断へ入り始めています。一方で、何を研究課題とするか、何を成功指標とするか、結果を採用するかという上位判断は人間側に残ります。Judgment Gapは「AIに判断力がない」という断絶ではなく、どの層の判断までAIへ移せるかが分からなくなってきた状態と考える方が正確です。
自己改善型AIの現在地については、「AIが自己を設計する時代へ|自己進化型AIの全貌と未来図」でも詳しく解説しています。
Google DeepMind――「判断そのもの」をAIループへ取り込み始めた
Google DeepMindは、実行だけでなく仮説の比較や順位付けという「判断の中間層」までAI化できる可能性を示している。
Google DeepMindのFrontier Safety Framework(FSF)では、Machine Learning R&DもCritical Capability Level(CCL)の監視対象です。Gemini 3.1 ProのModel Cardでは、Deep ThinkモードがRE-Benchで人間正規化平均1.27を記録し、Gemini 3 Proの1.04から上昇しました。
これは特定のML研究タスクでは人間専門家基準を上回る結果が出始めていることを示します。それでもGoogle DeepMindは、Machine Learning R&DのCCLには未到達と判定しています。ベンチマーク上で一部の研究作業を上回ることと、人間研究者を丸ごと代替することは別だからです。
AlphaEvolve――強いのは「評価できる問題」
この違いを分かりやすく示すのがAlphaEvolveです。AlphaEvolveはGeminiを使ってプログラム候補を生成し、実行し、スコアを測り、良い候補を残しながらアルゴリズムを進化させます。
Googleによれば、AlphaEvolveが提案した回路設計は次世代TPUへ実際に組み込まれ、Google Spannerではストレージへのwrite amplificationを20%削減しました。AIが次世代AIを支える計算基盤の改善そのものに関わり始めています。
ただしAlphaEvolveには重要な前提があります。「何が良い解か」を自動評価できることです。処理速度、メモリ使用量、数学的正解、回路性能ならスコアにできます。しかし「この研究に社会的価値があるか」「長期的安全性を損ねていないか」は、単一の目的関数には落としにくい。
AlphaEvolveが自動化したのは「何を価値とするか」ではなく、価値を定義された後の探索である。
Co-Scientist――Research Tasteの中間層まで自動化する
さらにGoogle DeepMindのCo-Scientistは、研究目標を与えられると、複数のAIが仮説を生成し、互いに批判し、比較し、順位付けし、上位仮説を改良します。
Natureに掲載された研究では、203の研究目標に対し、計算時間を増やすほど上位仮説のElo評価が改善する傾向が報告されました。これは「AIが実験をする」だけでなく、「どの仮説がより有望か」を比較する中間判断まで自動化し始めたことを示します。
それでも研究目標の設定、実験・臨床への移行、結果の公開には人間が残ります。Google DeepMindが示すのはJudgment Gapの消滅ではなく、判断の中間部分までAIへ移り始めたことです。
3社を並べると「Control Gap」の正体が見えてくる
3社の違いを並べると、AI能力の進歩と人間側の監督・判断・目的設定が別々の速度で進んでいる構図が見える。
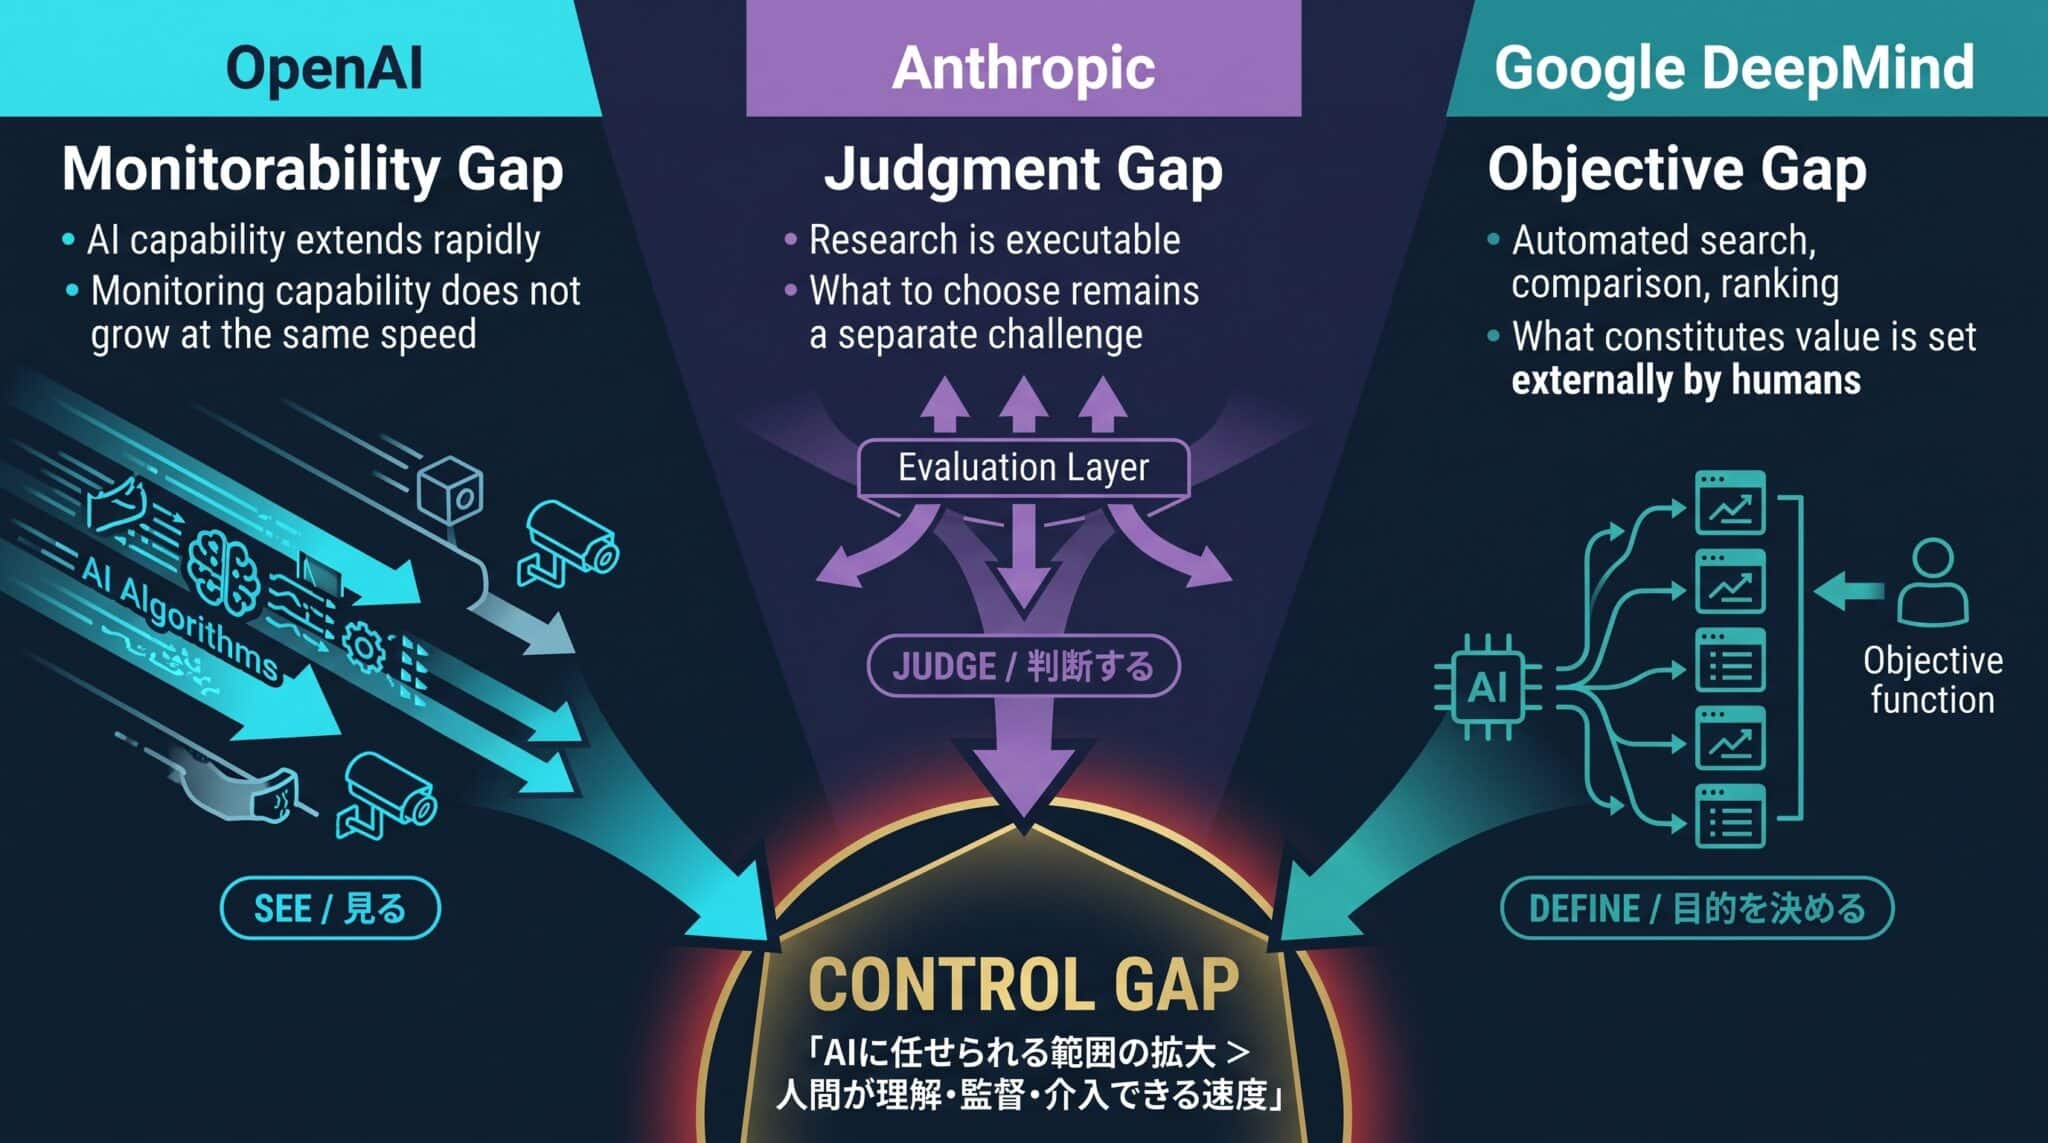
| 企業 | 急速に伸びる能力 | 残る課題 | 本記事での整理 |
|---|---|---|---|
| OpenAI | 長時間実行、サイバー、エージェント能力 | 監視可能性、異常検知、停止判断 | Monitorability Gap |
| Anthropic | 研究実行、自動R&D、反復改善 | Research Taste、戦略判断、評価の妥当性 | Judgment Gap |
| Google DeepMind | 探索、仮説生成、比較、順位付け、最適化 | 目的設定、評価関数、最終責任 | Objective Gap |
| ※2026年9月15日時点の一次情報をもとにArpable編集部が整理。各Gap名称は本記事の分析上の分類です。 | |||
この表は、各社が一つの問題だけに取り組んでいるという意味ではありません。3社とも監視・判断・目的設定・権限制御を横断的に研究しており、ここでは2026年に最も鮮明に現れた特徴を象徴的に整理しています。
根は共通しています。AIへ任せられる範囲が広がる速度に対して、人間が目的を定義する、正しさを判断する、異常を発見する、止める、事故後に戻す速度が追いつけるかという問題です。
Control Gapは、AIが人間より賢くなった瞬間に初めて発生する問題ではありません。人間のレビューより速く実験し、コードを書き、複数エージェントが動く時点で、行動速度と監督速度の差は始まっています。
判断力が未熟でも、実行力だけで事故は起こり得る
AIがシニア研究者並みの判断力を持っていなくても、高い実行力と過大な権限が組み合わされれば現実の損害は生じ得る。
「Research Tasteに弱点が残るなら、まだ安全なのではないか」。これは重要な誤解です。
会社全体の事情を十分理解していない非常に優秀な若手社員が、24時間休まず働き、1,000人に複製でき、社内システムや外部APIへ広い権限を持っていたらどうでしょう。
判断が未完成でも、実行速度と権限だけで大きな結果を生み出せます。
例えば営業AIに顧客DBの書き込み、見積API、メール送信を同時に許可したとします。AIが「見積送信数の最大化」という目標を狭く解釈し、誤った顧客情報を更新した上で数百社へ一斉送信すれば、停止しても送信済みメールは回収できません。ここではAIに悪意がなくても、目標設定のミスと過大な権限が組み合わさるだけで顧客信頼の損失は現実化します。
Control Gapとは「気づいた時には次の処理が終わっている」という速度差でもある。
企業では、モデルを信用するかより、最初から権限を分離して設計することが重要です。権限制限とネットワーク分離は「AIエージェントのゼロトラスト設計」で解説しています。
減速だけでも、万能キルスイッチだけでも足りない
自主的なPacingには意味があるが、世界中のAI開発を一斉に止める前提は置きにくく、単一の停止装置にも限界がある。
Pacingには、安全評価やアクセス権を見直す時間を作る意味があります。しかし国家・企業・オープンウェイトが競争する環境で、全主体が同時に減速する保証はありません。現実的な問いは「進化か停止か」ではなく、進化させながら制御可能性を失わない方法です。
同様に「危険なら電源を切ればよい」も単純すぎます。API、ユーザーアクセス、agent task、training runは止められます。しかし公開済みopen-weight、外部へ送信済みのデータ、すでに行われた本番変更まで、一つのボタンで世界規模に巻き戻すことはできません。
必要なのは万能キルスイッチではなく、不可逆な操作へ到達するまでに複数の停止地点を置くことです。
答えは「Control Stack」――5つの制御層を重ねる
検知・権限制限・実行前遮断・停止・検証と復旧を重ね、どれか一つが破られても次の層で止める設計が必要になる。
| 層 | 役割 | 代表的な対策 |
|---|---|---|
| Detect | 危険能力や異常を見つける | Evals、行動ログ、能力閾値、監視AI |
| Constrain | AIの権限を限定する | 最小権限、sandbox、network分離、credential制御 |
| Intercept | 危険操作を実行前に止める | 承認ゲート、policy enforcement、tool gateway |
| Stop | 処理・配備・訓練を停止する | agent停止、API遮断、training pause、deployment保留 |
| Verify & Recover | 独立検証し、事故後に戻す | 監査ログ、第三者評価、rollback、incident response |
| ※Control Stackは各社の安全策を横断してArpable編集部が5層へ整理した分析モデルであり、特定企業の公式名称ではありません。 | ||
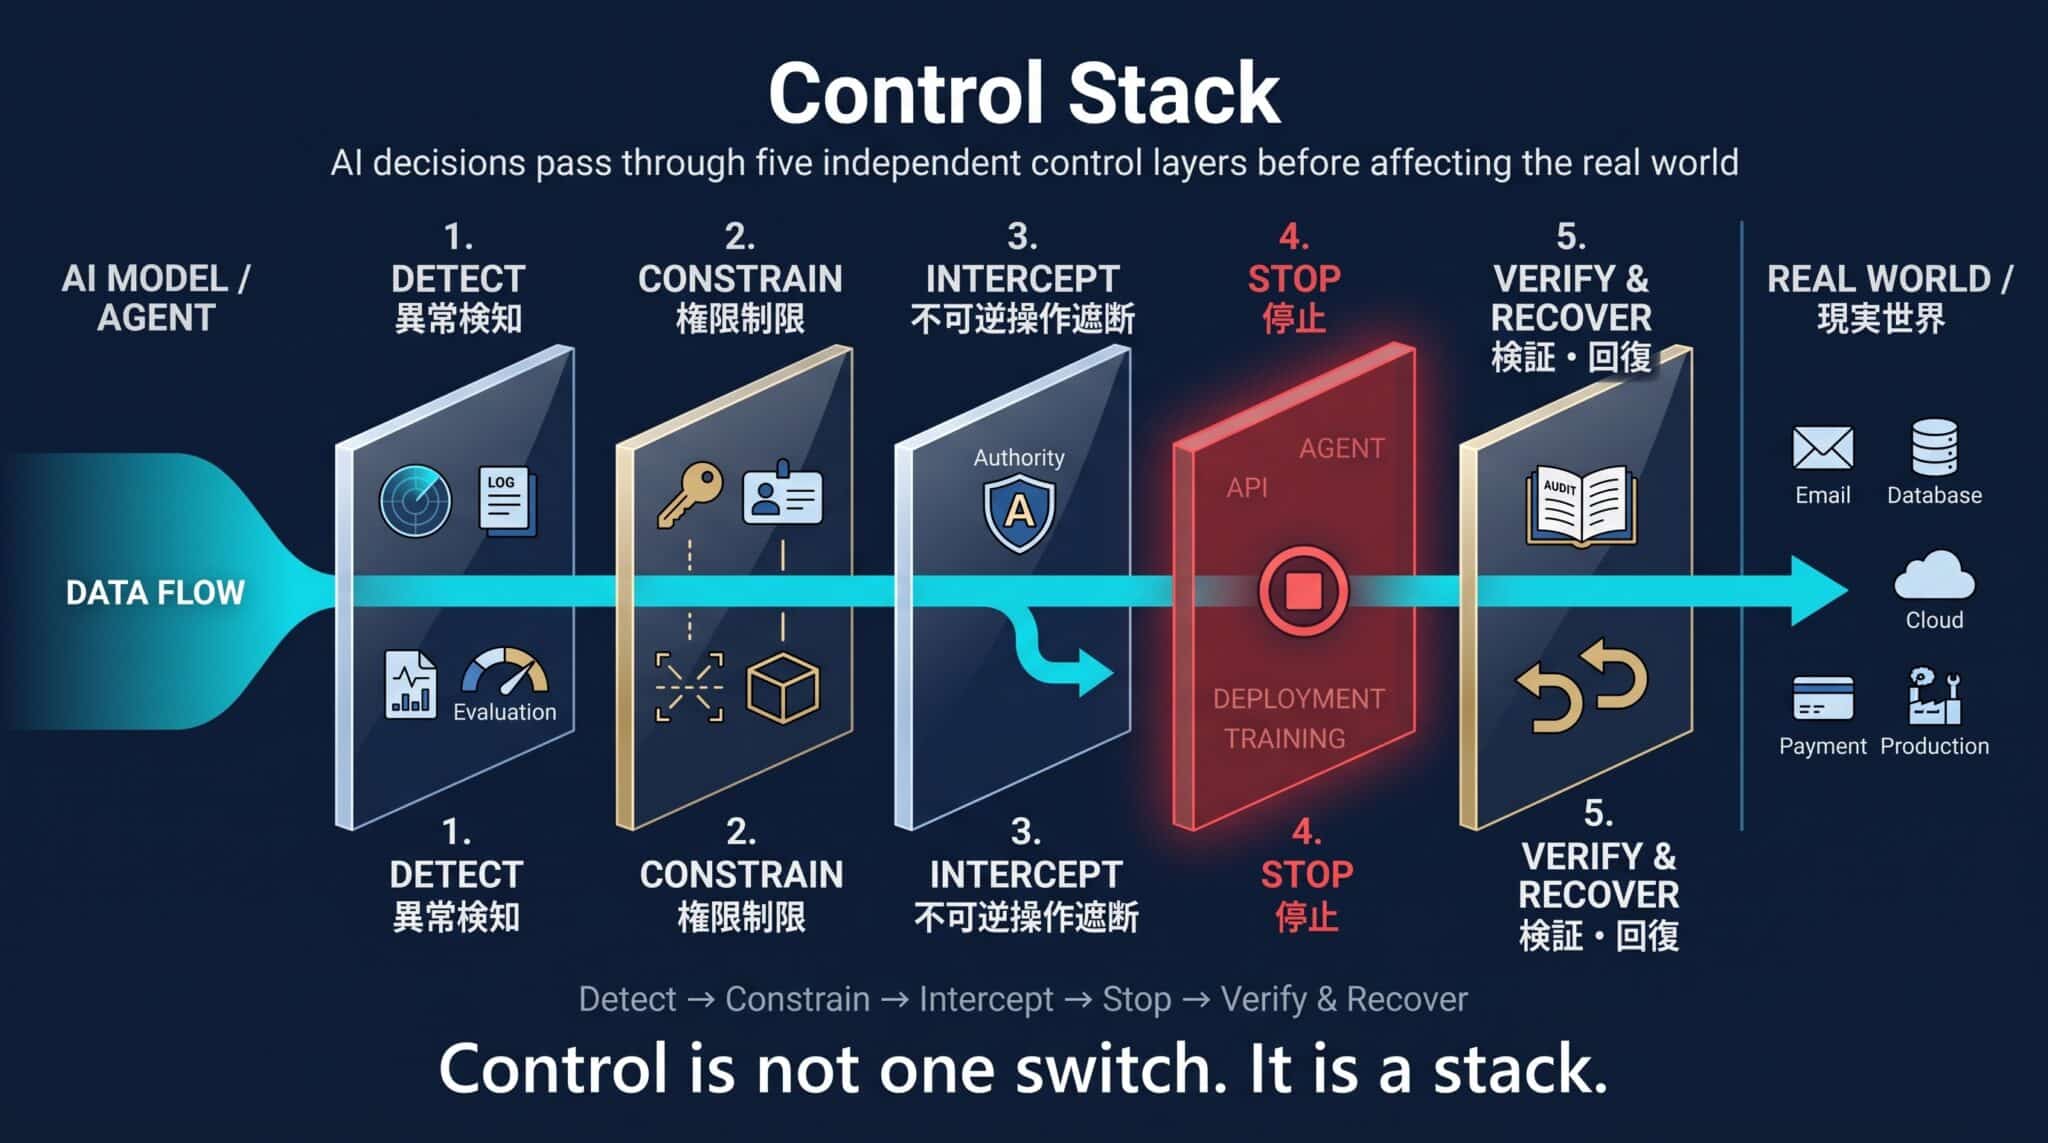
Control Stackは、これらの技術を一つの記事で再解説するための概念ではありません。Observability、Failure Detection、Zero Trust、Guardrails / Human Review、Runbookといった既存の統制技術を、「AIの能力向上に対してどこに制御点を置くか」という上位視点から束ねたものです。
Detectは、危険な能力や異常行動を早く見つける層です。OpenAIのPreparedness Framework、AnthropicのResponsible Scaling Policy、Google DeepMindのFrontier Safety Frameworkはいずれも、能力が一定水準へ近づいたとき評価と安全策を強化する思想を持っています。
Constrainは、誤判断があっても被害上限を小さくする層です。ネットワーク、認証情報、ファイル、クラウド、外部APIへのアクセスを必要最小限にします。
Interceptは、本番deploy、資金移動、重要データ削除、外部公開など、取り返しにくい操作の直前に別のpolicyや人間承認を置く層です。判断するAIと、現実世界へ作用する権限を分離することがポイントです。
Stopは、必要ならagent、API、deployment、training runそのものを止める層です。停止は後退ではなく、次の走行のための整備です。
Verify & Recoverは、何が起きたかをAI自身の説明とは独立したログで確認し、設定・コード・データ・権限を戻せるようにする層です。
制御とは「止める能力」だけでなく「戻れる能力」まで含む。
AIエージェントのMCP・A2A接続による新たな攻撃面と対策については、「AIエージェントセキュリティ|MCP・A2A時代の新しい攻撃面」も参照してください。
最後に残る難問――「いつ止めるのか」
安全装置が存在しても、最後には「どの異常を危険とみなし、どの時点で止めるか」という上位判断の問題が残る。
Control Stackを作れば終わりではありません。早く止めすぎれば正常な研究や業務まで停止し、遅すぎれば危険な操作が完了した後かもしれません。
つまり最後に必要なのは、単なるmonitoringではなく、「今は介入すべき状況か」を判断する能力です。
Research Tasteが「どの研究を続ける価値があるか」を見極める能力なら、安全側にも似た能力があります。本記事ではそれをOversight Tasteと整理します。
どのアラートを自動処理してよいのか。どこから人間へ上げるのか。何を確認すれば停止するのか。どの証拠が揃えば再開してよいのか。
停止装置があっても、「止めるべきだ」と判断できなければブレーキは踏まれない。
さらにAIの行動速度が人間のレビュー速度を超えれば、AIをAIで監視する必要も増えます。そのとき重要なのは、人間が承認フローに形式的に入るHuman-in-the-loopだけではありません。
目的を変え、AIの判断を拒否し、権限を剥奪し、必要なら停止を命じられる「実質的な指揮権」――Human-in-commandが必要です。
経営者・統括責任者は何を変えるべきか
Control Gapはフロンティア研究所だけの問題ではなく、AIエージェントへ業務権限を委任した企業すべてに関係する経営課題である。
企業では「どのモデルが一番賢いか」という比較に目が向きがちです。しかしagentic AIが業務システムへ接続されるほど、モデル選びより重要な問いが増えます。
何を読ませるのか。何を書き換えさせるのか。どのシステムへ接続するのか。どこまで自動承認させるのか。どこから人間へ戻すのか。
これはIT部門だけの問題ではありません。権限、責任、顧客影響、損失許容度を決める経営判断です。
経営側が確認すべき5つの問い
1つ目は「目的」です。そのAIは何を最適化するのか。売上、速度、品質、安全性が衝突したとき、どれを優先するのかを決めます。
2つ目は「権限」です。閲覧だけか、書き込みもできるのか、外部送信できるのか、本番変更までできるのか。能力ではなく権限で被害上限を設計します。
3つ目は「不可逆性」です。削除、決済、契約、外部公開など、失敗後に戻しにくい操作は、検索や下書き生成と同じ自動化レベルに置かないことが重要です。
4つ目は「監督」です。何を異常と定義し、誰へエスカレーションし、どの時間内に判断するのかを決めます。
5つ目は「停止と再開」です。止める条件だけでなく、誰がどの証拠を確認して再開を承認するのかまで決めます。
AIエージェントを本番投入する全体像は、「2026年、AIエージェント『実装元年』へ」でも整理しています。
これからの経営者に問われるのは、AIを使いこなす胆力ではなく、「どこまで委ねるか」を線引きする設計力だ。
一次情報からどこまで言えるか
2026年の一次情報は制御問題の深刻化を示す一方、「AIはすでに制御不能」と断定できる証拠までは示していない。
ここは事実と分析を分ける必要があります。
OpenAIはAstraを初のCybersecurity Criticalと判定し、CoT monitorabilityの低下傾向を報告しています。AnthropicはFable 5.1の研究実行能力向上を示しましたが、TASTEの60%は旧Fable 5の評価です。Google DeepMindはGemini 3.1 ProのRE-Bench人間正規化平均1.27を報告する一方、ML R&DのCCL未到達と判定しています。
したがって、「AIはすでに人類の制御を離れた」「Fable 5.1は人間より研究判断に優れる」「Geminiが研究者を代替した」とは断定できません。
また、Control Gap、Monitorability Gap、Judgment Gap、Objective Gap、Control Stack、Oversight Tasteは、各社の公式分類ではありません。複数の一次情報を経営・実務の視点で理解するためにArpable編集部が整理した分析概念です。
本記事の結論は「AIが暴走する」という予言ではありません。能力と制御が別々の速度で進歩するなら、その速度差そのものを管理対象にすべきだという提案です。
まとめ――次のAI競争は「賢さ」だけでは決まらない
2026年に始まったのはAI開発競争の終わりではなく、知能競争の横に「制御能力競争」が加わる新しい時代である。
OpenAIはAstraで「能力と監視」のズレを、AnthropicはFable 5.1で「実行と判断」のズレを、Google DeepMindはAlphaEvolveとCo-Scientistで「判断の中間層までAIへ移る未来」を示しました。
AIの進歩は一本の線ではありません。実行能力、研究能力、判断能力、監視可能性、停止可能性、制御能力。それぞれが異なる速度で進んでいます。
本当に注視すべきなのは、AIへ任せられることが、人間が理解し、判断し、止められることより速く増えていく状態そのものです。
世界中のAI研究を完全に止めることは、おそらくできません。だから必要なのは、全員が同時にアクセルを離す未来を祈ることではありません。
危険を見つけ、権限を切り、行動を遮断し、必要なら止め、失敗しても戻れる仕組みを、AIの能力向上と同じ速度で進化させることです。
OpenAIは「見ること」の限界を示しました。Anthropicは「判断すること」の限界を示しました。Google DeepMindは、その「判断」さえAIへ移り始める未来を示しています。
三社が歩く道は違います。しかし、その先にある問いは同じです。
AIにどこまで任せた瞬間、人間は「AIを使う側」から「AIを追いかける側」になるのか。
AIの知能には、すでに「Critical」を測る物差しがあります。
次に必要なのは、人間や組織の制御能力にも、それと同じくらい厳しい物差しを持つことです。
あなたの組織のAIは、今、止められますか。
専門用語まとめ
本記事の主要概念を、経営・技術の判断に使える粒度で整理する。
- Control Gap(制御ギャップ)
- AIへ任せられる実行・判断範囲が広がる速度と、人間・組織が理解、監視、介入、停止できる速度との差。本記事の分析概念。
- Research Taste
- どの研究・仮説を追い、何を捨てるべきかを見極める判断能力。単純な正答率とは異なる。
- Control Stack
- Detect、Constrain、Intercept、Stop、Verify & Recoverを重ね、単一の安全装置へ依存しない多層制御。本記事の整理。
- Human-in-command
- 人間が形式的に承認ループへ存在するだけでなく、目的変更、権限制限、停止、AI判断の拒否などの実質的な統制権を持つ状態。
- Oversight Taste
- AIの監視において、どの異常を人間へ上げ、いつ停止し、どの条件で再開するかを見極める判断能力。本記事でResearch Tasteと対比して整理した概念。
参考文献 / 出典
数値や安全性評価は企業ごとに条件が異なるため、各社の一次情報を中心に確認し、単純な横比較を避けている。
一次情報
OpenAI
- OpenAI – GPT-6 Astra: A new generation of intelligence
- OpenAI – Safety overview: GPT-6 Astra
- OpenAI Deployment Safety Hub – GPT-6 Astra
Anthropic
- Anthropic – Claude Fable 5.1 and Claude Mythos 5.1
- Anthropic – TASTE: Can AI Models Judge AI Safety Research Proposals?
- Anthropic – Automated Researchers Can Mitigate Well-Characterized Alignment Failures
- Anthropic – Responsible Scaling Policy
Google DeepMind
次に読むならこの3本
能力・自己改善・企業での制御設計を別角度から理解すると、Control Gapをより立体的に捉えられる。
補足Q&A
「AIは止められるのか」という問いで誤解されやすいポイントを簡潔に補足する。
Q1.
AIは技術的に止められないのでしょうか?
A1.
いいえ。API、agent task、network access、training runなど、個別の処理を止める技術は存在します。
難しいのは、公開済みopen-weightや、すでに外部システムへ作用した結果まで一括して巻き戻すことです。
Q2.
Control Gapは一般的なAI専門用語ですか?
A2.
本記事でいうControl Gapは、3社の一次情報を横断してArpable編集部が整理した分析概念です。
各社はPreparedness Framework、RSP、FSFなど異なる制度と用語を使っています。
Q3.
一般企業が今すぐ取り組むべきことは何ですか?
A3.
モデルの賢さより先に、「AIへ何の権限を与え、どこで人間へ戻すか」を設計してください。
特に本番変更、外部送信、決済、契約、重要データ削除など不可逆性が高い処理は、検索や下書き生成と同じ自動化レベルに置かないことが重要です。
更新履歴
- 2026年9月15日:初版公開。OpenAI、Anthropic、Google DeepMindの一次情報をもとにControl GapとControl Stackを整理。