※本記事は継続的に最新情報へアップデートしています。
工場で、いつもと違う音がする。作業員は設備を撮影し、AIに「どこを点検すればよい?」と尋ねる。AIが映像と音声を確認し、マニュアルと照らし合わせて異常の可能性を教えてくれたら、仕事はどう変わるだろうか。
これまで別々だった「見る」「聞く」「読む」を、一つの文脈で結びつける。それがマルチモーダルAIである。
画像を読めるAIは、もう珍しくない。この1〜2年で、音声や動画まで含めて状況を理解できるモデルが加わり、使える場面が広がっている。
本記事では、マルチモーダルAIの仕組み、生成AIとの違い、ChatGPT・Gemini・Claudeの特徴、企業での活用事例を初心者向けに解説する。
マルチモーダルAIとは、文章・画像・音声・動画など、異なる種類の情報を組み合わせて理解・処理するAI技術です。モデルによっては、画像や音声などの生成にも対応します。
- 従来との違い:文章だけでなく、写真を見たり、音声を聞いたり、動画を分析したりできる。
- できること:図表の読み取り、会議の内容整理、動画検索、画像を使った業務支援など。
- 主なサービス:ChatGPT、Gemini、Claudeなど。ただし、対応する入力・出力形式はモデルによって異なる。
- 注意点:画像や音声の誤認識、処理費用、個人情報や著作権への配慮が必要。
最大の特徴は、異なる情報を関連づけ、人間の判断に必要な材料を増やせることです。
マルチモーダルAIとは?一枚の図で理解する
マルチモーダルAIは、文章・画像・音声・動画など、異なる形式の情報を組み合わせて理解するAIである。
マルチモーダルAIの「モーダル」は、モダリティ(Modality)に由来します。モダリティとは、情報の種類や表現形式のことです。
例えば、人間は写真を見れば、その場に何があるかを理解できます。音を聞けば、誰かが話していることや、機械が普段と違う音を出していることに気づきます。さらに文章を読めば、状況を詳しく理解できます。
マルチモーダルAIは、このように異なる種類の情報を組み合わせて処理するAIです。
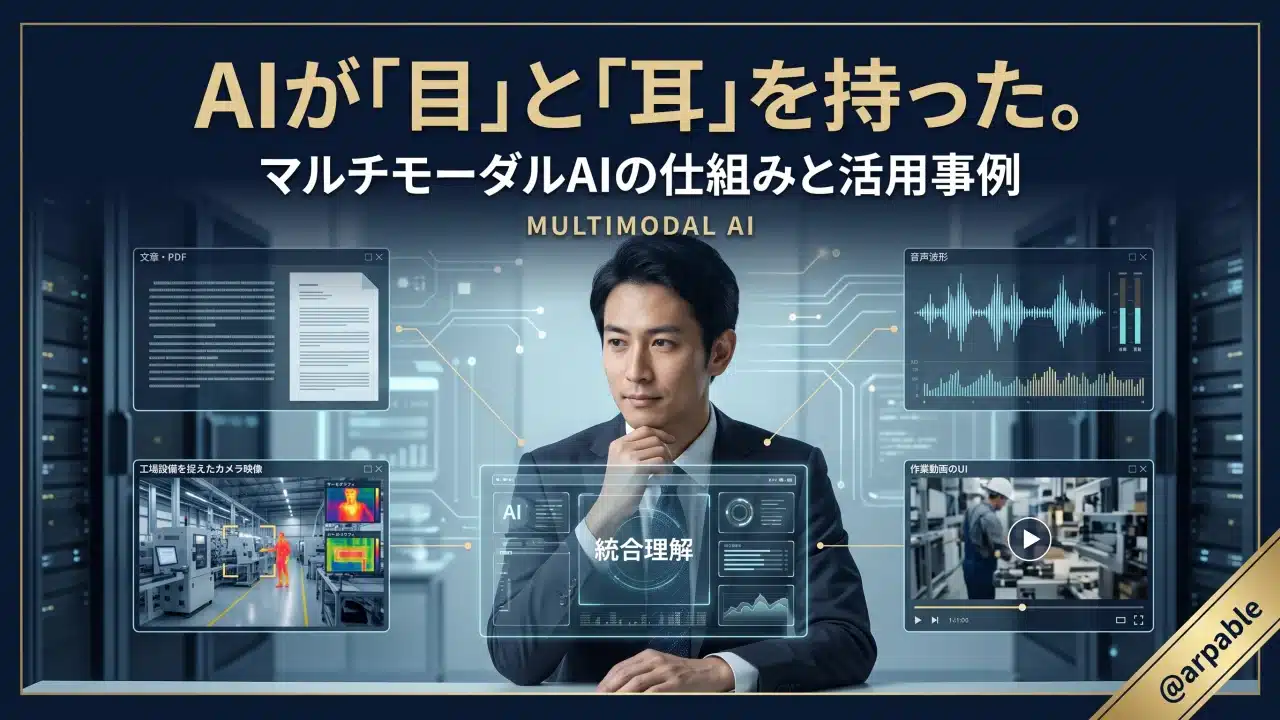
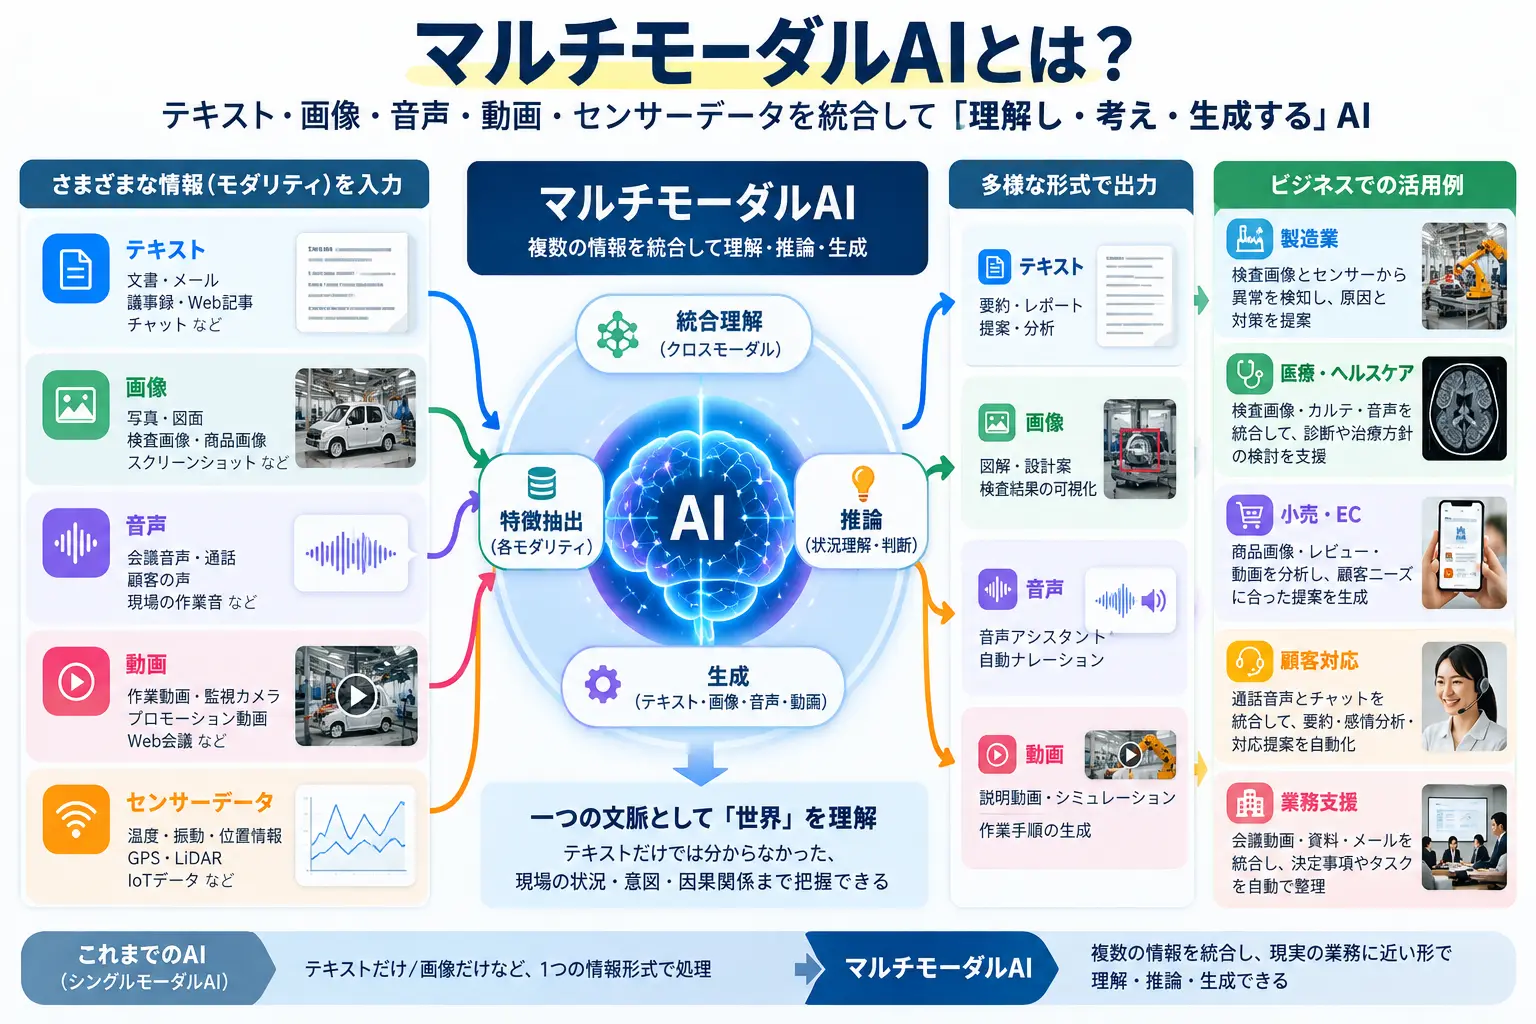 図1|マルチモーダルAIの仕組み。文章・画像・音声・動画を関連づけて理解し、状況の説明や判断支援につなげる(Arpable編集部作成)
図1のように、例えば設備の写真と点検マニュアルを組み合わせれば、AIは写真に写った装置の状態を文章の基準と照合し、不備の可能性を説明できます。
音声と動画を扱えるモデルなら、研修映像を見ながら「安全手順を説明している場面はどこ?」と質問することもできます。
すべてのマルチモーダルAIが文章・画像・音声・動画を全部扱えるわけではありません。対応する情報の種類はモデルによって異なります。
従来のAI・生成AIとは何が違うのか
従来のAIとの大きな違いは扱える情報の種類にあり、生成AIとは技術を分類する観点が異なる。
マルチモーダルAIを理解するために、まず「シングルモーダルAI」と比較してみましょう。
シングルモーダルAIとの違い
シングルモーダルAIは、基本的に一種類の情報を扱うAIです。文章を分析するAI、画像を分類するAI、音声を文字に変換するAIなどが代表例です。
これに対してマルチモーダルAIは、複数種類の情報を組み合わせて扱えます。
これまでのAIは、「目だけの専門家」と「耳だけの専門家」が別々の部屋で仕事をしていたようなものです。マルチモーダルAIは、その全員を同じ会議室に集め、互いの情報を突き合わせて判断するイメージです。
| 比較項目 | シングルモーダルAI | マルチモーダルAI |
|---|---|---|
| 扱う情報 | 基本的に一種類 | 複数種類 |
| 具体例 | 音声を文字に変換する | 映像と音声を組み合わせて内容を説明する |
| 得意なこと | 特定形式の情報処理 | 異なる情報の関連づけ |
例えば、人間が料理をするとき、レシピの文字だけではわからないことがあります。完成写真を見ると盛り付けが理解でき、動画を見ると包丁の動かし方がわかります。
文字・写真・動画を組み合わせることで、理解できることが増える。マルチモーダルAIの価値も、この考え方にあります。
生成AIとマルチモーダルAIは別の分類
ここで混同しやすいのが「生成AI」との違いです。
生成AIは、新しい文章や画像、音声などのコンテンツを作るAIです。一方、マルチモーダルAIは、複数種類の情報を扱う能力に着目した呼び方です。
つまり、生成AIは「何をするか」、マルチモーダルAIは「どんな情報を扱うか」という違いがあります。
両方の特徴を持つAIもあります。写真を読み取って文章で説明するAIもあれば、文章と画像を組み合わせて新しい動画を作るAIもあります。
「画像を理解できる」と「画像を生成できる」は別機能です。動画を分析できることと、動画を生成できることも同じではありません。
この点を理解しておくと、AIサービスを選ぶときに機能を誤解しにくくなります。
マルチモーダルAIは何ができる?
製品名ではなく実際の仕事を出発点に、写真・文章の照合、会話の整理、動画検索、リアルタイム対話などの用途を紹介する。
あなたの職場で、写真や録音、動画のまま眠っている情報はありませんか。マルチモーダルAIは、そうした情報を業務で活用するための選択肢になります。
写真や図表を見て、文章で説明する
マルチモーダルAIのわかりやすい用途は、写真を見せて質問することです。
例えば、製品の写真と取扱説明書を一緒に渡し、「この部品の取り付け方に問題はありますか?」と質問します。AIは写真と文章を照合し、確認すべき箇所を説明できます。
また、グラフや図表を含む報告書を読み取り、重要なポイントを文章にまとめることも可能です。
写真の小さな文字や複雑な位置関係を誤って解釈することがあります。AIによる説明は確認の出発点であり、必ずしも最終的な正解ではありません。
会話を聞いて、必要な情報を整理する
音声を扱うAIも大きく進歩しました。会議の音声を文字起こしするだけでなく、議論の要点や決定事項を整理する用途が広がっています。
例えば営業会議で、顧客から出た要望、次回までの宿題、担当者の発言を整理するといった使い方です。
さらに、リアルタイム音声対話に対応するAIでは、利用者がAIの発話を途中で遮って質問し直したり、AIが短い相づちを返したりするなど、従来より自然なやり取りが可能になっています。
AIの役割は、声を文字に変えるだけでなく、会話を仕事に使える情報へ整理することへ広がっています。
長い動画から必要な場面を探す
動画理解は、ここ1〜2年で実用性が高まってきた用途の一つです。
例えば2時間の研修動画から、「作業前の安全確認について説明している部分を探して」と依頼します。対応モデルであれば、映像と音声を分析し、関連する場面や内容を提示できます。
動画を分析する際には映像のフレームを間引いて処理する場合があり、短時間の動きや細かな変化を見落とす可能性があります。
動画を読み込ませれば、すべての瞬間を正確に把握できるわけではありません。重要な作業の確認には、人間による映像の再確認が必要です。
リアルタイムに状況を理解する
さらに、カメラと音声を組み合わせた対話も進化しています。
例えば、作業者がカメラを設備へ向けながら質問し、AIが映像から状況を説明するような使い方です。スマートグラスや現場支援システムとの組み合わせも期待されています。
リアルタイム映像・音声を同時に扱えるかどうかは、モデル、アプリ、API、通信環境によって異なります。
写真や図表の読み取り、音声対話、動画の内容理解は、すでに実用化が進んでいます。一方、設備の映像・異音・センサー値を組み合わせ、重要な保守判断まで一貫して支援する仕組みは、個々の用途に応じた検証と安全性の確認が欠かせません。
では、こうした機能を実際に利用するには、どのAIサービスを選べばよいのでしょうか。次に、ChatGPT・Gemini・Claudeの違いを、入力できる情報と出力できる情報の観点から整理します。
ChatGPT・Gemini・Claudeはどう違う?
主要AIサービスはいずれも画像理解に対応するが、音声・動画の理解や生成機能は、モデルと専用ツールによって異なる。
マルチモーダルAIを試すなら、ChatGPT、Gemini、Claudeが代表的な選択肢です。
ここで一つ注意があります。普段使っているサービスで利用できる機能と、その裏側のAIモデルが直接対応している機能は、必ずしも同じではありません。
例えば、ChatGPTで画像生成ができても、文章を理解するGPTモデル自身が画像を描いているとは限りません。別の画像生成モデルやツールが処理している場合があります。
| サービス | 代表的な特徴 | 確認したい違い |
|---|---|---|
| ChatGPT / OpenAI | 文章・画像の理解、音声対話、画像生成などを製品群として提供 | ChatGPT製品とAPIでは利用モデルが異なる。音声対話や画像生成は専用モデル・機能が担う |
| Gemini / Google | 文章・画像に加え、音声・動画を直接理解できるモデルを提供 | 理解モデルと画像・動画生成モデルは区別が必要 |
| Claude / Anthropic | 文章・画像・図表・PDFの理解と文章生成 | 音声・動画の直接入力や画像生成は、公式モデル仕様上、対応機能として案内されていない(2026年10月時点) |
| 出典:OpenAI、Google、Anthropicの公式モデル・APIドキュメント。アプリとAPI、契約プラン、提供地域で利用可能な機能は異なります。 | ||
OpenAI:画像理解と音声対話を組み合わせる
OpenAIは、文章・画像を扱うGPTモデルと、リアルタイム音声対話を担うGPT-Live系を組み合わせて提供しています。製品としてのChatGPTとAPIでは利用可能なモデルや機能が異なるため、用途ごとに公式仕様を確認する必要があります。
例えば、写真を見せて説明を求める使い方と、音声で自然に会話する使い方では、内部で使われるモデルや処理方式が異なる場合があります。
画像生成も専用モデルが担当するため、製品全体の機能とモデル単体の機能を分けて理解することが重要です。
Google:動画や音声を含む情報理解に強み
GoogleのGeminiには、文章・画像だけでなく、音声や動画を入力して理解できるモデルがあります。
例えば、長い動画の内容を質問したり、映像と音声を組み合わせて情報を整理したりする用途です。
画像生成や動画生成には、Nano Banana系やVeoなどの専用モデルも使われます。
そのため、動画を「理解する」用途と、動画を「作る」用途を区別して選ぶ必要があります。
Anthropic:画像や文書を読み解く用途
AnthropicのClaudeは、文章・画像・PDFなどを入力し、文章で分析・説明する用途に対応しています。
例えば、複雑な報告書の図表を整理したり、画面のスクリーンショットを読み取って説明したりする仕事です。
一方、Claudeの現行モデルでは、音声・動画の直接入力や画像生成は公式モデル仕様に対応機能として記載されていません。
モデル選びでは「どのAIが最強か」ではなく、自分の仕事で何を入力し、何を出力したいかを先に決めることが大切です。
LLM全体の選定方針については、LLMモデル比較・選定ガイドでも詳しく整理しています。
企業ではどう使われている?関連技術から統合活用まで
企業活用は、画像・音声を個別に使う業務支援から始まり、複数データを組み合わせるマルチモーダル活用へ広がっている。
では、「見る・聞く・読む」力は、実際の仕事でどこまで使われているのでしょうか。現在は、画像や音声を個別に使う業務支援が先行し、複数の情報を統合する活用は実運用と検証が並行しています。以下では、その段階の違いがわかる事例を紹介します。
冒頭で紹介した、設備の異音を聞き、映像やマニュアルと照合する場面。現場での実用化は、そこへ向かう途中にあります。日立の取り組みは、その一歩として保守前後の写真を比較する技術検証です。音声・映像まで組み合わせた一連の点検が実現済みという意味ではありません。
事例1|Albertsons:写真から青果の品質を確認
業界:小売・物流
利用技術:Google Cloudの視覚AI・Geminiを活用した品質評価システム
導入段階:一部の物流施設で実運用(2026年5月の発表時点)
確認できる成果:品質評価の一貫性向上に役立つとの初期評価。定量的な成果は未公表。
米国の小売企業Albertsons Companiesは、青果の品質評価を支援するAIシステムを導入しています。
イチゴやブドウなどの画像を使い、自社の品質基準に照らして評価します。AIが品質スコアや確認候補を提示し、検査員の判断を支援する仕組みです。
同社は、初期の結果として、品質評価の一貫性を高めるのに役立っていると説明しています。具体的な数値は公表されていません。
ポイント:写真を使った品質確認は、視覚AIの実務活用を理解しやすい事例です。ただし、画像を中心とする処理を、複数モダリティの同時統合と混同しないことが重要です。
事例2|日立:保守前後の写真から不備を確認
業界:製造・設備保守
利用技術:Gemini Enterpriseを活用した画像照合・確認支援
導入段階:技術検証(PoC、2025年10月の発表時点)
確認できる成果:保守写真から不備の候補をアラートとして提示できることを検証。定量的な成果は未公表。
日立製作所と日立パワーソリューションズは、設備保守の現場でAIを活用する取り組みを進めています。
例えば、電気設備で電流を遮断する「真空遮断器」の保守前後の写真をAIが比較し、ボルトの向きや配線の不備、部品の取り忘れなどを確認します。
従来は作業員が写真とチェックリストを照らし合わせて確認していた工程を、AIが補助する考え方です。
ポイント:写真と保守基準を照合することで、人間の確認作業を支援します。公表された取り組みは技術検証段階であり、本番導入済みと混同してはいけません。
事例3|JCHO北海道病院:会話からカルテの下書きを作成
業界:医療
利用技術:音声認識、院内の生成AI環境、電子カルテ連携
導入段階:実証(2026年1月の発表時点)
確認できる成果:実証実施の発表を確認。定量的な成果は未公表。
JCHO北海道病院では、診察中の医師と患者の会話をAIで文字化し、電子カルテの下書きを生成する取り組みが進められています。
音声認識で会話内容をテキストへ変換し、院内の生成AI環境でカルテ用の文章に整理する仕組みです。
この取り組みは、厚生労働省のモデル医療機関調査支援事業に採択された実証として発表されています。
ポイント:診察中の会話を業務文書へ変換する実践例です。ただし、音声認識と文章生成を組み合わせた構成であり、単一モデルによる直接的なマルチモーダル統合とは限りません。
複数データを組み合わせる応用も研究が進む
さらに、トヨタ車体と伊藤忠テクノソリューションズ(CTC)は、2025年10月から2026年3月までを研究期間とする共同研究を発表しました。製造現場のセンサー値、検査画像、動画、作業記録などを組み合わせるマルチモーダルAIエージェントを研究対象としています。
このような仕組みでは、設備の温度や振動だけでなく、作業の映像や熟練者の記録も合わせて分析することで、品質管理や技能継承への応用が期待されます。
研究成果や本番運用への移行については、2026年10月時点の調査資料では確認できていません。共同研究の発表を、効果実証済みの事例として扱わないことが重要です。
マルチモーダルAIの本領は、一つの情報だけでは見えなかった状況を、複数の情報を組み合わせて把握することにあります。
画像と言語を組み合わせるモデルについて詳しく知りたい方は、VLMの仕組みと主要モデルの解説をご覧ください。
導入前に知っておきたい注意点と始め方
マルチモーダルAIを安全に活用するには、誤認識、処理コスト、個人情報、著作権を理解し、小さな業務から試すことが重要である。
AIは画像も音声も間違える
マルチモーダルAIは便利ですが、万能ではありません。写真が暗かったり、文字が小さかったりすると、内容を誤って読み取ることがあります。
例えば、設備の型番に含まれる「8」と「B」、あるいは「0」と「O」は、画像の状態によって紛らわしくなります。これはOCR(光学文字認識)でも知られる課題であり、AIに画像を読ませる場合にも注意が必要です。
音声も同じです。周囲が騒がしい場合や複数人が同時に話した場合、発言内容を間違える可能性があります。
さらに、異なる情報を組み合わせた結果、実際には存在しない内容を、もっともらしく説明する場合があります。
AIが写真や音声を理解したように見えても、重要な判断では必ず人間が確認する。これが基本です。
動画や音声は処理費用に注意する
画像や動画をAIへ渡す場合、文章だけを処理する場合よりも、多くの計算資源が必要になることがあります。
高解像度の画像、長時間の動画、リアルタイム音声処理では、API料金や処理時間が大きくなる場合があります。
例えば、2時間の動画をすべて分析させる前に、必要な場面を切り出して渡すだけでも、処理量を減らせることがあります。
必要な情報を、必要な範囲だけAIへ渡すこと。これは費用面でも精度面でも大切な考え方です。
顔・声・個人情報を勝手に送らない
写真には顔や住所が写り込むことがあります。会議の音声には、本人だけでなく、ほかの参加者の発言も含まれます。
企業で利用する場合は、入力する情報に個人情報や機密情報が含まれないか確認してください。
また、AIサービスによって、データの保存期間、学習への利用、アクセス権限、契約条件が異なります。
特に顧客情報、診療情報、社内機密などを扱う場合は、利用規約、保存期間、学習利用の有無、社内ルールを確認してから使用してください。
画像・動画の生成や加工では、著作権、肖像権、人物の同意にも配慮する必要があります。
日本では2026年7月に改正個人情報保護法が公布されたと報告されています。具体的な義務や施行時期は改正内容によって異なるため、業務利用の際は個人情報保護委員会が公表する最新の法令・資料を確認してください。
初心者は、公開情報だけで試してみよう
マルチモーダルAIを初めて使うなら、最初から難しいシステムを構築する必要はありません。
例えば、自分で作成した簡単なグラフや、公開されている製品資料を使い、AIに次のように質問してみましょう。
初心者向けの実践例
「このグラフと説明文を読んで、重要な変化を3つ挙げてください。それぞれの根拠となる数値も示してください。読み取れない部分は推測せず、確認が必要だと教えてください。」
このように、画像と文章を組み合わせて質問するだけでも、マルチモーダルAIの基本的な使い方を体験できます。
次に、AIの説明が正しいかを元の資料と照合します。読み取りを間違えたところがあれば、その理由を考えてみてください。
大切なのは、AIの回答をそのまま信じることではありません。何を正しく理解でき、どこで間違えるのかを自分で確かめる姿勢です。
企業導入を検討する場合も、まず公開情報で効果を試し、必要に応じて社内データへ対象を広げていく方法が現実的です。
さらに、AIが画像や音声から理解した情報を使って実際に作業するようになると、AIエージェントとの連携が重要になります。詳細は、AIエージェントの企業実装ガイドで解説しています。
まとめ|AIは文章の世界から現実の仕事へ
マルチモーダルAIは、人間が見たり聞いたりして判断してきた情報をAIでも組み合わせて扱えるようにし、仕事の可能性を広げる技術である。
冒頭の工場の場面を思い出してください。これまでは人間が、設備の様子を見て、異音を聞き、マニュアルを読み、その情報を頭の中で結びつけていました。
マルチモーダルAIは、その作業の一部を支援できる場面が増えてきました。写真と基準書の照合のように実用化が進むものもあれば、設備の映像・異音・センサー値まで束ねた高度な点検のように、個別の検証が必要なものもあります。
文章だけでなく、画像、音声、動画を組み合わせて状況を理解する。そこから必要な情報を整理し、確認すべき箇所を提示する。これは、従来のAIよりも現実の仕事に近い使い方です。
もちろん、すべてをAIに任せられるわけではありません。誤認識もあれば、処理費用や個人情報の問題もあります。
だからこそ、最初から万能なAIを求めるのではなく、自分の仕事で、どの情報を組み合わせれば役に立つのかを考えることが重要です。
AIが目と耳を持つ時代。問われるのは、AIに何を見せ、何を判断させ、人間がどこで責任を持つかです。
補足Q&A
マルチモーダルAIの意味、生成AIとの違い、身近な利用方法について簡潔に整理する。
Q1. マルチモーダルAIとは何ですか?
文章・画像・音声・動画など、異なる種類の情報を組み合わせて扱うAIです。例えば、写真と説明文を照合して内容を説明したり、映像と音声を使って動画の内容を整理したりできます。
Q2. マルチモーダルAIと生成AIは何が違いますか?
生成AIはコンテンツを作る能力、マルチモーダルAIは複数種類の情報を扱う能力に着目した分類です。両方の特徴を持つAIもあります。
Q3. マルチモーダルAIは無料でも試せますか?
無料プランで画像理解などを試せるサービスがあります。ただし、利用できるモデル、画像・音声・動画の機能、回数制限はサービスや時期によって異なります。
参考文献 / 出典
技術仕様と企業事例について、AI開発企業の公式資料、導入企業の公式発表、公的機関の資料を中心に参照した。
- OpenAI|Images and vision
- OpenAI|GPT-Live 1 Model
- OpenAI|API Deprecations
- Google|Gemini API Models
- Google|Video understanding
- Anthropic|Vision
- Anthropic|PDF support
- Anthropic|Claude Opus 5.5
- Albertsons Companies|AI-Powered Supply Chain Tool(2026年5月13日)
- 日立製作所|Google Cloudとの戦略的アライアンスを推進し、フロントラインワーカーの業務変革を加速(2025年10月10日)
- NTTドコモビジネス|JCHO北海道病院でAIカルテ下書き実証開始(2026年1月19日)
- CTC|トヨタ車体とマルチモーダルAIエージェントを活用した品質管理の共同研究を開始(2025年12月2日)
- 個人情報保護委員会|生成AIサービスの利用に関する注意喚起(2023年6月2日)
- 文化庁|AIと著作権に関するチェックリスト&ガイダンス
※製品の機能、提供状況、対応する入力・出力形式は2026年10月時点の公開情報を基準に整理しています。サービス・プラン・APIによって利用条件は異なります。公開前には各社公式ページで最新の提供状況を確認してください。
更新履歴
記事の対象読者と構成、主要技術・企業事例の更新内容を記録する。
- :初心者向けに全面再構成。図解、生成AIとの違い、主要サービス比較、企業事例、導入時の注意点を更新。
- :企業戦略・ROI・導入設計を中心に2026年版へ改版。