※本記事は継続的に最新情報へアップデートしています。
AIを使うにはクラウドへ接続する。そんな常識が、変わり始めている。
2026年10月7日、MicrosoftとNVIDIAが示したのは、AIエージェントがPCの中で働く新しいコンピューティングの姿である。最大128GBの統合メモリを備える構成では、120B(1,200億パラメータ)を超えるAIモデルのローカル実行を掲げるPCが登場し、WindowsもAIが仕事を進める実行基盤へ進化しようとしている。
この変化は日本企業にも無関係ではない。NTTのtsuzumi、楽天のRakuten AI、SB IntuitionsのSarashina、Preferred NetworksのPLaMoなど、日本語向けの小型モデルはすでに国内で開発されてきた。今回変わりつつあるのはモデルそのものではなく、それらを動かす「PC側の受け皿」が大きくなったことである。
AIインフラは巨大なデータセンターだけのものではなくなるのか。PCがAIの実行拠点になるとき、企業の設備投資、情報管理、人間とAIの仕事の分担はどう変わるのか。
✅ 先に結論
MicrosoftとNVIDIAの新しいAI PC構想は、PCをクラウドAIの利用端末から、AIモデルとAIエージェントが働く実行拠点へ進化させるものである。
- PCがAIインフラになる:RTX Sparkは最大128GBの統合メモリを備え、従来は高性能サーバーが必要だった規模のAIをWindows PCへ持ち込む。
- 既存SLMの活用余地が広がる:国内にはすでに複数の小型日本語モデルが存在する。PC側のメモリと実行基盤が強化されれば、1台のPCに複数のモデルを用意し、仕事に応じて使い分ける構成も現実味を増す。
- 企業の判断基準が変わる:重要なのは高性能PCの購入ではなく、どのAIに、どの仕事を、どこで、どこまで任せるかという設計である。
- 発売日と価格:RTX Spark搭載ノートPCは10月16日から出荷予定。日本ではSurface Laptop Ultraが税込51万3,480円から、128GB構成は税込109万4,280円と報じられている。
ただし、最大性能はメーカー公称値であり、モデルごとの実行速度、業務品質、企業向け管理機能は個別の検証が必要となる。
AIが手元のPCで働く時代へ――10月7日、何が変わったのか
MicrosoftとNVIDIAの発表は、AIの計算能力をPCへ持ち込み、WindowsをAIエージェントの実行環境へ進化させる取り組みである。
こんな朝を想像してみてください。会社のPCを開くと、昨夜依頼した資料の整理が終わっている。社内の技術資料から必要な情報が抽出され、比較表が作られ、確認すべき項目まで並んでいます。
しかも、作業の一部は外部のAIサービスではなく、PCの中で処理されている。そんな働き方を実現しようとする動きが、いま始まっています。
2026年10月7日(米国時間)、MicrosoftとNVIDIAは、AIエージェント時代のWindows PCに向けた製品と構想を発表しました。中心となるのが、NVIDIAの「RTX Spark」とMicrosoftの「Hybrid Intelligence(ハイブリッド・インテリジェンス)」です。
これは単なる高性能ノートPCの発表ではありません。人間がアプリを操作するPCから、AIも仕事を実行するPCへ、その役割を広げる動きです。
RTX Spark――120B級のAIを手元で動かす
RTX Sparkは、NVIDIAのBlackwell RTX GPUとGrace CPUを組み合わせた、Windows PC向けのコンピューティング・プラットフォームです。CPUとGPUを高速に接続し、最大128GBの統合メモリを共有できる点が、従来のGPU単体製品と大きく異なります。
| 項目 | メーカー公称仕様 | 実務上の意味 |
|---|---|---|
| CPU | Grace CPU、最大20コア | Windowsと通常アプリを実行 |
| GPU | Blackwell RTX、最大6,144 CUDAコア | AI推論とGPU処理を支援 |
| AI性能 | 最大1 PFLOPS(FP4) | 低精度演算の理論ピーク値 |
| 統合メモリ | 最大128GB LPDDR5X | CPUとGPUで共有し、大規模モデルを保持する余地 |
| CPU・GPU接続 | 600GB/s | 両プロセッサ間の高速通信 |
| OS | Windows 11 on Arm | 業務アプリとドライバの互換性確認が必要 |
| ※出典:NVIDIA公式製品情報・発表資料(2026年10月8日時点)。最大構成の公称値であり、機種ごとに異なる。1 PFLOPSは実際の文章生成速度を保証する数値ではない。メモリ帯域の数値は本表に含めていない。 | ||
特に注目したいのは最大128GBの統合メモリです。Microsoftは、RTX Spark搭載のSurface Laptop Ultraについて、最大128GB構成で120Bを超えるAIモデルをローカル実行できると訴求しています。
統合メモリは、新しい種類のメモリそのものを意味する言葉ではありません。 RTX Sparkでは、DRAMの一種であるLPDDR5XをCPUとGPUが同じメモリプールとして共有します。一般的なディスクリートGPU搭載PCでは、CPUが使うシステムメモリとGPU専用VRAMが分かれていますが、RTX Sparkではその境界をまたいで大きな共通領域を使えることが、大規模モデルをPCへ持ち込める理由の一つです。
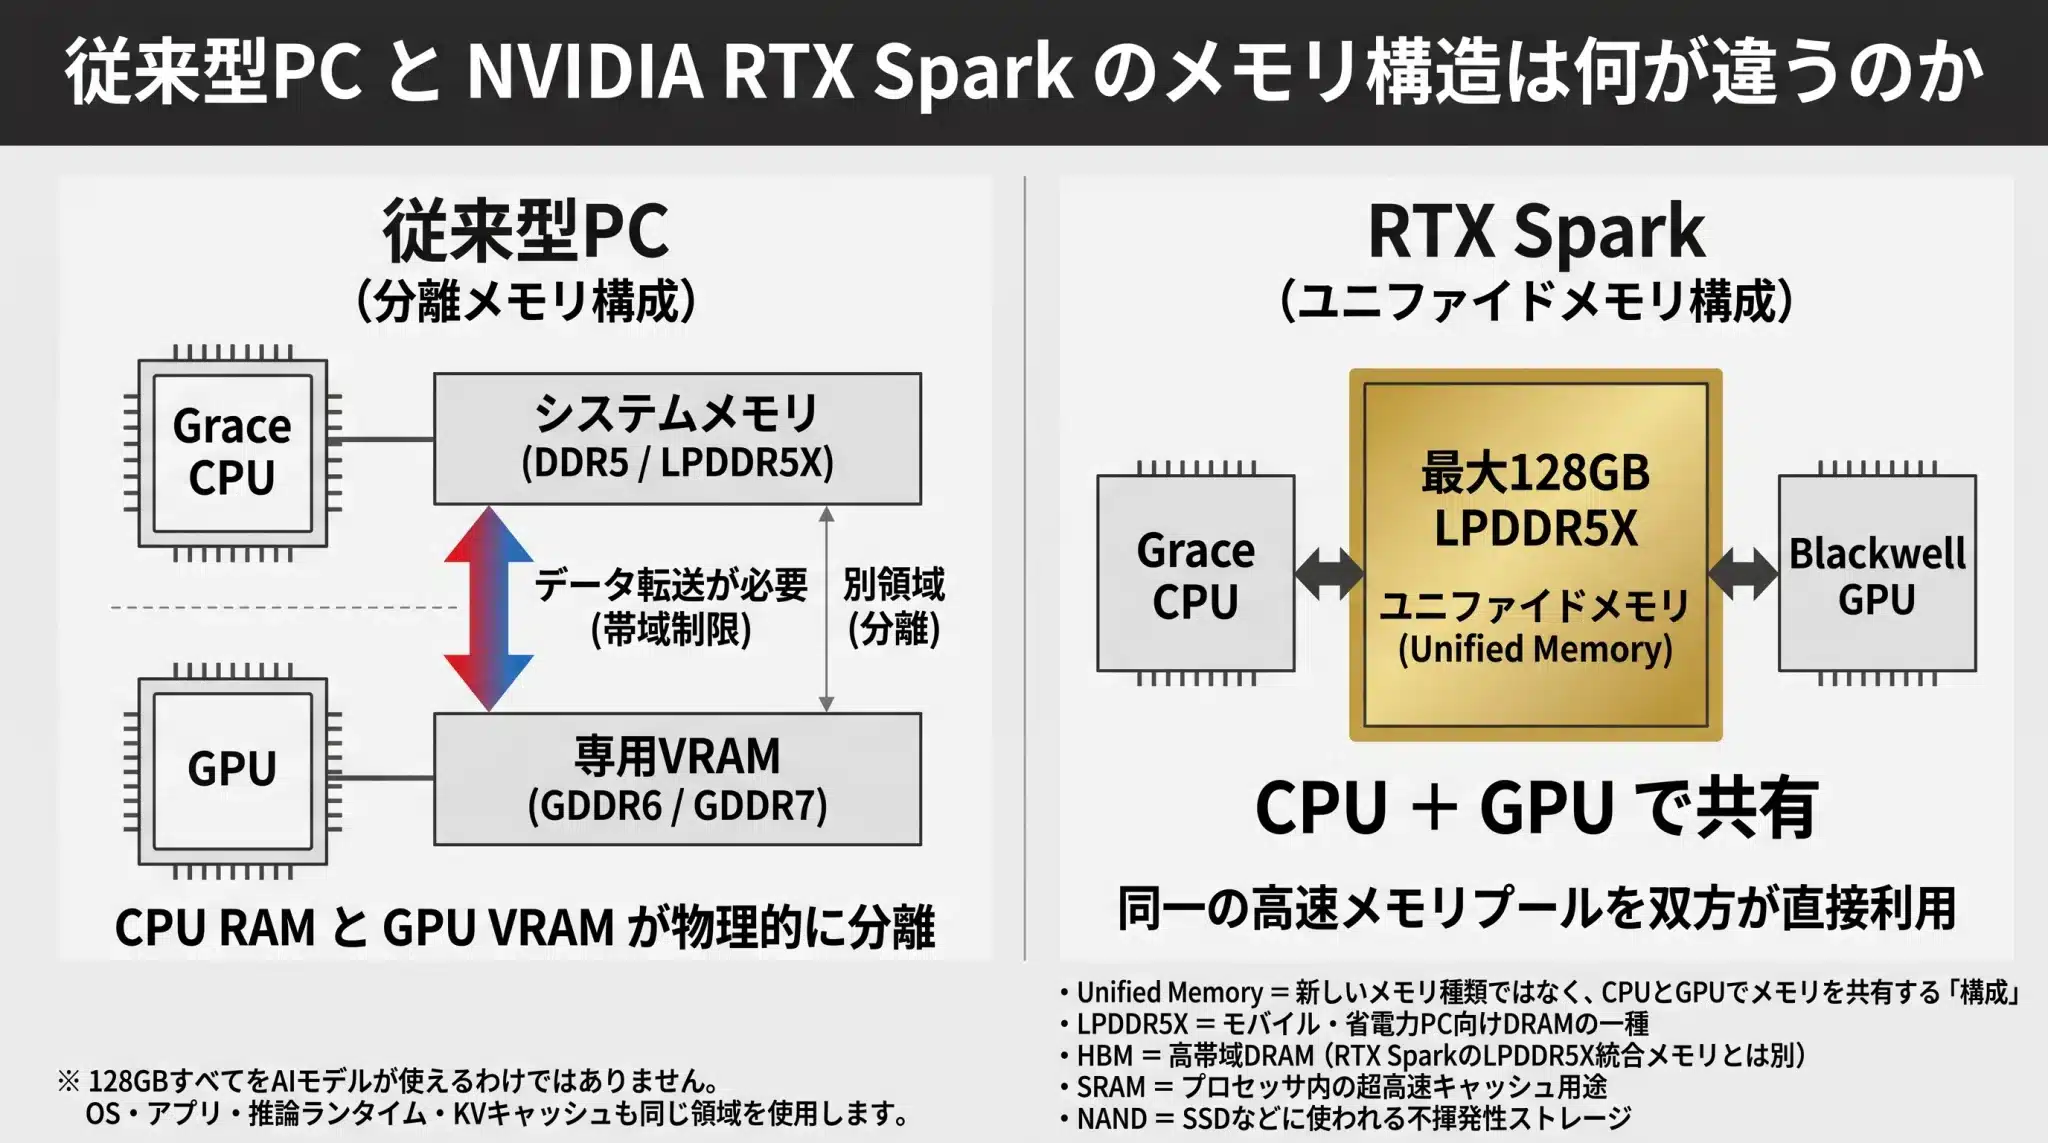
ただし、128GBすべてをAIモデルが占有できるわけではありません。Windows、アプリ、推論ランタイム、KVキャッシュなども同じメモリ領域を使います。また、LPDDR5XはAIサーバーGPUで使われるHBMと同じものではなく、容量だけで実際の推論速度を判断することはできません。
モデルの大きさと実用速度は別問題です。量子化方式、推論ソフトウェア、利用可能なメモリ、コンテキスト長によって、動作条件も応答速度も変わります。メーカーの理論性能から、快適な文章生成速度を直接判断することはできません。
そして大容量メモリの価値は、120B級モデルを一つ載せられることだけではありません。 小型モデルなら複数を用意し、要約、分類、社内検索、コード支援など、仕事に応じて使い分ける構成も考えられます。
日本では51万円台から。ただし120B超は上位構成
RTX Spark搭載ノートPCは10月7日に予約を開始し、10月16日から出荷される予定です。ASUS、Dell、HP、Lenovo、Microsoft、MSIなどが対応し、小型デスクトップの展開も予定されています。
Surface Laptop Ultraの国内価格は、24GBメモリ構成で税込51万3,480円からです。一方、120Bを超えるモデルの実行を想定する128GB構成は、個人向けが税込109万4,280円(Microsoft Store限定)、法人向けが税別99万800円と報じられています(PC Watch、2026年10月8日)。
同じRTX Spark搭載PCでも、24GB機と128GB機を同じ条件で評価してはいけません。
さらにNVIDIAは、最大748GBのコヒーレントメモリを備える「DGX Station for Windows」も打ち出しています。最大1兆パラメータ級のモデルを扱う構想ですが、10月8日時点ではWindows版はプレビュー段階で、公式価格も未公表です。
RTX SparkとDGX Stationの構想自体は、2026年5月末~6月初めに先行発表されています。10月7日の転換点は、製品予約とWindows側のエージェント実行機能が具体化し、商用展開へ進んだことです。
NVIDIAが広げようとしているのは、PCの性能だけではありません。AIを動かす場所そのものです。
PCがAIインフラになる――クラウドだけに頼らない新しい構造
個人PC、部門共有AI基盤、クラウドを仕事に応じて使い分けることで、企業のAIインフラは分散・階層化していく可能性がある。
従来、企業が生成AIを利用するときは、クラウド上のモデルへ問い合わせ、その結果をPCで受け取る構成が一般的でした。もちろんローカルAIは以前から存在しますが、大容量メモリを備えるWindows PCの登場は、その選択肢を大きく広げます。
これからのPCは、クラウドAIを呼び出すための入口であると同時に、自らAIを実行する場所にもなります。
PCそのものが、企業のAIインフラの一部になる可能性があるのです。
AIインフラは3つの階層へ広がる
この変化を「クラウド対PC」という対立で理解すると、本質を見誤ります。クラウドが不要になるのではなく、AIの処理場所が増えるのです。
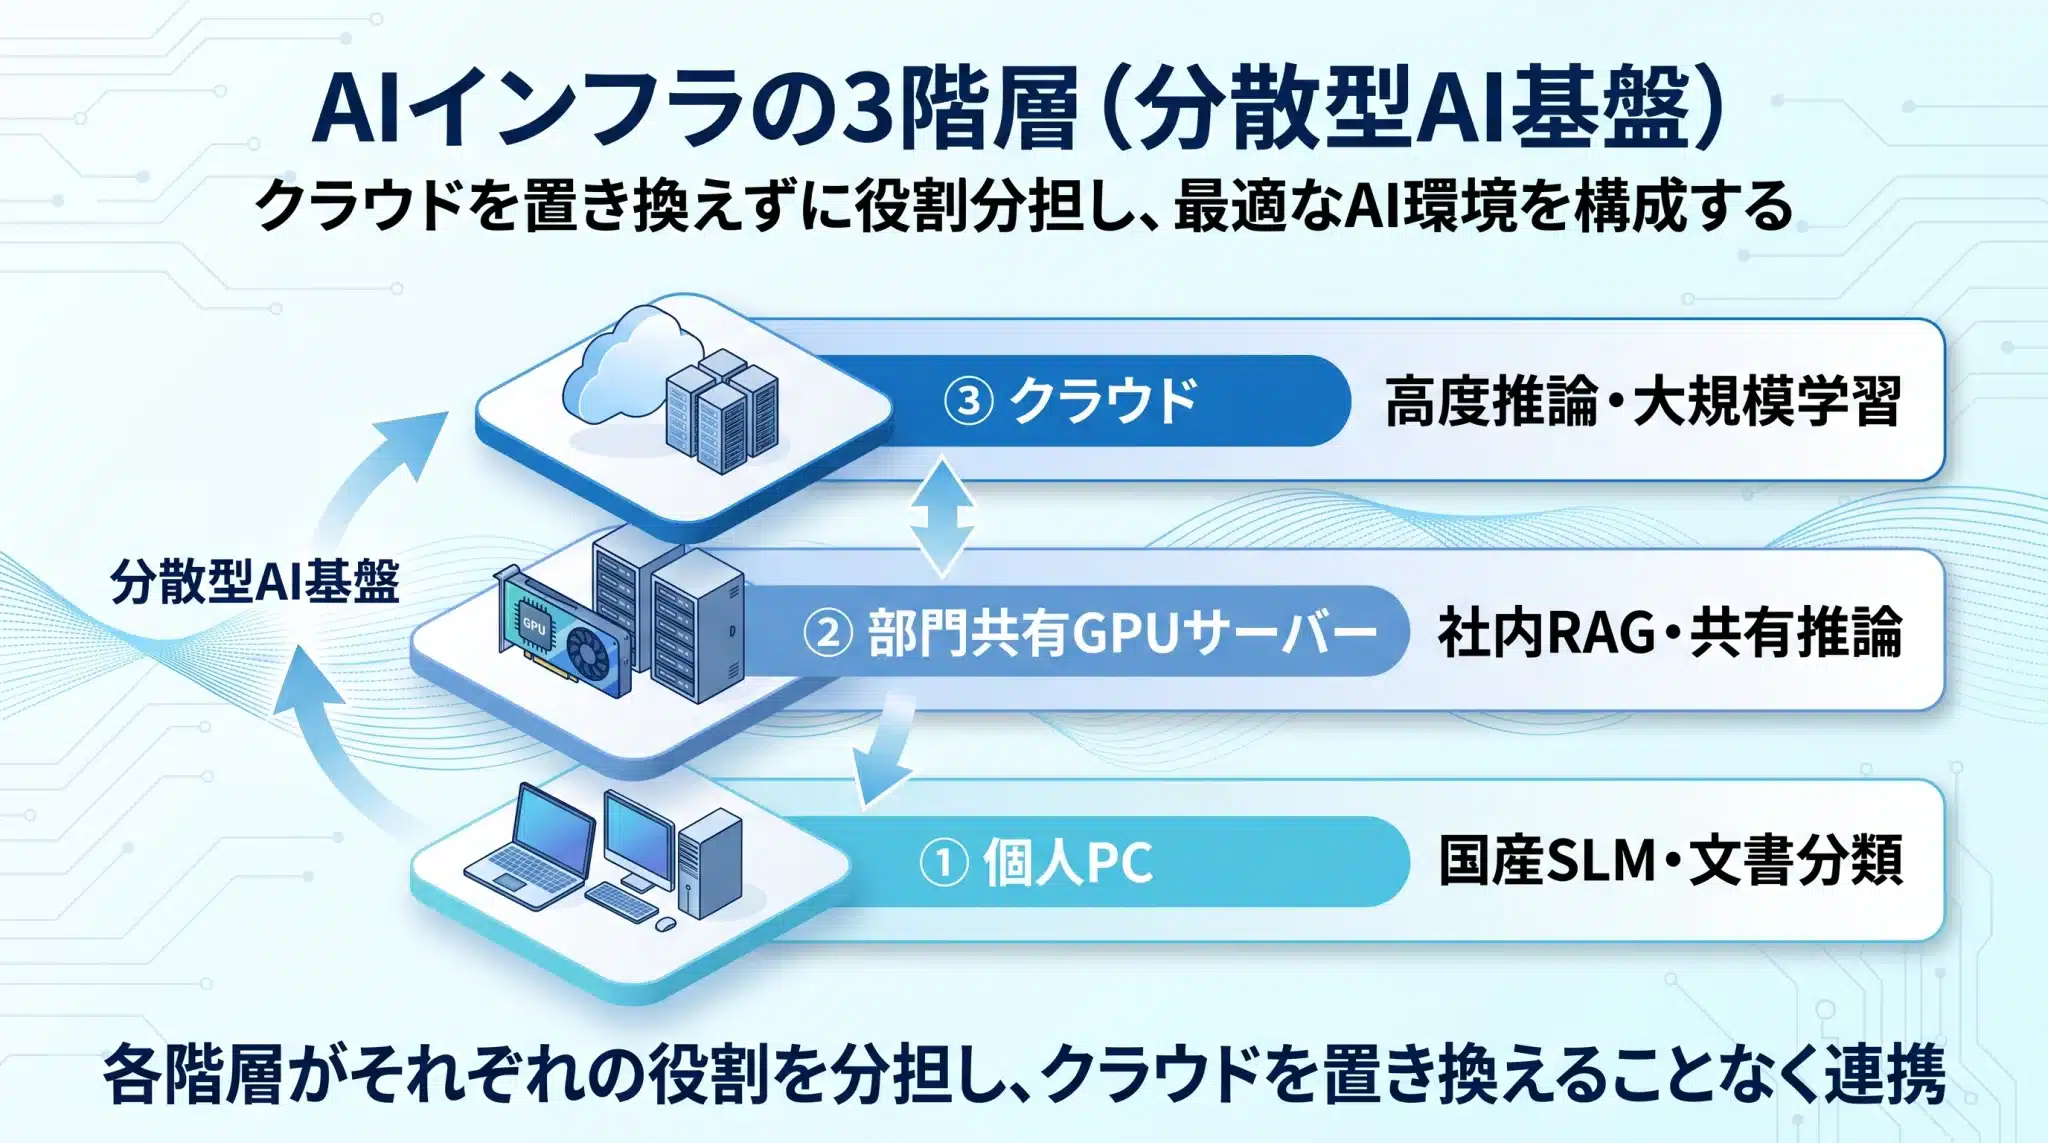
社員のPCは個人や小さな業務の推論を担当し、部門のGPUサーバーは共有処理を引き受け、クラウドは高度な推論や大規模計算を担います。仕事の性質によって、実行場所を選ぶ構造へ向かうと考えられます。
例えば、毎日の文書分類はPCで実行し、部署全体のナレッジ検索は共有サーバーに置き、複雑な推論だけをクラウドへ送る。すべてを巨大なシステムへ集中させる必要はありません。
一方、処理が分散するほど、モデルの配布、更新、端末管理、権限設定、監査の重要性は高まります。中央のAIインフラは、計算を引き受けるだけでなく、分散したAIを管理する役割も担うようになるでしょう。
Hybrid Intelligence――PCとクラウドの役割分担
Microsoftが掲げる「Hybrid Intelligence」は、ローカルAIとクラウドAIを組み合わせ、タスクに適した場所で処理する考え方です。
PC内の機密文書の整理はローカルで行い、高度な推論能力や最新情報が必要な場合はクラウドを使う。得られた結果をPC内の業務アプリへ反映することも考えられます。
重要なのは、すべての処理を一つの場所へ集めることではありません。仕事に応じて、PC内のモデルとクラウドのモデルを使い分けることです。
MicrosoftはGitHub HydraFusionについて、ローカルモデルを含む処理の振り分けを、2026年10月後半に実験的プレビューとして提供する予定です。ただし、10月8日時点ですべてのWindowsアプリが自動的に最適なモデルを選べるわけではありません。
この3階層のどこにAIを置くかという判断が、今後の企業システム設計に加わります。
既存の国産SLMに新しい受け皿――1台のPCで使い分ける時代へ
国産SLMそのものは以前から存在する。今回の変化は、複数の小型モデルを手元のPCへ用意し、用途別に使い分ける実行環境が広がり始めたことである。
ここからが、日本企業にとって特に興味深い話です。国内では、NTTのtsuzumi、楽天のRakuten AI、SB IntuitionsのSarashina、Preferred NetworksのPLaMo、NECのcotomiなど、規模や提供形態の異なる日本語モデルがすでに存在します。
重要なのは、これらが今回新しく登場したことではありません。PC側の実行能力が広がることで、既存のモデルを「仕事に応じて選ぶ」使い方が現実味を増してきたことです。
国内には用途の異なる小型モデルがすでにある
SLM(Small Language Model)とは、比較的小規模な言語モデルのことです。LLMとの厳密な境界はありませんが、規模を抑えることで必要な計算資源を小さくしやすいという特徴があります。
| モデル例 | 規模感 | 用途イメージ |
|---|---|---|
| tsuzumi | 小型〜中型 | 日本語業務、社内文書 |
| Rakuten AI mini | 小型 | 軽量な日本語処理 |
| Sarashina | 小型 | 要約、分類など |
| PLaMo | 小型〜中型 | 日本語業務、長めの文書処理 |
| cotomi | 中型 | 企業業務、社内利用 |
| ※Arpable編集部による用途イメージの整理。実際の業務適性、入手方法、ライセンス、推論速度、提供形態はモデルごとに異なるため、導入時には個別確認が必要。 | ||
国産モデルだから必ず海外製モデルより優れているわけではありません。ここで見るべきなのはモデル名の多さではなく、日本語処理、要約、分類、社内文書など、用途の異なる選択肢がすでに存在していることです。
1台のPCに複数のSLMを置く――小さなAIを使い分ける
小型モデルの利点は、単に「安いPCでも動く」ことだけではありません。モデルが小さければ、1台のPCに用途の異なる複数モデルを用意し、必要なときに切り替えて使う構成も考えられます。
例えば、文書分類には軽量モデル、社内文書の要約には日本語向けモデル、コード支援には別のモデルを使う。さらにRAGを組み合わせれば、社内検索専用のローカルAIを用意することもできます。
「一人に一つの巨大AI」ではなく、「一台のPCに複数の専門AI」という使い方も見えてきます。
例えば、4bit量子化を単純計算すると、1Bモデルの重みは約0.5GB、3Bなら約1.5GB、8Bなら約4GBです。120Bモデルの約60GBと比較すると、大きな差があります。
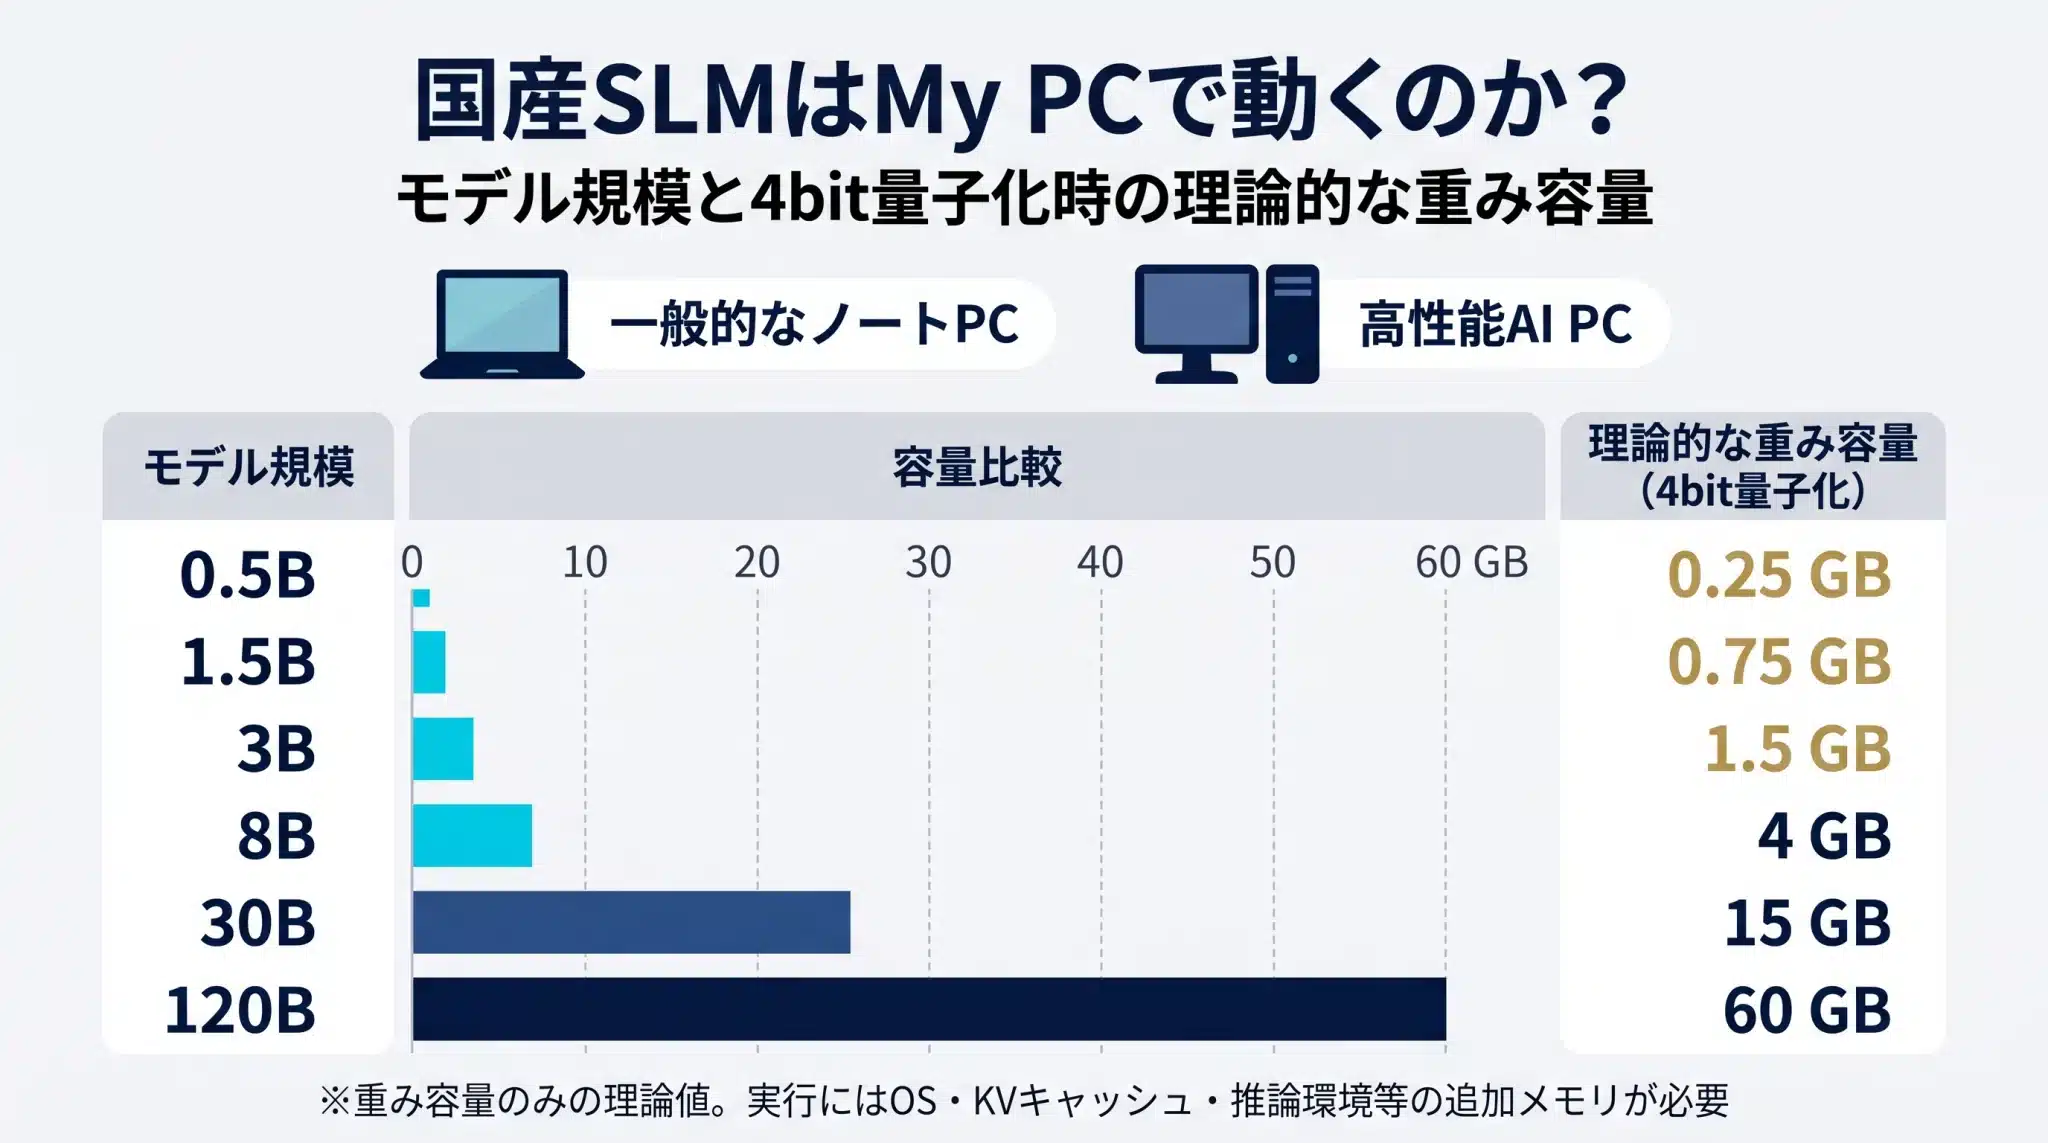
ただし、これはモデルの重みだけを数えた理論値です。実際には量子化の追加情報、OS、推論ランタイム、KVキャッシュなどにもメモリが必要です。大きなモデルを1つ置くか、複数の小型モデルを用途別に配置するかという設計の違いにもつながります。
モデルによっては量子化や利用したい実行ソフトウェアに対応していない場合もあります。PCのメモリに収まることと、仕事に使える速度・品質で動くことは同じではありません。 また、複数モデルを登録して必要時に切り替えることと、複数モデルを同時に常駐・推論させることも同じではありません。同時利用には、モデルの重みだけでなくKVキャッシュや実行時メモリ、同時接続数などを含めた検証が必要です。
My PCの日本語AIに何を任せるか
製造業の技術者が、社外へ送れない設備保守記録を整理したいと考えたとします。ローカルで動作する日本語モデルなら、記録を端末内に置いたまま分類や要約を試せます。
社内の専門用語が多ければ、RAGを組み合わせる方法もあります。ただしRAGには、文書の取り込み、検索用データの生成、検索処理などが別途必要です。小さなモデルを置いただけで、社内知識を自動的に理解するわけではありません。
また、国産SLMの中には商用サービスとして提供されるものもあり、モデルの重みをPCへ自由に配置できるとは限りません。ライセンス、商用利用、提供方式を確認する必要があります。
「My PCで動く」と「My PCで仕事を任せられる」の間には、検証すべき距離があります。
だからこそ、最も大きなモデルを一つ選ぶのではなく、仕事ごとに必要十分なモデルを選び、組み合わせるという発想が重要になります。
1,000件の文書を分類できても、誤分類が多ければ確認作業が増えてしまいます。AIを動かすだけなら成功でも、業務全体では時間や費用が増えるかもしれません。
しかし、少なくともAI活用の第一歩が、必ずしも高価な専用PCや大規模クラウド契約ではなくなる。この変化は、日本企業にとって大きな意味を持ちます。
では、小さなAIを自分のPCで使うことは、企業にとって本当に得になるのでしょうか。次に考えるべきなのは費用対効果です。
モデル規模と選定基準の考え方については、LLMの比較とモデル選定も参考になります。
「AIが無料で働く」は本当か――企業の投資対効果を考える
ローカルAIはクラウドAPIの従量課金を抑えられるが、PC購入費、運用費、確認作業を含む総費用で評価する必要がある。
クラウドAIの利用が増え、トークン料金の予算管理に悩む企業もあるでしょう。「ローカルなら使い放題で無料」という期待は、半分だけ正しいと言えます。PC内で完結する推論には、外部クラウドAPIのトークン課金が発生しないからです。
しかし、AIの利用コストがゼロになるわけではありません。PCの購入費、電力、保守、モデル更新、情報管理、業務システムとの接続に加え、人間が結果を確認する時間も必要です。
さらに、すべてのAI処理をローカルへ移せるわけでもありません。MicrosoftのHybrid Intelligenceも、クラウドを完全に置き換える構想ではなく、処理の性質に応じて使い分ける考え方です。
約109万円のAI PCは高いのか
Surface Laptop Ultraの128GB構成は、個人向けで税込109万4,280円と報じられています。一般的な法人向けPCと比べると高額です。
ただし、毎日大量のコード解析や機密文書の処理を行う開発者なら、ローカル実行による効果が購入費を上回るかもしれません。逆に、月に数回だけAIを利用する社員へ同じPCを配布するのは、合理的でない場合があります。
小型モデルで足りるなら既存PCを使い、大きなモデルが必要ならRTX Sparkを検討する。部門で共有できるならGPUサーバーを使い、高度な推論だけをクラウドへ任せる判断もあります。
AI PCへの投資は、モデルの大きさではなく、実際に任せられる仕事の量と成果で判断すべきです。
費用より先に測りたいもの
最初に決めるべきなのは、「どの仕事をAIへ任せるか」です。例えば帳票の分類、仕様書からの項目抽出、開発コードの確認など、成果を測りやすい業務を選びます。
そのうえで、作業の完遂率、処理時間、人間の修正時間、1件当たりの総費用を比較します。トークン料金だけを減らしても、確認作業が大幅に増えるなら投資効果は乏しくなります。
企業に必要なのは、安いAIを探すことではなく、仕事全体を合理的に終わらせる仕組みです。
AIに仕事を任せて大丈夫か――Windowsが担う新しい安全性
AIエージェントがファイルやアプリを操作する時代には、実行権限、隔離、人間の承認、監査を組み合わせた安全設計が欠かせない。
「古い資料を整理しておいて」とAIに依頼したら、重要な契約書まで削除されてしまった。AIエージェントが実際にファイルを操作する時代には、こうした失敗も想定しなければなりません。
チャットで誤った回答を返すことと、誤った操作でファイルやデータを変更することは、被害の性質が異なります。
AIに仕事を任せるには、何ができるかだけでなく、何をしてはいけないかを決める必要があります。
Microsoft Execution Containers(MXC)とは何か
Microsoft Execution Containers(MXC)は、AIエージェントや生成コードの実行範囲を制御するための仕組みです。開発者や企業は、アクセス可能なファイルやネットワークなどをポリシーで指定します。
例えばコーディングエージェントに、指定した開発フォルダへの操作だけを認め、別の機密フォルダへのアクセスや許可していない通信先を制限する構成が考えられます。
これは「危険な操作をしないで」とAIへ指示するだけの対策とは異なります。モデルの判断とは別の仕組みで、実行できる範囲を狭めることを目指します。
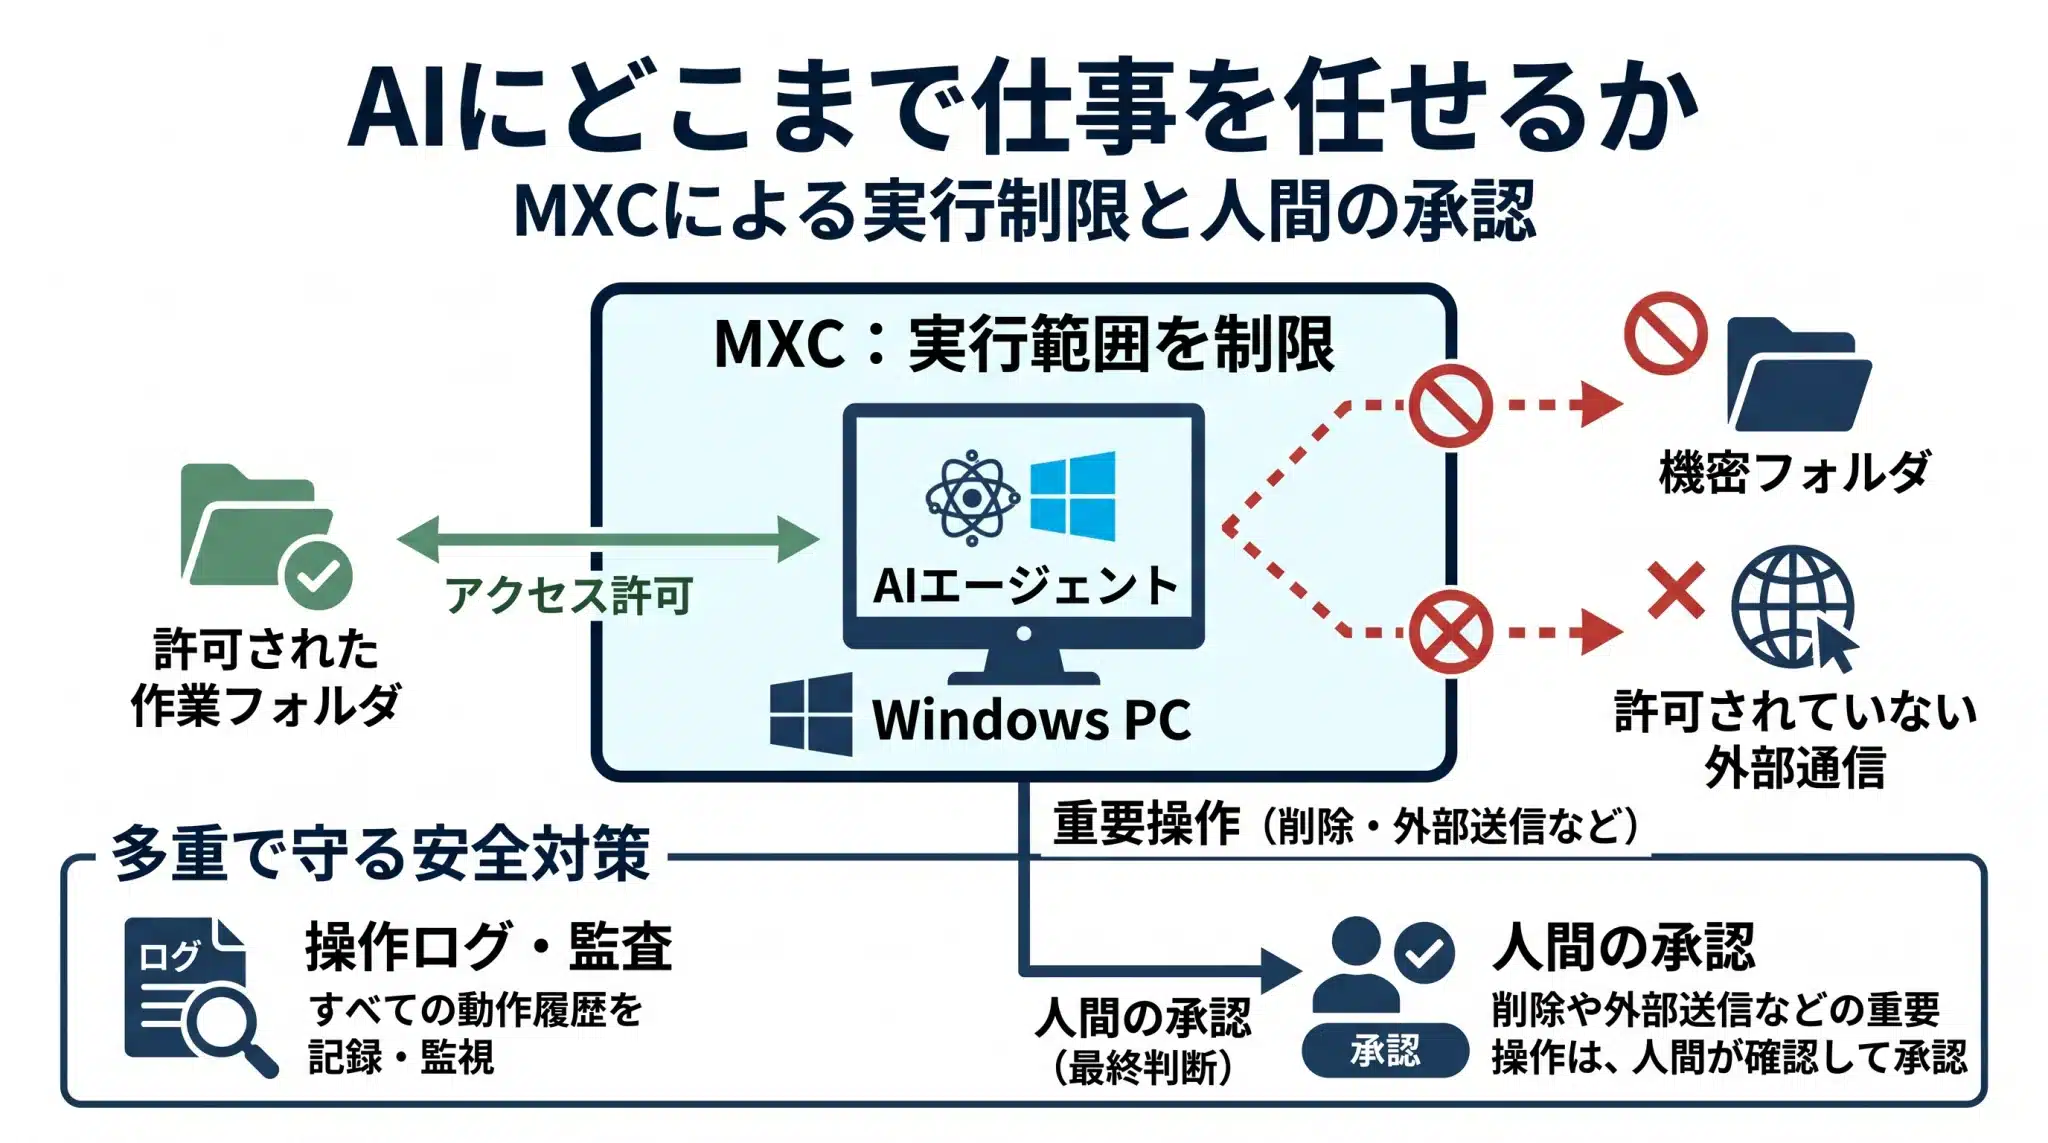
MXCの基本機能は2026年10月7日に一般提供が発表されました。ただし、すべての隔離方式が同じ保護能力を持つわけではありません。また、EntraやIntuneなどと連携する一部の企業向け管理機能は、段階的な提供が予定されています。
「MXC対応」という表示だけで、AIのすべての操作が安全になるわけではありません。
ローカルAIでも情報流出は起こり得る
ローカルAIは、対象データを外部のAIサービスへ送らずに処理できる点が魅力です。しかし、モデルをPC内で動かしても、エージェントに外部通信や広範なファイル操作を許可すれば、情報流出や誤操作の可能性は残ります。
端末の紛失、マルウェア感染、資格情報の漏えいも考慮すべきです。企業はアクセス権限、通信先、操作ログ、復旧方法を管理し、削除や外部送信などの高リスク操作には人間の承認を組み込む必要があります。
さらに、ファイルの読み取りと書き込み、社内通信と外部通信を分けて許可する設計が重要です。最初から広い権限を与えないことが、安全な導入の基本となります。
具体的な権限設計については、AIエージェントのセキュリティと6つの対策も参考になります。
Windowsは「AIが働くOS」になるのか
Microsoftは、CopilotがPC内のファイルや作業状況を利用し、ユーザーの許可を得て操作を進める方向を示しています。ローカルモデルとクラウドモデルを組み合わせ、AIエージェントがWindows上で仕事を進める構想です。
ただし、関連するCopilot機能は今後数か月で段階的に展開される予定です。10月8日時点で、すべてのWindows PCが同じ機能を使えるわけではありません。
AIが働くPCの競争は、どれだけ賢いモデルを動かせるかだけでなく、どこまで安心して仕事を任せられるかという競争でもあります。
AIエージェントの実装と企業統制の全体像は、AIエージェント実装の解説で詳しく整理しています。
日本企業は何から始めるべきか――AI PC導入の新しい判断基準
企業が最初に取り組むべきなのはAI PCの大量購入ではなく、対象業務を絞り、モデル品質、実行場所、総費用、安全性を実測することである。
では、日本企業は何から始めればよいのでしょうか。最初から全社員のPCを買い替える必要はありません。
まず、自社業務の中で、手元のPCへ移せる処理を探します。日常的な文書分類なら小さなSLMで足りるかもしれません。一方、複数システムを横断する複雑な業務には、より高性能なモデルやクラウドが必要になる場合があります。
AIインフラの選定は、製品やモデルからではなく、任せたい仕事から始めるべきです。 仕事を決めてから、必要なモデルを選び、そのモデルをPC、共有サーバー、クラウドのどこで動かすかを決めます。
AIをどこで動かすか――5つの判断ケース
| 業務の特徴 | 最初に検討する環境 | 主な確認項目 |
|---|---|---|
| 小型モデルで足りる定型業務 | 既存PC・一般的なAI PC | メモリ、日本語品質、速度 |
| 大規模ローカルモデルが必要 | RTX Spark等の高性能PC | 量子化、実効速度、冷却 |
| 部門で大量の処理を共有 | 社内GPUサーバー・DGX Station等 | 同時利用、稼働率、運用負荷 |
| 高度推論・最新情報が必要 | クラウドAI | 回答品質、利用料金、送信条件 |
| 処理内容が混在する業務 | ローカル+クラウド | 振り分け、アクセス制御、監査 |
| ※Arpable編集部による実務判断例(2026年10月)。対象業務の品質・機密性・運用条件に応じて判断する。 | ||
小さなPoCで5つの指標を測る
まず、毎週繰り返す報告書の分類や仕様書からの項目抽出など、成果を確認しやすい業務を選びます。そして、ローカルSLMとクラウドAIに同じ仕事を任せて比較します。
- 業務品質:必要な成果物を正しく完成できるか。
- 実行速度:仕事全体の所要時間を短縮できるか。
- 総費用:PC、API、運用、人間の修正時間を含めて合理的か。
- 安全性:外部通信、ファイル操作、権限を制御できるか。
- 既存環境との整合:業務アプリ、Windows on Arm、ドライバ、モデルライセンスに問題がないか。
特にAIエージェントでは、モデルの回答精度だけでなく、仕事の完遂率が重要です。正しいコードを生成しても、誤ったファイルを変更したり、許可されていない操作をすれば、業務全体として成功とは言えません。
小型モデルで十分な品質が得られるなら、既存PCを利用する。性能が不足するならRTX Sparkや共有GPU基盤を検討する。こうした順序なら、設備投資を必要以上に大きくせずに済みます。
企業が購入するべきなのは、最も大きなAIではなく、自社の仕事を安全かつ合理的に完了できる実行環境です。
国内PC・半導体産業への影響
NVIDIAのWindows向けArmプラットフォームの登場は、Intel、AMD、Qualcommなどとの競争にも影響する可能性があります。大容量メモリ、冷却、電源、端末管理、セキュリティなど、PCを支える周辺技術の重要性も高まります。
ただし、特定の国内企業がRTX Spark向け部品を受注したといった事実や、将来の市場シェアの変化を現時点で断定することはできません。
日本企業にとっての機会は部品供給だけではありません。国産SLM、社内RAG、端末管理、モデル最適化、安全な業務連携を組み合わせたソリューションにも可能性があります。
企業AIの導入事例と本番運用の判断については、日本企業のAIエージェント導入事例2026も参考になります。
ここまでが現実、ここからが予定――10月8日時点の整理
RTX Sparkの予約開始やMXCの基本機能提供は確認できるが、Copilotの全面展開、複数SLMのローカル活用、企業での費用削減効果は検証途上である。
新しい技術が発表されたことと、企業が安心して本番導入できることは同じではありません。メーカーの公称能力、すでに提供された機能、これからの計画を区別して判断する必要があります。
| 項目 | 確認できること | 残る確認事項 |
|---|---|---|
| RTX Spark搭載PC | 10月7日予約開始、16日出荷予定 | 製品版の実測性能・構成別条件 |
| 120B超のローカル実行 | Microsoftが128GB構成で公称 | モデル別の量子化・生成速度 |
| DGX Station for Windows | プレビュー段階 | 正式発売日・価格・運用条件 |
| MXC | 基本機能が一般提供 | 隔離方式別の保護範囲・管理連携 |
| Hybrid Intelligence | Microsoftが構想を発表 | 対応アプリ・振り分けの実効性 |
| Copilotの新しいローカル機能 | 今後数か月で段階的に展開予定 | 地域・対応PC・具体的な提供条件 |
| 複数SLMのローカル活用 | 国内には小型・中型モデルの既存選択肢がある | モデル切替、実機速度、同時利用、用途別の業務品質 |
| ※NVIDIA、Microsoft、国内モデル開発企業の一次情報を基にArpable編集部が整理(2026年10月8日時点)。予定は将来の提供を保証するものではない。 | ||
Arpableの見立て――AIインフラの再配置が始まる
Arpable編集部は、今回の発表を企業のAIインフラを考え直すきっかけと捉えています。
これまでのAIインフラは、GPUサーバーをどこに置くか、どのクラウドを採用するかという議論が中心でした。しかし、小さなモデルを一般的なPCで実行でき、大きなモデルも高性能なローカル機で扱えるようになれば、計算資源の配置そのものが変わります。
もちろん、大規模な学習、高度推論、部門共有サービス、モデル配布、監査には引き続き中央のAIインフラが重要です。分散すればするほど、全体を統制する仕組みも必要になります。
AIインフラがなくなるのではありません。AIインフラをどこに配置し、どう役割分担するかが変わるのです。
これは2026年10月8日時点の技術動向から導いたArpableの分析であり、企業の普及速度や市場構造が確定したという意味ではありません。
まとめ――一人に一台のPCから、一人に一つのAIへ
AI PCの進化がもたらす本質的な変化は、企業がAIに仕事を任せる場所と方法を、より柔軟に設計できるようになることである。
かつてPCは、人間が仕事をするための道具でした。しかし今、AIもそのPCで働く時代が始まろうとしています。
NVIDIAはAIを動かす計算能力をPCへ持ち込み、MicrosoftはAIの実行と統制をWindowsへ組み込もうとしています。一方、日本にはすでに、tsuzumi、Rakuten AI、Sarashina、PLaMoなど、小型の日本語モデルという選択肢があります。
新しく生まれたのはモデルではありません。変わり始めたのは、それらのAIを「どこに置き、どう使い分けるか」という選択肢です。
1台のPCに大きなモデルを置く。複数の小型モデルを仕事ごとに使い分ける。部門では共有GPU基盤を使い、高度な推論だけクラウドへ任せる。すべての社員に高価なAI専用PCが必要になるわけではなく、企業は仕事に合わせてAIの配置を考える時代へ入りつつあります。
これから企業に問われるのは、どのPCを買うかだけではありません。どのAIに、どの仕事を、どこで、どこまで任せるかです。
あなたの会社では、最初にどの仕事を手元のPCのAIへ任せられるでしょうか。その答えを探すことが、新しいAIインフラ戦略の第一歩になるのかもしれません。
AIインフラは、巨大なデータセンターだけのものではなくなりつつあります。私たちの手元のPCも、その一部になるのです。
専門用語まとめ
AI PCの構造と企業導入を理解するために、本文の主要用語を簡潔に整理する。
- SLM(Small Language Model)
- 比較的小規模な言語モデル。用途や環境によっては一般的なPCでも実行できる。
- Hybrid Intelligence
- ローカルAIとクラウドAIを組み合わせ、タスクに適した実行場所を選ぶ考え方。
- Microsoft Execution Containers(MXC)
- AIエージェントや生成コードの実行範囲を、ポリシーで制御する仕組み。
- 統合メモリ
- CPUとGPUが同じメモリプールを共有する構成。RTX SparkではLPDDR5Xを使用する。LPDDR5XはDRAMの一種であり、AIサーバーGPUで使われるHBMとは特性が異なる。
- 量子化
- AIモデルの重みなどを低ビット数で表現し、メモリ使用量を抑える技術。
- RAG
- 外部の文書やデータを検索し、取得した情報を参照してAIが回答する仕組み。
参考文献 / 出典
本記事は2026年10月8日時点のNVIDIA、Microsoft、国内モデル開発企業の公式情報と、国内価格に関する報道を基に構成した。
一次情報:NVIDIA・Microsoft
- NVIDIA(2026年10月7日)- NVIDIA, Microsoft Kick Off a New Beginning for Windows PCs with RTX Spark and AI Agents
- NVIDIA – RTX Spark 公式製品情報
- Microsoft(2026年10月7日)- Building Windows for hybrid intelligence
- Microsoft(2026年10月7日)- Microsoft Execution Containers: Policy-driven containment for AI agents
- Microsoft – Surface Laptop Ultra 日本向け公式製品情報
一次情報:国内言語モデル
- NTT(2023年11月1日)- 独自言語モデルtsuzumiの商用サービスについて
- 楽天グループ(2025年2月12日)- 日本語LLMと小規模言語モデルの提供開始
- SB Intuitions(2025年3月7日)- Sarashina2.2-Instructについて
- SB Intuitions – Sarashina2.2-0.5B モデルカード
- Preferred Networks – PLaMo 2 1B モデルカード
二次情報:国内価格
※製品仕様、価格、提供状況は2026年10月8日時点。最大性能はメーカー公称値であり、モデル別の実行速度や業務品質を保証するものではない。将来の市場構造や企業の導入方針に関する記述は、Arpable編集部の分析である。
次に読むならこの3本
ローカルAIの実務をさらに理解するには、AI半導体、AIエージェントの実装、モデル選定の3つの視点が役立つ。
補足Q&A
RTX Sparkと国産SLMのローカル実行について、導入前に確認しておきたい3つの疑問に答える。
Q1.
小型の国産SLMを動かすにはRTX Spark搭載PCが必要ですか?
A1.
必ずしも必要ではありません。
小型モデルなら、メモリや実行ソフトウェアなどの条件が整えば、一般的なPCでも動作する可能性があります。ただし、モデルの入手条件、応答速度、業務品質は個別に確認する必要があります。
Q2.
RTX Sparkなら120B超のモデルを快適に動かせますか?
A2.
128GB構成での実行能力は公表されていますが、快適な速度は保証されていません。
量子化、モデル構造、コンテキスト長、推論ランタイムなどで必要メモリと速度が変わります。24GB構成と128GB構成も区別が必要です。
Q3.
ローカルAIが普及するとクラウドは不要になりますか?
A3.
不要にはなりません。AIインフラの役割分担が変わります。
小さな定型処理はPCで実行できても、大規模学習、高度な推論、部門共有サービス、モデル管理などには引き続き中央のAIインフラが重要です。
更新履歴
本記事の公開履歴。
- 2026年10月8日:初稿投稿