※本記事は継続的に最新情報へアップデートしています。
同じAIモデルが、データセンターでは軽快に動いてもスマートフォンでは遅く重くなる――この落差が示すとおり、AIの競争軸は、巨大なモデルを「学習」させるだけの時代から、学習済みの知能を実際のサービスや現場で何度も使う「推論」まで含めた時代へ広がっている。
問われているのは、単にAIを小さくすることではない。必要な性能を保ちながら、速度、メモリ、計算量、消費電力といった制約の中で、その知能をいかに効率よく届けるかである。
その中核にあるのが、量子化、プルーニング、知識蒸留、効率的アーキテクチャなどを組み合わせる「Efficient AI/モデル最適化」という考え方である。
✅ 先に結論
「学習から推論へ」とは、学習が不要になったという意味ではありません。AI競争の評価軸が、「どこまで賢いモデルを作れるか」から、「その知能を必要な場所へ、必要な速度・品質・電力で届けられるか」まで広がったということです。
- Efficient AIの本質:モデルを単純に小型化するのではなく、必要な性能と計算資源のバランスを最適化すること。
- 技術選定の起点:「どの最適化技術が優れているか」ではなく、「何がボトルネックなのか」から考えること。
- 推論には二つの方向:より長く考えて賢くするReasoningと、同じ知能を速く・軽く届けるEfficiencyは分けて考える必要がある。
はじめに:AIは「学習」から「使う」時代へ
AIの進化は、モデルを賢くする競争から、獲得した知能を現実世界で効率よく使い続ける競争へと広がっている。
これまで、ChatGPTに代表される大規模言語モデル(LLM)など、AI技術の進化は「学習」を中心に、莫大なデータと計算資源への大きな投資によって支えられてきました。「規模のメリット」を最大限に活かし、AIは驚異的な「賢さ」を獲得してきたのです。
しかし今、AI活用の流れは確実に変わりつつあります。学習によって賢くなったAIを、実際に「使う」フェーズ、つまり「推論」に注目が集まっているのです。AIが実際のサービスや業務の中へ入るほど、1回だけ巨大なモデルを学習すること以上に、その知能を何度も安定して利用できることが重要になります。
クラウドの生成AIからPC、スマートフォン、スマートウォッチ、工場のIoT機器、自動車、ロボットまで、AIは「どれだけ賢く学習できるか」だけでなく、その知能をどれだけ速く、軽く、省電力に届けられるかを問われる段階に入っています。
そのため、AIモデルそのものをより小さく、速く、省エネにする「モデル最適化」の重要性が高まっています。本記事では、この大きな変化を「効率的なAIの時代」と捉え、学習から推論へのパラダイムシフトと、その中核となる最適化技術を分かりやすく整理します。
「学習から推論へ」とは何が変わったのか
変わったのは学習の重要性ではなく、AIを評価する範囲が「知能を作る工程」から「知能を届ける工程」まで広がったことである。

上図が示す変化の本質は、単なる「クラウドからエッジへの移行」ではありません。AI競争の重心が、巨大モデルを学習することだけでなく、学習済みの知能を実際の利用環境で効率よく動かす「推論」まで広がったことです。
学習は現在もAIの能力を高める重要な工程です。しかし、モデルがサービス、業務システム、ロボット、スマートフォンなどで利用され始めると、レイテンシ、メモリ、電力、処理量、運用環境といった別の制約が前面に出てきます。
つまり、「学習から推論へ」とは、学習の時代が終わることではなく、AI競争の評価軸が推論まで拡大したことなのです。
なお、学習と推論では演算構造やメモリの使い方、必要なAIチップの性格も異なります。「学習は開発投資、推論は継続原価」という経営面まで含めた違いは、後半のAIチップの章で触れます。
なぜ今、AI効率化が重要なのか
AIが社会へ広がるほど、性能だけでなく、速度・メモリ・電力・通信・運用環境など現実世界の制約が重要になる。
なぜ今、AIの「効率化」、特に「推論」の効率化が重要なのでしょうか。理由は、AIが研究室や巨大データセンターだけの技術ではなく、私たちの生活空間や産業現場、企業のサービス基盤へ広がっているからです。
リアルタイム性の要求
自動運転車が障害物を避ける、工場のロボットアームが製品を正確につかむ、スマートグラスが目の前の情報を表示する――こうした用途では、一瞬の遅れが利用価値そのものを左右します。クラウドとの通信時間も含め、推論全体のレイテンシをどこまで抑えられるかが重要になります。
メモリと計算資源の制約
スマートフォン、ウェアラブル端末、IoTセンサー、ロボットなどのエッジデバイスは、クラウドサーバーと比較して、計算能力、メモリ容量、バッテリーに厳しい制約があります。同時に、クラウド側でも多数の利用者へAIを提供する場合には、同時処理性能やメモリ効率が問題になります。高性能でありながら「燃費の良いAI」をどう作るかは、エッジとクラウドの双方に共通する課題なのです。
プライバシーとセキュリティ
個人の顔情報、健康データ、企業の機密情報などを扱う場合、すべてのデータを外部のクラウドへ送信することが適切とは限りません。必要に応じてデバイス内部や企業拠点内で推論を完結できれば、データの移動範囲を小さくできます。
通信環境への非依存
インターネット接続が不安定な場所や、そもそも接続できない環境でも、ローカル側でAI推論が行えれば活用範囲は広がります。トンネル内の監視、災害現場、移動体、工場などでは、通信品質を前提にしない設計が重要になります。
電力と運用効率
AIが社会のあらゆる場面で利用されるほど、「瞬時の判断」だけでなく、レイテンシ、メモリ、処理量、消費電力、モデルサイズを複合的に考える必要があります。そこで重要になるのが、必要な性能を維持しながら計算資源を減らす「AI効率化」です。
パラダイムシフト:AIは「大きさ」だけでは競えない
「大きければ強い」だけではなく、「必要な能力を、必要な計算資源で実現できるか」がAI設計の新たな評価軸である。
かつてAIの進化は、より多くのデータで学習し、より多くのパラメータを持つ巨大モデルを構築するという「規模の追求」によって牽引されてきました。計算能力の向上が、そのままAIの「賢さ」に結びつくという考え方です。
しかし、現実社会の多様な課題解決やビジネス展開を考えたとき、モデルの巨大化だけでは解決できない問題があります。利用環境には、応答速度、メモリ容量、消費電力、通信環境などの制約があるからです。
現在の競争は、単純なモデル巨大化だけでは説明できなくなっています。「大きければ強い」から、「必要な性能を、必要な資源で実現する」へ――AI設計の評価軸そのものが広がっているのです。
2026年の「推論」には二つの方向がある
推論時に計算を増やして「賢くする」方向と、同じ知能をより「効率よく届ける」方向は、同じ推論でも別の競争である。
ここで注意したいのが、「推論」という言葉です。近年はReasoning Modelやinference-time scalingの文脈でも「推論」が頻繁に使われるため、二つの異なる方向が混同されやすくなっています。
| 方向 | 目的 | 代表的な考え方 | 詳しく読む |
|---|---|---|---|
| より賢くする | 推論時に追加計算を使い、難しい問題を解く能力を高める | Reasoning、inference-time scaling、Test-Time Compute | AI推論革命で詳しく解説 |
| より効率よく届ける | 必要な品質を保ちながら、速度・メモリ・電力・計算量を改善する | 量子化、プルーニング、知識蒸留、効率的アーキテクチャ | 本記事の主題 |
本記事が扱うのは、主に後者です。推論時に長く考えさせることで能力を引き上げるReasoningの進化については、AI推論革命2026で詳しく解説しています。
また、推論時に入力環境へモデル自身を適応させるTest-Time Adaptation(TTA)は、単なる推論効率化とは異なるテーマです。推論と学習の境界が曖昧になるこの技術については、Test-Time Adaptation(TTA)解説を参照してください。
AI効率化の核心技術:「モデル最適化」とは?
モデル最適化とは、必要な品質をできるだけ維持しながら、サイズ・計算量・メモリ・推論時間・消費電力を改善する技術群である。
この「効率化」の要求に応える中核技術が「モデル最適化」です。モデル最適化とは、AIモデルに必要な品質をできるだけ保ちながら、モデルサイズ、計算量、メモリ使用量、推論時間、消費電力などを削減するための技術群です。
目的は単なる小型化ではありません。クラウドからエッジまで、それぞれの実行環境に適した形へAIを変換することにあります。
ここまで見てきたように、AI効率化は「モデルを軽くする技術」の品評会ではありません。実務で問われるのは、必要な品質を守りながら、いま詰まっている制約をどこから解くかです。では、自社のAIで最初に見直すべき場所はどこでしょうか。
最初に「何がボトルネックか」を決める
ここで重要なのは、最適化技術に万能薬はないという点です。モデルが大きすぎるのか、推論が遅いのか、メモリに載らないのか、電力を使いすぎるのか――課題によって選ぶべき技術は変わります。「どの技術が一番優れているか」ではなく、「何がボトルネックなのか」から考える。これがEfficient AI設計の出発点です。
| 困っていること | 主なボトルネック | 主な解決方向 |
|---|---|---|
| モデルが大きすぎる | パラメータ数・保存容量・メモリ | 量子化、プルーニング、知識蒸留 |
| 推論が遅い | 計算量・メモリアクセス | 量子化、効率的アーキテクチャ、推論ランタイム最適化 |
| 電力を使いすぎる | 演算量・データ移動 | 低精度化、モデル軽量化、専用ハードウェア |
| 端末で動かない | モデルサイズ・メモリ・消費電力 | 量子化、蒸留、プルーニング、実行場所の最適化 |
| 利用者が増えると重い | メモリ・スループット | モデル最適化、バッチング、KV CacheなどのServing最適化 |
| ※実際の効果はモデル、タスク、ハードウェア、実装方式によって異なります。複数手法を組み合わせる場合もあります。 | ||
量子化(Quantization):AIの計算をシンプルに
AIモデル内部では、非常に多くの数値を一定の精度で扱います。量子化は、FP32やFP16などの高精度な数値表現をINT8やINT4などの低精度表現へ変換し、モデルサイズ、メモリ帯域、演算負荷を減らす技術です。この仕組みは、高解像度の画像を圧縮して扱いやすくするのと似ており、少ないビット数で同じモデルの情報を表現することで、限られたハードウェアでも動かしやすくなります。
ただし、「ビット数を下げれば必ず高速になる」という単純な話ではありません。モデル構造、利用するハードウェア、Post-Training Quantization(PTQ)かQuantization-Aware Training(QAT)かといった方式によって、速度と品質のトレードオフは変わります。
Googleも、Gemma 4向けにQuantization-Aware Trainingを用いたモデルを公開しています。量子化を前提に学習することで、精度の低下を抑えながらメモリ要件を下げる、という方向の実例です。個別モデルの提供状況や価格は変動が大きいため、最新の比較は最新LLM比較をご覧ください。
NPU(Neural Processing Unit):ニューラルネットワーク処理に特化した専用プロセッサです。低精度演算などを効率的に処理できるよう設計されるケースがあります。
プルーニング/剪定(Pruning):AIモデルの「贅肉」を削ぎ落とす
大規模なAIモデルには、出力への寄与が小さい重みや構造が含まれる場合があります。プルーニングは、そのような部分を「枝刈り」のように削り、モデルをスリム化する技術です。
例えば、重要度の低い重みをゼロにすることでモデルの疎性(スパーシティ)を高めます。保存容量や計算量を削減できる可能性がありますが、実際の高速化には疎性を効率よく扱えるライブラリやハードウェアも必要です。
プルーニングの効果は、モデル、タスク、削除方法、利用するハードウェアによって大きく異なります。「何%削れるか」だけではなく、精度と実環境での推論性能を同時に測ることが重要です。なお、密なニューラルネットワークの中に、単独で学習しても元と同等の精度に達する小さな部分構造が含まれうるという「宝くじ仮説(Lottery Ticket Hypothesis)」も、プルーニング研究の重要な出発点です。
疎性(スパーシティ):モデル内の多くの数値がゼロになっている状態です。本の重要な部分だけにマーカーを引き、それ以外を読み飛ばせるようにするイメージに近く、適切な実装と組み合わせることでメモリや計算を節約できます。
知識蒸留(Knowledge Distillation):巨大AIのエッセンスを小型AIへ
知識蒸留では、まず非常に高性能だが巨大な「教師モデル」を用意します。そして、その教師モデルの出力や振る舞いをお手本として、より小型で軽量な「生徒モデル」を学習させます。
教師モデルの答えを単純な正解ラベルとして使うだけではなく、各候補に対する確率分布などを学習に利用することで、教師モデルが持つ判断のニュアンスまで小型モデルへ伝えます。
ソフトラベル:単一の正解カテゴリだけでなく、複数候補への確率値として表現されたラベルです。教師モデルの「迷い」や候補間の関係も学習材料にできます。
代表例のDistilBERTでは、BERTに対する知識蒸留によって、モデルサイズを小さくしながら高い言語理解性能を維持することが示されました。「大きなモデルの能力を、より扱いやすいモデルへ移す」という考え方は、現在の小型AI設計にもつながっています。
効率的なアーキテクチャ:最初から「燃費の良い設計」で
既存モデルを後から圧縮するだけでなく、モデルの構造そのものを、最初から推論効率が良いように設計する方法もあります。
例えば、入力に応じて必要な専門家だけを活性化するMixture-of-Experts(MoE)は、「すべてのパラメータを毎回使わない」という発想です。また、Attention機構、位置表現、メモリアクセスなどを改善し、必要な計算そのものを減らす研究も進んでいます。Googleが発表したSwitch Transformerは、MoEを大規模に適用した代表的な研究の一つです。完成後にモデルを軽くするだけでなく、最初から「必要な計算だけを行う」よう設計することも、Efficient AIの重要な方向です。
Mixture-of-Experts(MoE):入力に応じて異なる「専門家」ネットワークを選択的に利用する仕組みです。すべてのパラメータを常に計算するのではなく、必要な部分を活性化します。
Attention機構:入力データのどの部分が重要かを重み付けし、関連性の高い情報へ注意を向ける仕組みです。高い性能を支える一方、入力長や実装方法によって計算・メモリ負荷が大きくなります。
4つのモデル最適化技術を比較する
| 最適化技術 | 何を変えるか | 主に効く課題 | 注意点 | 代表的な用途 |
|---|---|---|---|---|
| 量子化 Quantization |
数値表現の精度を下げる | モデルサイズ、メモリ、演算量 | 方式によって精度低下が起こる | LLM、モバイルAI、画像認識 |
| プルーニング Pruning |
重要度の低い重み・構造を削る | モデルサイズ、計算量、メモリ | 疎性を活かせる実行環境が必要 | ニューラルネットワーク全般 |
| 知識蒸留 Knowledge Distillation |
大きな教師モデルの能力を小さなモデルへ移す | モデルサイズ、推論負荷 | 生徒モデルの再学習が必要 | 小型LLM、モバイルAI、音声認識 |
| 効率的アーキテクチャ | モデル構造そのものを効率化する | 計算量、メモリ、スループット | 設計・学習方法が複雑になる場合がある | MoE、特化モデル、大規模AI |
| ※最適化効果はモデル、データ、精度要件、ハードウェア、ランタイムによって異なります。実運用環境での計測が必要です。 | ||||
モデルだけではない:「推論システム」全体を最適化する
Efficient AIはモデル圧縮だけでは完結せず、ソフトウェア、メモリ、ランタイム、AIチップまで含めた全体設計が重要である。
量子化やプルーニングによってモデルを軽くしても、それだけで推論システム全体が必ず高速になるわけではありません。モデルをどのハードウェアで動かすか、メモリへどう配置するか、複数のリクエストをどう処理するかといった実行側の設計も重要です。AI効率化は、「モデル」「ランタイム」「メモリ」「ハードウェア」を一体として考える段階へ進んでいます。
LLMでは、KV Cache、バッチング、Prefix Cachingなど、モデルを変更せずにServing側で推論を効率化する技術も重要です。こうした実装レベルの最適化は、モデル圧縮とは別の専門領域として扱う必要があります。NVIDIAのTensorRTのように、学習済みモデルを実行環境に合わせて最適化し、高速に推論するためのライブラリもあります。
「推論」特化型AIチップが重要になる理由
量子化や疎性などモデル側の工夫を実性能へ変えるには、その計算を効率よく処理できるハードウェアとの組み合わせが欠かせない。
AIの「頭脳」であるチップも、大きな転換期を迎えています。GPUだけでなく、Google TPUをはじめとするアクセラレータや、推論性能を重視したさまざまな専用プロセッサが利用されています。スマートフォン向けでは、Qualcommのようにモバイル向けのプロセッサへAI処理用のNPUを組み込む企業もあります。
重要なのは、「どのチップが最強か」という単純な比較ではありません。低精度演算、メモリ帯域、スパーシティ、モデルサイズなど、モデル側の最適化とハードウェア側の得意領域を組み合わせることです。
AIチップの学習・推論における設計思想や、GPU、ASIC、HBM、推論原価まで含めた違いは、AIチップの「学習」と「推論」はなぜ別物なのかで詳しく整理しています。
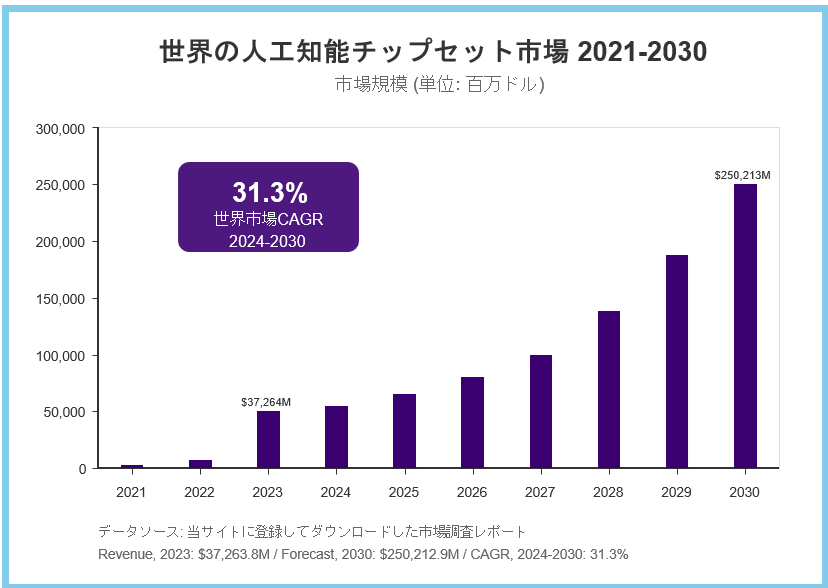 図2 世界の人工知能チップセット市場 2021-2030
図2は、AIチップ市場の拡大が予測されてきた背景を示す既存資料です。現在の企業別シェアを示す図ではなく、AI利用の拡大に伴い、学習だけでなく推論を支える計算基盤の需要が大きくなるという長期的な流れを見るための参考資料として掲載しています。
参考サイト:Grand View Research – Artificial Intelligence Chipset Market
効率化が広げるAIの実行場所――クラウドからエッジまで
AIを軽量・高速・省電力にできれば、「クラウドかエッジか」の二者択一ではなく、用途に応じて推論場所を選べるようになる。
モデル最適化によってAIを小さく、速く、省電力にできれば、AIを動かせる場所の選択肢が増えます。巨大なクラウド基盤だけでなく、PC、スマートフォン、自動車、IoT機器、ロボットなどへ推論を配置できるようになります。
エッジAIとは、データが発生する現場に近い場所でAI処理を行う考え方です。低遅延、プライバシー、オフライン動作が重要な用途では大きな価値があります。
ただし、「推論中心の時代=すべてをエッジで処理する時代」ではありません。巨大モデルや大量リクエストの処理にはクラウドやデータセンターが適する場合もあり、実際には用途ごとにクラウド、オンプレミス、PC、エッジを使い分ける必要があります。
クラウドAIとエッジAIの違い、SLM、低遅延、データ主権、ROI/TCOを含めた配置判断については、エッジAI・SLM・ROI実践ガイドで詳しく解説しています。
エッジAIの具体的な応用例
エッジAIはEfficient AIの代表的な適用先であり、低遅延・プライバシー・オフライン性が価値になる現場で特に有効である。
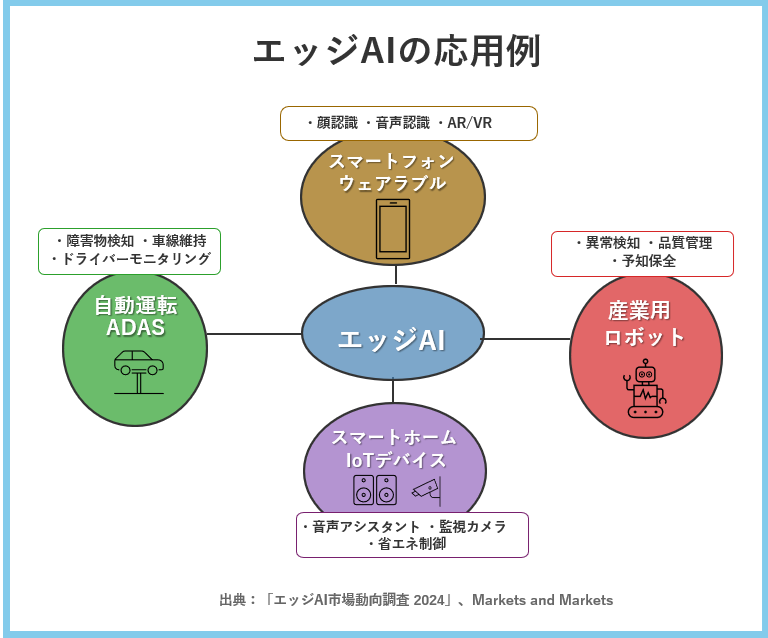
エッジAIの代表例には、スマートフォンやウェアラブル端末での顔認識・音声処理、工場での異常検知や予知保全、自動車の周辺認識、スマートホームでの映像・音声処理などがあります。
これらに共通するのは、「AIを端末で動かすこと」自体が目的なのではなく、低遅延、通信量、プライバシー、電力、オフライン性などの制約を解くために、処理場所を最適化していることです。つまり、エッジAIは「学習から推論へのパラダイムシフト」の最終到達点ではありません。Efficient AIによって選べるようになった実行場所の一つとして理解するのが適切です。
Efficient AIは「技術名」ではなく設計思想である
Efficient AIで最も重要なのは個別技術の暗記ではなく、品質と計算資源のトレードオフを用途ごとに設計することである。
量子化、プルーニング、知識蒸留、MoE――これらはどれも重要な技術ですが、Efficient AIの本質は特定の技術名にはありません。
例えば、高精度が必要な医療用途と、数百ミリ秒の遅延が問題になるロボット制御と、スマートフォン上で長時間動作させたいAIでは、「効率」の意味が異なります。
重要なのは、何を守り、何を削れるのかを決めることです。 精度を守るのか、応答速度を優先するのか、メモリを減らすのか、電力を抑えるのか。その制約を定義したうえで、最適な技術を組み合わせます。だからこそ、Efficient AIとは「小さなAI」ではなく、「目的に対して無駄の少ないAI」だと捉えると、本質が見えやすくなります。
実務ではどう判断するか
最適化技術は暗記ではなく、ボトルネックの特定・守る品質の決定・実環境での計測という3手順で選ぶべきである。
3つの手順
まず、遅いのか、メモリに載らないのか、電力を使いすぎるのかをボトルネックとして特定します。次に、精度や応答速度のうち守る品質と削ってよい資源を決めます。最後に、候補の技術を自社のモデル・データ・ハードウェアで測り、比較します。
よくある失敗
代表的なのは、ビット数だけを下げて、実行環境が対応しておらず速くならないケースです。平均の精度だけを見て、重要な少数ケースで品質が落ちていることに気づかない失敗もあります。効果は、必ず実環境で測ることが前提です。
よくある質問(Q&A)
推論、モデル最適化、エッジAIの違いを整理すると、「効率的なAI」が何を意味するのかが明確になる。
Q1.
推論(Inference)とは何ですか?
A1.
推論とは、学習済みのAIモデルへ新しい入力を与え、予測・分類・生成・判断などの結果を得る処理です。
推論はクラウドでもエッジでも行われます。用途によって、速度、品質、メモリ、スループット、電力など求められる条件が異なります。
Q2.
量子化・プルーニング・知識蒸留のどれから検討すべきですか?
A2.
技術名からではなく、ボトルネックから決めます。
既存モデルをそのまま使える量子化は、最初の候補になりやすい手法です。知識蒸留は生徒モデルの再学習が、プルーニングは疎性を活かせる実行環境が必要になります。最終判断は、自社環境での計測結果で行ってください。
Q3.
Efficient AIとエッジAIは同じですか?
A3.
同じではありません。エッジAIはEfficient AIの重要な適用先の一つです。
Efficient AIはクラウド、データセンター、PC、スマートフォン、ロボットなど、さまざまな環境で必要な性能と計算資源を最適化する考え方です。エッジAIは、その中でもデータ発生場所に近い環境で推論する形態を指します。
まとめ:効率的なAIが拓く、AI活用の新たな地平
「学習から推論へ」の本当の意味は、知能を作る競争から、その知能を社会へ効率よく届ける競争までAIの戦場が広がったことにある。
AI技術は、「大規模化による賢さの追求」という段階を経て、いま「その知能をどう効率よく使うか」という新たな課題へ向き合っています。
モデル最適化技術である量子化、プルーニング、知識蒸留、効率的アーキテクチャは、AIのサイズ、計算量、メモリ、速度、消費電力を改善するための重要な手段です。しかし、どの技術にも万能な正解はありません。
まず「何がボトルネックなのか」を特定し、守るべき品質と削減できる計算資源を決める。そのうえでモデル、ランタイム、ハードウェア、実行場所を組み合わせることが、Efficient AIの基本となります。
では、自社のAIはいま何に困っているでしょうか。モデルが大きすぎるのか、推論が遅いのか、メモリに載らないのか、電力を使いすぎるのか。その「困っていること」を起点にすれば、次に見直すべき場所と検討すべき最適化技術が見えてきます。
そして、「学習から推論へ」とは、学習の重要性が失われたという意味ではありません。これまでの競争が「どこまで賢いAIを作れるか」だったとすれば、これからは、その知能を必要な場所へ、必要な速度・品質・電力で届けられるかまでが競争になります。
そこにこそ、「効率的なAIの時代」という言葉の本当の意味があります。
参考文献 / 出典
一次情報・技術資料
- Google DeepMind – Gemma 4 with quantization-aware training
- NVIDIA Developer – TensorRT
- Jonathan Frankle, Michael Carbin – The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks
- Hugging Face – DistilBERT Documentation
- Google AI – Switch Transformers
- Qualcomm – Artificial Intelligence
市場参考資料
次に読むならこの3本
更新履歴
- 2026年10月7日:Efficient AIの定義、Reasoningとの違い、課題からの逆引き、クラウド/エッジの役割分担を整理して更新。