※本記事は継続的に最新情報へアップデートしています。
14GBが、3.5GBになる。
約70億個のパラメータを持つAIモデル。その数値をすべて16bitではなく4bitで表した場合の、重みだけの理論容量である。パラメータの数は変わらない。変えるのは数字の表し方だ。
では、数字を粗くしても、なぜAIの賢さまで同じ割合で失われるとは限らないのか。
その秘密を解き明かす技術が、量子化(Quantization)である。
✅ 先に結論
LLMの量子化とは、モデル内部の数値を少ないビット数などで表す技術です。適切な方式なら回答品質の低下を抑えながらメモリを節約できます。4bitは容量削減、8bitは誤差の抑制を重視する際の検討候補ですが、速度や品質は方式と実行環境次第です。
LLMはなぜこんなに重いのか
LLMの重さの正体は、学習によって獲得した膨大なパラメータと、それらを記憶し処理するための計算資源にある。
インターネットにつながっていないノートPCを開き、AIに質問する。文章の要約もプログラムの作成も、目の前のPCで処理してくれます。
巨大なデータセンターが支えると思っていたAIが、自分の机の上で動き始める。ローカルLLMとは、そんな技術です。
AIの頭の中には膨大な数字がある
LLM(大規模言語モデル)の膨大な学習済みパラメータ。その多くが重み(Weight)と呼ばれる数値。情報の変換や伝達を調整するダイヤルのようなものです。
7BモデルのBはBillion(10億)。70億個もの数値を、16bit(2バイト)で格納すると14GBになります。70Bなら140GB。実際には作業領域なども必要です。
そこで発想を変えてみましょう。ダイヤルの数を減らさず、一つひとつの目盛りを粗くできないだろうか。
数字を粗くしてもAIが賢い理由
量子化は数値の表現を限られた段階に置き換える技術であり、数値の誤差と回答品質の低下は必ずしも比例しない。
写真の色を減らしても、風景は残る
夕焼けの美しい写真を思い浮かべてください。空には赤、オレンジ、紫へと滑らかに変わる色が広がっています。
この写真に使える色を少し減らしてみましょう。拡大すれば違いは分かりますが、太陽や雲、山の輪郭は残り、夕焼けだと認識できるはずです。一方、極端に色を減らせば、美しい陰影まで消えてしまいます。
量子化もこれに似ています。数値の表現精度を下げることと、情報が持つ意味を失うことは同じではありません。
16bit、8bit、4bitは何が違うのか

bitはコンピュータが扱う情報量の基本単位です。4bitでは16通り、8bitでは256通りのビットパターンを区別できます。
| ビット数 | パターン数 | 1数値の理論容量 |
|---|---|---|
| 16bit | 65,536 | 2バイト |
| 8bit | 256 | 1バイト |
| 4bit | 16 | 0.5バイト |
| 2bit | 4 | 0.25バイト |
| ※パターン数は2のビット数乗。浮動小数点では特殊値や指数部などがあるため、数値の分布は整数形式と異なる。 | ||
0.7318という値を0.73や0.7に丸めても、大まかな大小関係は残ります。実際の量子化は単純な小数点以下の切り捨てではありません。
ニューラルネットワークは多くの重みの組み合わせによって情報を処理します。個々の重みに小さな誤差が生じても、全体の出力への影響が小さく済む場合があります。もちろん、わずかな誤差でも重要な判断が変わることはあります。
AIを軽くする三つの発想
| 技術 | 発想 | たとえるなら |
|---|---|---|
| 量子化 | 数値表現を少ない情報量にする | 写真集の印刷色数を減らす |
| プルーニング | 重要度の低い重みや構造を削る | 不要なページを取り除く |
| 知識蒸留 | 教師モデルの振る舞いを学習する | 専門書を参考に入門書を書く |
| ※比喩は技術の考え方を示すもの。 | ||
モデル最適化の全体像は効率的なAI(Efficient AI)の記事でも扱っています。では、数値の表し方を変えるだけで、どれほど軽くなるのでしょうか。
巨大なAIが手元のPCで動く時代
重みを低ビット化すると、限られたメモリでも利用可能なモデルの範囲が広がり、AIの実行場所の選択肢が増える。
モデルの規模とビット数による容量の違いを比較してみましょう。
| モデル規模 | 16bit | 8bit | 4bit |
|---|---|---|---|
| 7B(70億) | 14GB | 7GB | 3.5GB |
| 14B(140億) | 28GB | 14GB | 7GB |
| 32B(320億) | 64GB | 32GB | 16GB |
| 70B(700億) | 140GB | 70GB | 35GB |
| ※編集部計算:パラメータ数×ビット数÷8。1GB=10億バイト。スケール情報・高精度の層・KVキャッシュ・作業領域などは含まない。実行時の必要容量ではない。 | |||
16bit
14GB
8bit
7GB
4bit
3.5GB
例えば、16GBのメモリを搭載したPCで7Bモデルを実行したいとします。16bit版では重みだけで14GBを占めますが、4bit版なら理論上3.5GB。OSや推論エンジン、長文処理に使える余裕が大きくなります。
動作条件やPCの選び方はAI-PCは本当に必要か?も参考にしてください。
AIを利用できる場所が広がる
ローカルLLMなら外部に入力を送らず、オフラインで利用する構成も可能です。ただし外部連携やログの扱いには注意が必要です。
クラウドAIでも、少ないGPUで多くのリクエストを処理できれば運用コストを抑えられます。量子化はAIを利用できる場所を広げる技術でもあります。
では、なぜすべてのAIを4bitにしないのでしょうか。企業の契約書を読むAIが高速になっても、重要な条件を見落とすようになれば困ります。4bit版の容量も必ずしも16bit版の4分の1にはなりません。
AI内部の数値処理をのぞいてみましょう。
量子化の内部では何が起きているのか
量子化で難しいのは、計算結果を左右する数値の違いまで消さないことであり、対象の選定とスケールの設計が重要になる。
重み・活性値・KVキャッシュ
| 対象 | 役割・特徴 |
|---|---|
| 重み(W) | 学習済みパラメータ。通常の推論では固定 |
| 活性値(A) | 入力や層の計算で生まれる中間値。入力に応じて変化 |
| KVキャッシュ | Attentionで再利用するキー・バリュー。一般にトークン数などに応じて増加 |
| ※W4A16などは重み4bit・活性値16bitを意味する。すべての演算の精度を示すとは限らない。 | |
長文処理ではキャッシュのメモリも無視できません。詳しくはKVキャッシュの仕組みと最適化をご覧ください。
スケーリングと量子化誤差
−1から1までを測る定規に、限られた数の目盛りしかないとします。最も近い目盛りに丸めた際の元の値との差が、量子化誤差です。
対称な整数量子化の一例では、次のように表せます。
q = clip(round(x / s), qmin, qmax)
x′ = s × q
x:元の値、s:正のスケール係数、q:量子化整数、x′:復元値。roundは丸め、clipは範囲制限。
スケール係数は目盛りの間隔を調整するダイヤルです。ここで厄介なのが外れ値です。
一つの外れ値が目盛りを粗くする

−0.9、−0.7、−0.4、−0.2、0.1、0.3、0.6、0.8という8個の値を、−1〜1の均等な7段階で表すと、目盛り間隔は約0.33です。
ここに7.0が一つ加わり、最大絶対値に合わせて−7〜7に範囲を広げると、間隔は約2.33になります。元の8個の値はすべて0に丸められてしまいます。逆に範囲を狭く保てば、小さな値の違いは残りますが外れ値は端に切り詰められます。
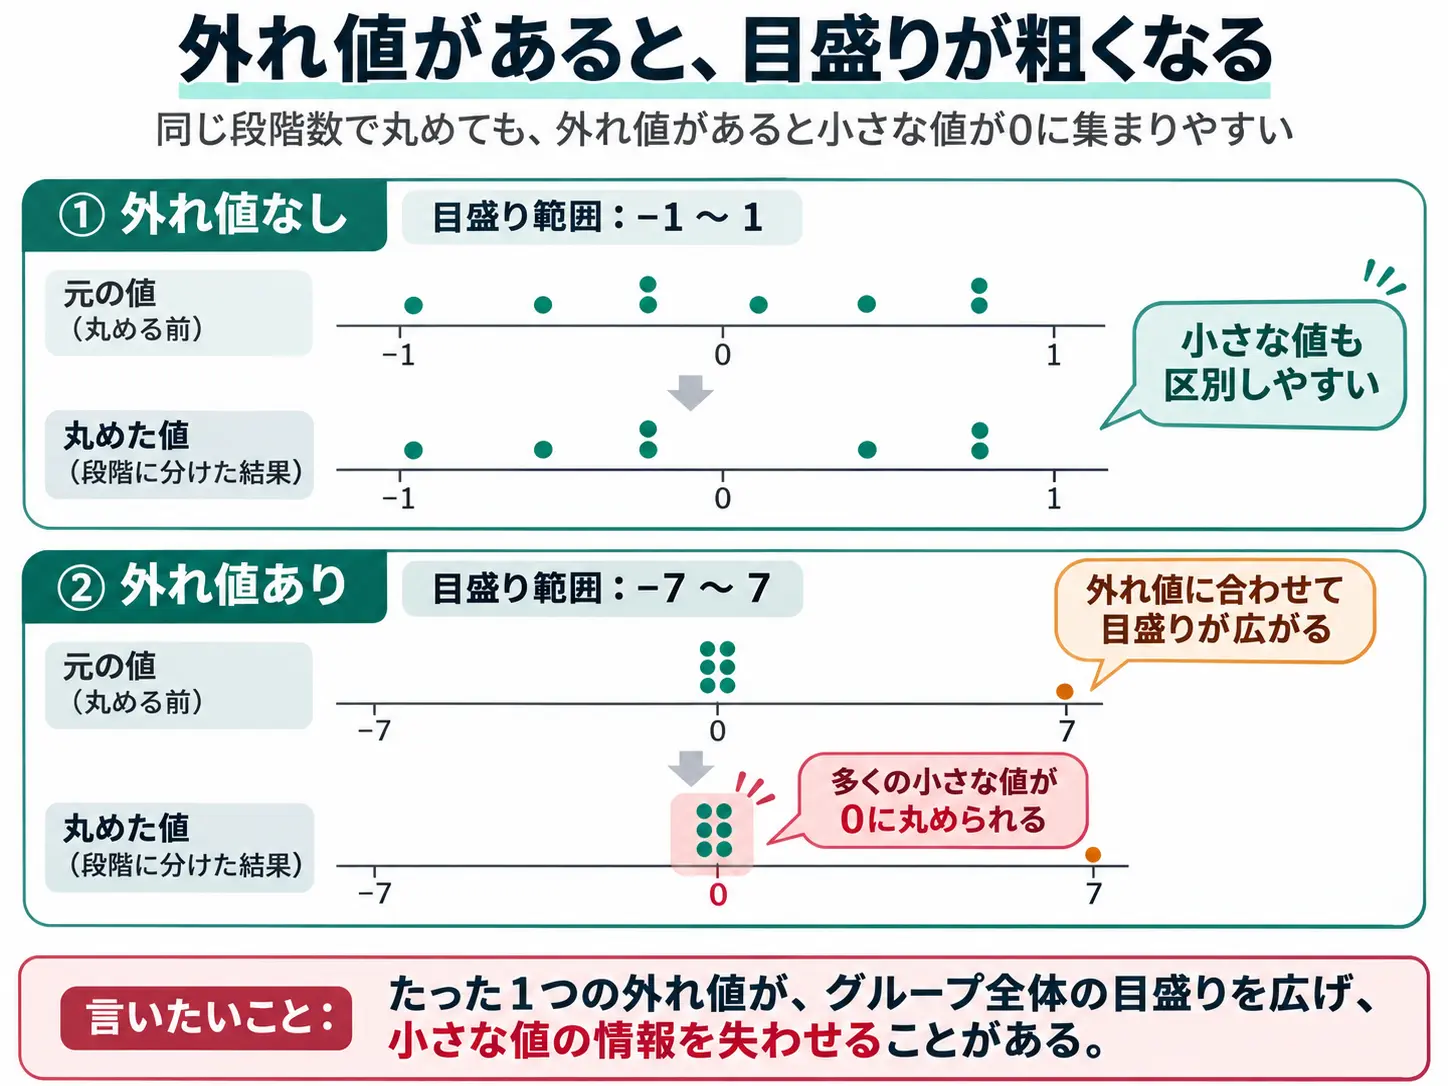
外れ値も重要な情報かもしれません。そこでグループ別にスケールを設定したり、誤差に敏感な部分を高精度で残したりします。後者が混合精度(Mixed Precision)です。細かく分けるほどスケールの管理情報も増えます。
量子化とは、どの数値の情報を守るべきかを設計する技術でもあります。研究者たちは、この設計をどう磨いてきたのでしょうか。
LLMの量子化技術はどのように進化してきたのか
学習後の量子化から誤差を考慮した学習、重要な数値の保護、低精度演算に適した数値形式まで、多様な工夫が発展してきた。
PTQ・QAT・QAD:いつ、どう学習するか
PTQ(学習後量子化)は学習済みモデルを量子化する方式。代表的な入力で数値の分布を調べるキャリブレーションなどを行います。通常、モデル全体の再学習は不要です。
QAT(量子化認識学習)は量子化誤差を学習・追加学習の段階から考慮し、低精度でも良い出力を得られるようモデルを調整します。追加の学習コストがかかりますが、品質維持に有効な場合があります。
QAD(量子化認識蒸留)では高精度モデルを教師にして、量子化を考慮した生徒モデルを学習させます。NVIDIAは2026年8月、Nemotron 3.5 Lightningの66GBのチェックポイントを22GBへ圧縮する過程で、量子化による品質低下をQADで補う事例を公表しました。
GPTQ・AWQ・SmoothQuant:何を守るのか
GPTQはPTQの一種。層の出力誤差に関する二次情報(ヘッセ行列に基づく情報)を使い、量子化した重みの誤差を残りの重みの調整で補償します。単純な丸めよりも層全体の出力を守ることに着目します。
AWQはキャリブレーション時の活性値から重要なチャネルを見つけ、等価なスケーリング変換によって重みの量子化誤差を抑えるPTQです。重要な重みを一律に高精度で保存する方式ではありません。
SmoothQuantは活性値の外れ値による量子化の難しさを、等価な数値変換で重み側へ移すPTQ。重みと活性値の双方をINT8で扱うことを目指します。性能は対象モデルや実装によります。
INT4とFP4:同じ4bitでも違う
INTは整数、FPは浮動小数点です。FPは指数部などにビットを割り当てるため、限られたビット数でも数値の分布がINTとは異なります。
| 形式 | ビット数・特徴 |
|---|---|
| FP32 | 32bit、単精度浮動小数点 |
| FP16 / BF16 | 16bit。BF16はFP32と同じ指数部の幅 |
| INT8 / INT4 | 8 / 4bit、整数とスケールなどで表現 |
| FP8 / FP4 | 8 / 4bit、低精度浮動小数点 |
| NVFP4 / MXFP4 | 4bit値とブロック共有スケール |
| ※数値本体のビット数。付加情報を含む実効ビット数とは異なる。 | |
NVIDIAのNVFP4は通常16要素ごとのFP8スケールとテンソル単位の高精度スケールを組み合わせます。MXFP4は32要素ごとの共有スケールを利用します。細かい単位で範囲を調整できることが特徴です。
Arpable独自整理:量子化技術の4層
GPTQ・GGUF・FP8は役割が異なります。四つの層で整理しましょう。
| 層 | 役割・代表例 |
|---|---|
| ① アプローチ・手法 | いつ:PTQ・QAT/具体的なPTQ手法:GPTQ・AWQ・SmoothQuant |
| ② 数値形式 | どう表すか:INT4・FP8・NVFP4・MXFP4 |
| ③ ファイル形式 | どう保存するか:GGUF・Safetensors |
| ④ 実行基盤 | どう動かすか:llama.cpp・vLLM・TensorRT-LLM |
| ※編集部による役割別の分類。各層の対応関係を確認して組み合わせる。 | |
GGUFは保存形式であり、Q4_K_MやQ8_0は量子化タイプや構成の名称です。Q4_K_Mは異なる量子化タイプを組み合わせるため、全数値が一律4bitという意味ではありません。OllamaはローカルLLMの実行・管理ツール、bitsandbytesは量子化機能を提供するライブラリです。
では、巨大モデルでの効果はどうでしょうか。
量子化は本当に速く、安くなるのか
容量削減と推論の高速化は別の問題であり、実行時の精度、メモリ帯域、演算性能、処理条件が実際の効果を左右する。
Nemotron 3 Ultra:どこを4bitにしなかったのか
舞台をデータセンターへ移しましょう。NVIDIAのNemotron 3 Ultraは約5,500億パラメータ(1トークンあたり約550億が稼働)のMoEモデルです。ノートPCではなく複数のデータセンター向けGPUで動かす規模です。
2026年6月26日の同社公表値では、BF16版1,121GBがNVFP4版352.3GBに。約68.6%減です。4bitの理論値約275GBとの差は約77GB。スケールなどの付加情報や高精度の層が関係します(正確な内訳は不明)。
| 主な構成要素 | 精度 |
|---|---|
| MoEのルーティング対象専門家 | NVFP4 |
| 共有専門家・Mambaの線形層 | FP8 |
| Attentionの線形層・埋め込み・出力層・MTP層・Latent MoE | BF16 |
| ※NVIDIA公式技術ブログの保存精度の主な例。実行時の全演算精度を示すものではない。 | |
MoEは入力に応じて専門家ネットワークを選択的に利用する構造です。ここでの発見は、どこを4bitにしたかではなく、どこを4bitにしなかったか。同社は多くのベンチマークで高精度版に近い性能を報告していますが、日本語業務での同等性を保証するものではありません。
同じチェックポイントでも、対象演算はHopperではW4A16、BlackwellではネイティブのW4A4で実行できます。KVキャッシュもFP8化されています。保存と演算の精度は別物です。
推論速度・消費電力のボトルネック
量子化でデータ転送量は減りますが、逆量子化の負荷やハードウェアの対応によっては高速化しません。
LLM推論のPrefill(入力プロンプト処理)は演算性能、Decode(回答の逐次生成)はメモリ帯域がボトルネックになりやすい傾向があります。ただし入力長や同時実行数で変わります。全体の処理量と個々の応答時間は別々に測ります。
電力やコストもビット数に単純には比例しません。AIの学習と推論の違いも参照してください。載らない、遅い、原価が高い――あなたの課題はどれでしょうか。
実務ではどの量子化方式を選ぶべきか
実務ではビット数の小ささを競うのではなく、業務で許容できる品質を満たした構成の中から速度と経済性を比較する。
4bitと8bitの使い分け
| 用途 | 最初に検討する方式 |
|---|---|
| ローカルLLM | 4bitのGGUFモデルなど |
| 品質重視の業務 | INT8・FP8などと高精度版の比較 |
| 大量リクエスト | 対応GPU上のFP8・FP4系 |
| 長文・RAG | 重みとKVキャッシュの最適化 |
| 数学・コード・AIエージェント | 高精度版を基準に業務品質を比較 |
| ※編集部の検討指針。採否は実際の業務データで判断する。 | |
重みだけの4bit化と重み・活性値の8bit化は別物です。実行基盤とハードウェアの対応も確認します。統合メモリを使うPCはRTX Sparkの記事でも扱っています。
Arpableの4軸評価

品質・速度・メモリ・コストの四つで比較します。単純平均ではなく、品質を合否判定とします。手順は課題特定→基準版評価→候補選定→同条件比較→採否判定です。
同じ元モデルで入力長、出力上限、生成設定、同時実行数、推論エンジンの版を可能な限りそろえます。日本語の業務品質、ツール引数の誤り、重要条項の抽出漏れなどの合否基準を定めます。
合格候補のTTFT(最初のトークンまでの時間)、生成速度、応答時間、ピークメモリ、原価を測ります。
安いAIが、高くつくこともある
| 評価項目 | 8bit版 | 4bit版 |
|---|---|---|
| 処理単価 | 10円 | 8円 |
| 100件の総費用 | 1,000円 | 800円 |
| 成功率・成功件数 | 95%・95件 | 70%・70件 |
| 成功1件の原価 | 10.53円 | 11.43円 |
| ※説明用の仮想値。実測ではない。再試行・人的修正・失敗損失は含まない。 | ||
成功1件の原価=総処理費用÷成功件数。4bitの処理単価が安くても、成功1件では8bitが安くなります。再試行や人的修正の費用も考慮しましょう。
推論1回の安さではなく、必要な品質の仕事を完了するための原価で判断する。これが量子化方式を選ぶうえでの経営視点です。
まとめ:AIの進化は巨大化だけではない
量子化は、モデルを賢くするだけでなく、守るべき情報を見極めてその知能を効率よく届けるという進化を象徴する技術である。
夕焼けの写真を思い出してください。色を減らしても美しい夕焼けは残ります。しかし減らしすぎれば、その美しさは失われます。
巨大なデータセンターの技術が、机の上のPCへと近づいてくる。その進化の裏には、何を削り、何を守るのかという技術者の判断があります。
あなたの仕事で、絶対に守りたいAIの「賢さ」は何でしょうか。その答えが、量子化方式を選ぶ出発点になります。
専門用語まとめ
本記事に登場した数値表現や推論性能に関する用語を、実務での利用場面と結びつけて整理する。
- キャリブレーション
- 代表的な入力などから量子化用の設定を決める処理。
- VRAM
- GPUが使用するメモリ。
- スループット
- 単位時間あたりの処理量。
参考文献 / 出典
原著論文と公式技術資料を基に、量子化の原理、代表的な手法、混合精度の事例を整理している。
一次情報
- GPTQ(原著論文)
- AWQ(原著論文)
- SmoothQuant(原著論文)
- NVIDIA:Nemotron 3 Ultra NVFP4(2026年6月26日)
- NVIDIA:Nemotron 3.5 Lightning NVFP4 with QAD(2026年8月17日)
- NVIDIA Transformer Engine:NVFP4
- NVIDIA:NVFP4とMXFP4
- Hugging Face:Quantization Overview
- llama.cpp:量子化の公式資料
理論値と4層・4軸は編集部の整理。Nemotronは開発元公表値(独立測定ではない)。
次に読むならこの3本
量子化からモデル最適化、推論基盤、エッジAIへ視野を広げることで、実行環境全体を設計する知識につながる。
補足Q&A
量子化と量子コンピュータの違い、低ビット化の制約、モデルの利用条件に関する疑問を補足する。
Q1. AIの量子化と量子コンピュータは関係がありますか?
A1. 本記事の量子化は量子コンピュータを必要としません。
一般的なCPUやGPUなどでも利用される数値変換技術です。
Q2. LLMの量子化のデメリットは?
A2. 回答品質の低下や期待した高速化が得られない可能性があります。
量子化前のモデルを基準に、用途に即した評価が必要です。
Q3. ChatGPTなどのクラウドAIを自分で量子化できますか?
A3. 通常、利用者はサービス内部のモデルを直接量子化できません。
重みへアクセスでき、必要な操作がライセンスで許されるモデルを使います。ローカルLLMの商用利用チェックリストも参照してください。
更新履歴
- 2026年11月19日:初稿アップ。